

Prvním krokem při práci s novým souborem dat je jej pochopit. Abychom toho dosáhli, je například třeba zjistit intervaly hodnot, které proměnné nabývají, jejich typy a také zjistit počet chybějících hodnot.
Knihovna pandas nám poskytuje řadu užitečných nástrojů pro provádění explorativní analýzy dat (Exploratory Data Analysis, EDA). Než však začneme používat tyto nástroje, je obvykle potřeba začít s funkcemi obecnějšího charakteru, jako je df.describe(). Je však třeba poznamenat, že možnosti, které tyto funkce nabízejí, jsou omezené a počáteční fáze práce s jakýmkoli datovým souborem při provádění EDA se velmi často podobají.
Autor materiálu, který dnes publikujeme, říká, že nemá rád vykonávání opakujících se úkolů. V důsledku toho, ve snaze najít nástroje, které by mu umožnily rychle a efektivně provádět explorativní analýzu dat, našel knihovnu . Výsledky jejího použití nejsou vyjádřeny jako jednotlivé ukazatele, ale jako podrobná HTML zpráva, která obsahuje většinu informací o analyzovaných datech, které je třeba znát předtím, než začneme s podrobnější prací s nimi.
Budou zde prozkoumány specifika použití knihovny pandas-profiling na příkladu datového souboru Titanic.
Explorativní analýza dat pomocí pandas
Rozhodl jsem se experimentovat s pandas-profiling na datovém souboru Titanic, protože obsahuje data různých typů a také obsahuje chybějící hodnoty. Považuji knihovnu pandas-profiling za zvlášť zajímavou v případech, kdy data ještě nejsou vyčištěna a vyžadují další zpracování v závislosti na jejich vlastnostech. Abychom úspěšně provedli takové zpracování, je potřeba vědět, odkud začít a na co se zaměřit. Zde nám přijdou vhod možnosti pandas-profiling.
Nejprve importujeme data a použijeme pandas k získání ukazatelů popisné statistiky:
# импорт необходимых пакетов
import pandas as pd
import pandas_profiling
import numpy as np

# импорт данных
df = pd.read_csv('/Users/lukas/Downloads/titanic/train.csv')

# вычисление показателей описательной статистики
df.describe()
Po provedení tohoto úryvku kódu získáme to, co je ukázáno na následujícím obrázku.
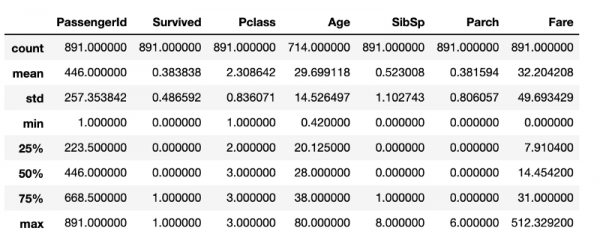
Ukazatele popisné statistiky získané pomocí standardních nástrojů pandas.
I když zde je spousta užitečných informací, nenajdete zde všechno, co by vás mohlo zajímat o zkoumaných datech. Například můžete předpokládat, že ve datovém rámci je 891 řádků. DataFramePokud to potřebujete ověřit, bude zapotřebí ještě jeden řádek kódu, který určí velikost rámce. Ačkoli tyto výpočty nejsou příliš náročné na zdroje, jejich neustálé opakování určitě povede ke ztrátě času, který by pravděpodobně bylo lepší strávit úklidem dat.
Průzkumná analýza dat pomocí pandas-profiling
Nyní uděláme totéž pomocí pandas-profiling:
pandas_profiling.ProfileReport(df)Provedení výše uvedeného řádku kódu vytvoří zprávu s ukazateli průzkumné analýzy dat. Kód uvedený výše povede k výstupu zjištěných informací o datech, ale lze to upravit tak, aby výsledkem byl HTML soubor, který lze např. někomu ukázat.
První část zprávy bude obsahovat sekci Přehled, která poskytne základní informace o datech (počet pozorování, počet proměnných atd.). Dále bude obsahovat seznam varování, který analytika informuje o tom, čemu je dobré věnovat zvláštní pozornost. Tato varování mohou sloužit jako nápověda, na co se zaměřit při úklidu dat.
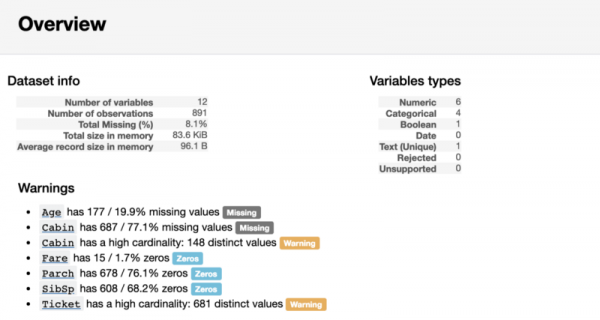
Sekce zprávy Přehled
Průzkumná analýza proměnných
Za sekcí Přehled ve zprávě lze nalézt užitečné informace o každé proměnné. Patří sem mimo jiné malé diagramy popisující rozložení každé proměnné.
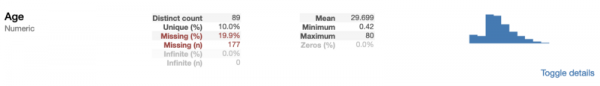
Informace o číselné proměnné Věk
Jak je vidět z předchozího příkladu, pandas-profiling nám dává několik užitečných ukazatelů, jako je procento a počet chybějících hodnot, stejně jako ukazatele popisné statistiky, které jsme již viděli. Jelikož Věk je číselná proměnná, vizualizace jejího rozložení ve formě histogramu nám umožňuje vyvodit závěr, že máme co do činění s pravostranně zkoseným rozložením.
Při zkoumání kategorické proměnné se vykazované ukazatele mírně liší od těch, které byly nalezeny pro číselnou proměnnou.
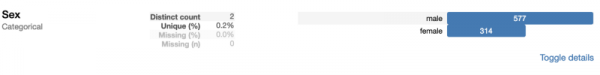
Informace o kategorické proměnné Pohlaví
Konkrétně, místo vyhledávání průměru, minima a maxima, knihovna pandas-profiling našla počet tříd. Protože Pohlaví — binární proměnná, její hodnoty jsou reprezentovány dvěma třídami.
Pokud máte rádi prozkoumávání kódu, mohlo by vás zajímat, jak přesně knihovna pandas-profiling tyto ukazatele vypočítává. Zjistit to, s přihlédnutím k tomu, že kód knihovny je otevřený a dostupný na GitHubu, není nijak složité. Protože nejsem velkým fanouškem používání 'černých skříní' ve svých projektech, podíval jsem se na zdrojový kód knihovny. Například takto vypadá mechanismus zpracování číselných proměnných, který představuje funkce :
def describe_numeric_1d(series, **kwargs):
    """Vypočítejte souhrnné statistiky číselné (`TYPE_NUM`) proměnné (Series).
    Také vytvořte histogramy (mini a full) její distribuce.
    Parametry
    ----------
    series : Series
        Proměnná k popisu.
    Vrací
    -------
    Series
        Popis proměnné jako Series s indexem jako klíče statistik.
    """
    # Naformátujte číslo jako procento. Například 0.25 bude převedeno na 25%.
    _percentile_format = "{:.0%}"
    stats = dict()
    stats['type'] = base.TYPE_NUM
    stats['mean'] = series.mean()
    stats['std'] = series.std()
    stats['variance'] = series.var()
    stats['min'] = series.min()
    stats['max'] = series.max()
    stats['range'] = stats['max'] - stats['min']
    # Abychom se vyhnuli výpočtům několikrát
    _series_no_na = series.dropna()
    for percentile in np.array([0.05, 0.25, 0.5, 0.75, 0.95]):
        # dropna() je workaround pro https://github.com/pydata/pandas/issues/13098
        stats[_percentile_format.format(percentile)] = _series_no_na.quantile(percentile)
    stats['iqr'] = stats['75%'] - stats['25%']
    stats['kurtosis'] = series.kurt()
    stats['skewness'] = series.skew()
    stats['sum'] = series.sum()
    stats['mad'] = series.mad()
    stats['cv'] = stats['std'] / stats['mean'] if stats['mean'] else np.NaN
    stats['n_zeros'] = (len(series) - np.count_nonzero(series))
    stats['p_zeros'] = stats['n_zeros'] * 1.0 / len(series)
    # Histogramy
    stats['histogram'] = histogram(series, **kwargs)
    stats['mini_histogram'] = mini_histogram(series, **kwargs)
    return pd.Series(stats, name=series.name)
I když se tento fragment kódu může zdát docela velký a složitý, ve skutečnosti je velmi snadné ho pochopit. Jde o to, že ve zdrojovém kódu knihovny je funkce, která určuje typy proměnných. Pokud se ukáže, že knihovna narazila na číselnou proměnnou, výše uvedená funkce najde ukazatele, které jsme zkoumali. V této funkci se používají standardní operace pandas pro práci s objekty typu Series, podobně jako series.mean(). Výsledky výpočtů se ukládají ve slovníku stats. Histogramy se vytvářejí pomocí upravené verze funkce matplotlib.pyplot.hist. Adaptace se zaměřuje na to, aby funkce mohla pracovat s různými typy datových sad.
Korelační koeficienty a vzorek zkoumaných dat
Po analýze proměnných pomocí pandas-profiling v části Korelace se zobrazí korelační matice Pearsonova a Spearmanova.
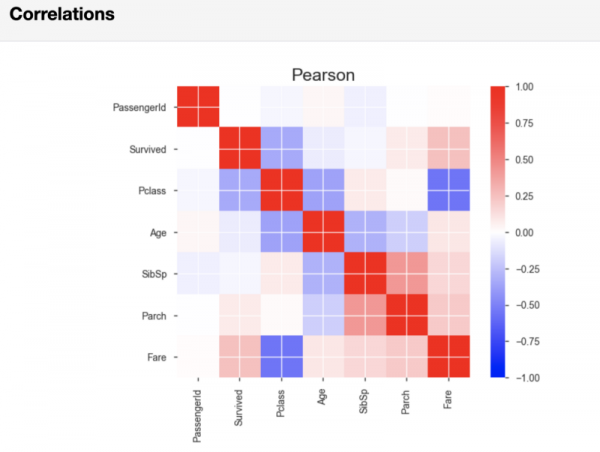
Korelační matice Pearsonova
Pokud je to nutné, můžete v řádku kódu, který spouští generování zprávy, nastavit prahové hodnoty používané při výpočtu korelace. Tímto způsobem můžete určit, jaká síla korelace se považuje za významnou pro vaši analýzu.
A nakonec, ve zprávě pandas-profiling v části Vzorek se zobrazí příklad vzorku dat, který je odebrán na začátku datové sady. Tento přístup může vést k nepříjemným překvapením, protože prvních několik pozorování může tvořit vzorek, který neodráží charakteristiky celé datové sady.
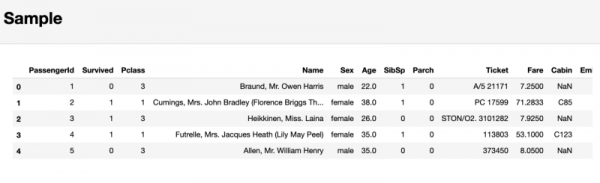
Část obsahující vzorek zkoumaných dat
Výsledkem je, že nedoporučuji věnovat pozornost této poslední části. Místo toho je lepší použít příkaz df.sample(5), který náhodně vybere 5 pozorování z datové sady.
Závěry
Závěrem lze říct, že knihovna pandas-profiling nabízí analytikovi užitečné možnosti, které se hodí v případech, kdy je třeba rychle získat obecný přehled o datech nebo předat někomu zprávu o průzkumné analýze dat. V tomto případě se skutečná práce s daty, zohledňující jejich charakteristiky, provádí, stejně jako bez použití pandas-profiling, ručně.
Pokud chcete vidět, jak vypadá celá průzkumná analýza dat v jednom Jupyter notebooku — podívejte se na můj projekt vytvořený pomocí nbviewer. A v GitHub repozitáři najdete odpovídající kód.
Vážení čtenáři! Kde začínáte analýzu nových datových sad?
Zdroj: habr.com
