

Hej alle.
Jeg er en Linux-systemadministrator, der flyttede fra Rusland til Australien på et selvstændigt erhvervsvisum i 2015, men denne artikel handler ikke om, hvordan en lille gris får en traktor. Der er allerede mange sådanne artikler (men hvis der er interesse, vil jeg også skrive om det), så jeg vil gerne fortælle om, hvordan jeg i mit job i Australien som Linux-ops-ingeniør var initiativtager til at migrere fra et overvågningssystem til et andet. Specifikt – fra Nagios til Icinga2.
Artiklen er delvist teknisk og delvist om kommunikation med mennesker og de problemer, der er forbundet med forskelle i kultur og arbejdsmetoder.
Desværre fremhæver tagget «code» ikke Puppet- og yaml-kode, så jeg måtte bruge «plaintext».
Intet forudsagde problemer den 21. december 2016. Jeg læste som sædvanligt Habr som en uregistreret anonym bruger i de første halve timer af arbejdsdagen, mens jeg indtog kaffe og stødte på .
Da min virksomhed netop benyttede Nagios, oprettede jeg uden tøven en ticket i Redmine og delte linket i den fælles chat, da jeg anså dette for vigtigt. Initiativ belønnes ikke altid, selv i Australien, så den førende ingeniør pålagde mig ansvaret, da jeg havde opdaget problemet.
Screenshot fra Redmine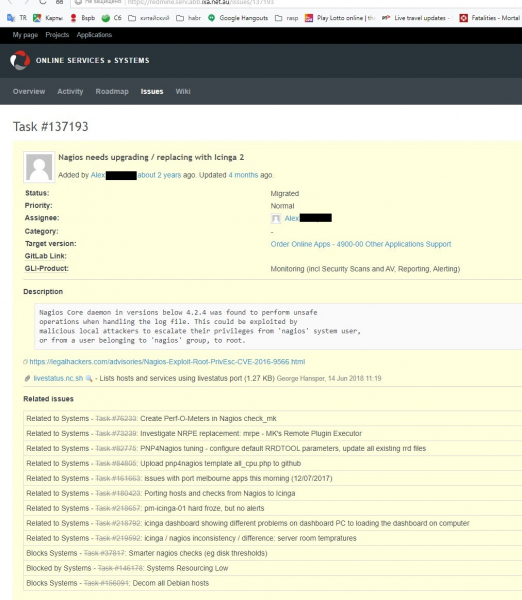
I vores afdeling er det kutyme at foreslå mindst ét alternativ, selv når valget er åbenlyst, så jeg begyndte at Google, hvilke overvågningssystemer der er aktuelle i øjeblikket, da jeg i Rusland på min tidligere arbejdsplads havde mit eget skræddersyede system, meget primitivt, men alligevel fuldt funktionsdygtigt og i stand til at udføre alle de opgaver, der blev stillet. Python, St. Petersborg Politeknisk Universitet og metroen er det bedste. Nej, metroen er en katastrofe. Dette er personligt (11 års erfaring) og fortjener en separat artikel, men ikke nu.
Lidt om reglerne for ændringer af konfigurationer i infrastrukturen på min nuværende arbejdsplads. Vi bruger Puppet, GitLab og princippet om Infrastructure as Code, så:
- Ingen manuelle ændringer via SSH ved at ændre nogen filer på de virtuelle maskiner. I løbet af tre års arbejde har jeg fået reprimander for dette mange gange, den seneste for en uge siden, og jeg tror ikke, det var den sidste gang. Altså — at rette én linje i konfigurationen, genstarte tjenesten og se om problemet er løst — tager 10 sekunder. At oprette en ny gren i Gitlab, pushe ændringerne, vente på at r10k kører på Puppetmaster, starte Puppet —environment=mybranch og vente et par minutter, mens det hele arbejder — tager mindst 5 minutter.
- Enhver ændring foretages ved at oprette en Merge Request i Gitlab, og det er nødvendigt at få godkendelse fra mindst ét medlem af teamet. Alvorlige ændringer kræver to eller tre godkendelser fra teamlederen.
- Alle ændringer er på en eller anden måde tekstbaserede (da Puppet-manifester, scripts og Hiera-data er tekst), binære filer anbefales stærkt ikke, og der skal være væsentlige grunde til at godkende sådanne filer.
Så, de muligheder jeg overvejede:
- Munin — hvis der er mere end 10 servere i infrastrukturen, bliver administrationen til et mareridt (ifølge... . Jeg havde ikke bestemt lyst til at tjekke dette, så jeg stolede på ordet).
- Zabbix — havde jeg kigget på længe, også i Rusland, men dengang var det for omfattende til mine opgaver. Her — måtte jeg opgive det, da jeg bruger Puppet som konfigurationsmanager og Gitlab som versionskontrolsystem. På det tidspunkt, så vidt jeg forstod — Zabbix opbevarer al konfiguration i en database, hvilket gjorde det uklart, hvordan man skulle styre konfigurationen under de nuværende forhold og hvordan man skulle spore ændringer.
- Prometheus — det vi til sidst vil ende op med, vurderet ud fra stemningen i afdelingen, men på det tidspunkt kunne jeg ikke håndtere det og kunne ikke præsentere en korrekt fungerende prøve (Proof of Concept), så jeg måtte opgive det.
- Der var også et par andre muligheder, som enten krævede en total ombygning af systemet, eller som var i en tidlig fase / blev forladt og af samme grund blev afvist.
I sidste ende valgte jeg Icinga2 af tre grunde:
1 — kompatibilitet med Nrpe (klienttjenesten, der udfører kontroller baseret på kommandoer fra Nagios). Dette var meget vigtigt, fordi vi på det tidspunkt havde 135 (nu i 2019 er der 165) virtuelle maskiner med en masse hjemmelavede tjenester/kontroller, og at skulle genopbygge alt dette ville være en kæmpe hovedpine.
2 — alle konfigurationsfiler er tekstfiler, hvilket gør det nemt at redigere dem og at oprette merge requests, så man kan se, hvad der er tilføjet eller fjernet.
3 — dette er et livligt og voksende OpenSource projekt. Vi elsker OpenSource og bidrager, hvor vi kan, ved at lave Pull Requests og Issues for at løse problemer.
Så lad os komme i gang, Icinga2.
Det første, jeg måtte konfrontere, var passiviteten hos kollegerne. Alle var vant til Nagios/Nadgios (selv her kunne vi ikke komme til enighed om, hvordan det skulle udtales) og brugerfladen i CheckMK. Icinga's brugerflade ser helt anderledes ud (det var et minus), men der er mulighed for fleksibelt at konfigurere, hvad man vil se ved hjælp af filtre på stort set ethvert parameter (det var et plus, men jeg kæmpede meget for det).
Filtre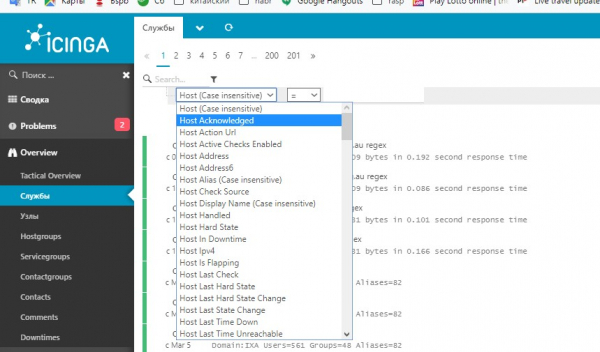
Vurder forholdet mellem størrelsen på scrollbaren og størrelsen på scrollfeltet.
For det andet — alle var vant til at se hele infrastrukturen på en skærm, fordi CheckMk tillader at arbejde med flere Nagios-værter, men Icingas brugerflade kunne ikke gøre det (faktisk kunne den, men mere om det nedenfor). Alternativet var noget kaldet Thruk, men designet gav anledning til opkastningsfølelser hos alle medlemmer af teamet, bortset fra én — den der foreslog det (ikke mig).
Thruk i skraldespanden — teamets enstemmige beslutning.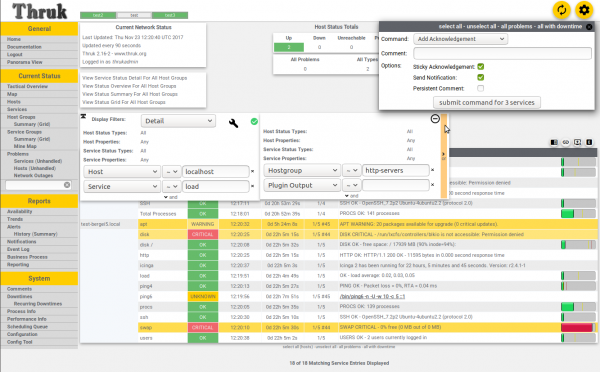
Efter et par dages brainstorming foreslog jeg en idé om klyngemonitorering, hvor der var en master-host i produktionsområdet og to underordnede - en i dev/test og en ekstern host, placeret hos en anden udbyder for at overvåge vores tjenester set fra en kundes eller en udefrakommende observatørs synspunkt. Denne konfiguration gjorde det muligt at se alle problemer i én webgrænseflade og fungerede fint, men Puppet... Problemet med Puppet var, at master-host nu skulle vide om alle hosts og tjenester/tjek i systemet og skulle fordele dem mellem zonerne (dev-test, staging-prod, ekstern), men at sende ændringer via Icinga API tager et par sekunder, mens kompileringen af Puppet-kataloget for alle tjenester til alle hosts tager et par minutter. Det er stadig noget, jeg bliver kritiseret for, selvom jeg flere gange har forklaret, hvordan det hele fungerer, og hvorfor det tager så lang tid.
Tredje - en masse SnowFlakes (snestjerner) - elementer, der falder uden for det almindelige system, fordi de har noget særligt, og derfor gælder de generelle regler ikke for dem. Det blev løst med en frontal tilgang - hvis der er alarmer, men alt i virkeligheden er i orden, så skal man dykke dybere for at finde ud af, hvorfor det alarmerer, når det ikke skulle. Eller omvendt - hvorfor Nagios panikker, mens Icinga ikke gør.
Fjerde - Nagios havde været her før mig i tre år, og der var fra starten mere tillid til det end til mit moderne hipster-system, så hver gang Icinga løftede alarmen - gjorde ingen noget, før Nagios reagerede over det samme spørgsmål. Men meget sjældent gav Icinga reelle alarmer før Nagios, og jeg betragter det som en alvorlig fejl, som jeg vil uddybe i afsnittet 'Konklusioner'.
I sidste ende blev implementeringen forsinket med mere end 5 måneder (oprindeligt planlagt til 28. juni 2018, i virkeligheden - 3. december 2018), primært på grund af 'parity check' - den situation, hvor der er flere tjenester i Nagios, som ingen har hørt om de seneste par år, men NETOP NU, de gav kritiske alarmer uden nogen grund, og jeg måtte forklare, hvorfor de ikke var på mit panel, og jeg var nødt til at tilføje dem til Icinga, for at 'parity check is complete' (Alle tjenester/tjek i Nagios svarer til tjenester/tjek i Icinga)
Implementering:
For det første er der krigen mellem Code og Data, som i Puppet Style. Alle data, faktisk alt, skal være i Hiera og ikke på nogen anden måde. Al koden skal være i .pp filer. Variabler, abstraktioner, funktioner – alt går i pp.
Resultatet er, at vi har en masse virtuelle maskiner (165 på tidspunktet for denne artikel) og 68 web-applikationer, som skal overvåges for driftssikkerhed og gyldigheden af SSL-certifikater. Men på grund af historiske problemer hentes informationen til overvågningen af applikationer fra et separat gitlab-repositorium, og dataformatet er ikke ændret siden Puppet 3, hvilket skaber yderligere udfordringer i konfigurationen.
Puppet-kode til applikationer, pas på øjnene
definer profiler::tjenester::overvågning::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # tilføjer notifikationer til standardgruppen (systemer) + enhver gruppe defineret i int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Vælg en regex til kontrol

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/ },
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Del en app op efter domæner, hvis der er to eller flere
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Gør IP-adresse til en array, hvis det ikke er, fordi askizzy har 2 IP'er og det er en array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Flet standardzonen (hvor appen er defineret) og ekstra zoner hvis de eksisterer
      $web_ipaddress.each | String $ip_address | {            # For hver IP (hvis vi har flere)
        $suffix = length($web_ipaddress) ? {                  # Hvis vi har mere end én - tilføj IP som et suffix til dette vært for at undgå at duplikere ressourcer
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # At bruge sidste oktet alene forårsager en kollision mellem nginx-vip 203.15.70.94 og ext. ip 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Hvis det er et vært for ext - bliver præfikset 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiler::tjenester::overvågning::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Kodekonfigurationen for værter og tjenester ser også frygtelig ud:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <<| |>> # vil blive aktiveret, når vi overgår helt til icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Sørg venligst for, at noden har $location-faktoren indstillet (int, pm, ext)')
    }
  }

  file { '"/etc/icinga2/conf.d/":
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet://modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <<| |>> # Dette er til rumskibsindtrængende, når det er klar.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Opdeling af siteslister efter hostgrupper - docker_host/gluster_host/etc
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Opdeling af gruppelister efter hosts
      # Er denne vært i arrayet $hosts_has_large_disks? Hvis ja, sæt host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Sammenfletning af vars separat

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Alle værter styret af API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Opdel api-værter efter zoner
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Opdeling af siteslister efter hostgrupper - docker_host/gluster_host/etc
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Opdeling af gruppelister efter hosts
          # Er denne vært i arrayet $hosts_has_large_disks? Hvis ja, sæt host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### SLUT AF VÆRTER ####

####   SERVICES   ####

  $services.each | String $service_group, Hash $s_list |{             # Service_group og liste over services i den gruppe
    $service_list = $s_list['checks']                                 # Liste over faktiske checks, adskilt fra SG-indstillinger
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # globale service standarder + servicegruppe standarder
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Hvis vi overskriver standard check_timeout, men ikke nrpe_timeout, gør nrpe_timeout den samme som check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # NB: Icinga vil automatisk konvertere 1m til 60!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Som standard bruger vi nrpe og alle kommandoer køres via nrpe. Så vars.nrpe_command = $service_name er en standardværdi
      # Hvis det er en server-side Icinga-kommando - har vi ikke brug for 'nrpe_command'
      # men der er ingen skade i at have den var og koden er kortere

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Samling af $vars fra globale standard serviceindstillinger, servicegruppeindstillinger, denne særlige checks indstillinger, og lad os ikke glemme nrpe indstillinger.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick er påkrævet alle steder, ellers bliver det "Værdien '' kan ikke konverteres til numerisk"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Tildel standardgruppe (systemer), hvis der ikke er defineret andre grupper

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Dette skal merges separat, fordi vi overskriver arrays som en del af MERGED_DATA, så vi mister nogle "assign" og "ignore" værdier

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### SLUT AF SERVICES ####

#### ANDRE KEDLIGE TING ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Sammenfletning af notifikationsindstillinger for brugere med andre indstillinger
  $users_oncall = deep_merge($users, $oncall)
  # Magi. Besøg ikke.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Jeg arbejder stadig på denne opskrift og forbedrer den, når det er muligt. Det er netop denne kode, der gør det muligt at bruge en enkel og forståelig syntaks i Hiera:
Data
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Alle kontroller er opdelt i grupper, og hver gruppe har standardindstillinger for, hvor og hvor ofte disse kontroller skal køres, hvilke meddelelser der skal sendes, og til hvem.
I hver kontrol kan man tilsidesætte enhver indstilling, og alt dette kombineres også med standardindstillingerne for alle kontroller generelt. Derfor ser config.pp sådan ud — der sker en sammensmeltning af alle standardindstillinger med gruppeer og derefter med hver enkelt kontrol.
En anden meget vigtig ændring er muligheden for at bruge funktioner i indstillingerne, for eksempel en funktion til at ændre port, adresse og url til http_regex-kontroller.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Det betyder — hvis der i værtsdefinitionen er en variabel http_port — skal den bruges, ellers 443. For eksempel hænger web-grænsefladen til jabber på 9090, mens Unifi er på 7443.
http_vhost betyder at ignorere DNS og tage denne adresse.
Hvis der i værten er angivet en uri — så skal den følges, ellers bruges "\/".
Der er en sjov historie om http_ssl — denne krydsede ville simpelthen ikke slukkes efter anmodning. Jeg sad længe fast i denne linje, indtil det gik op for mig, at i variablen i værtsdefinitionen:
http_ssl: falseIndsættes i udtrykket
if(host.vars.http_ssl) { return false } else { return true }hvordan false og resultatet bliver
if(false) { return false } else { return true }det vil sige, at ssl-kontrollen altid er aktiv. Det blev løst ved at ændre syntaksen:
http_ssl: noKonklusioner:
Fordele:
- Vi har nu ét overvågningssystem, og ikke to som i de sidste 7-8 måneder, eller ét, gammelt og sårbart.
- Datastrukturen for værter/tjenester (kontroller) er nu (efter min mening) meget mere læsbar og forståelig. For andre var det ikke så indlysende, så det var nødvendigt at oprette et par sider i den lokale wiki for at forklare, hvordan det hele fungerer, og hvad der skal rettes.
- Der er mulighed for fleksibel konfiguration af kontroller gennem variable og funktioner, for eksempel til http_regexp kan det ønskede mønster, statuskode, URL og port angives i værtsindstillingerne.
- Der er flere dashboards, hvor der kan defineres en liste over de viste alarmer, og det hele kan styres via Puppet og merge requests.
Ulemper:
- Inaktivitet fra teammedlemmerne – Nagios arbejdede, arbejdede og arbejdede, mens din Icinga konstant har problemer og går langsomt. Og hvordan ser man historikken? Åh, vent, den bliver ikke opdateret… (Reelt problem – alarmhistorikken opdateres ikke automatisk, kun med F5)
- Systeminaktivitet – når jeg klikker på "opdater" (check now) i webgrænsefladen, afhænger resultatet af vejret på Mars, især på komplekse tjenester, som tager ti sekunder at udføre. Et sådant resultat er normalt.

- Over det halve år med at arbejde med to systemer side om side har Nagios altid været hurtigere end Icinga, hvilket virkelig irriterede mig. Jeg synes, de har rodet med timerne, og kontrollen hvert femte minut går faktisk hver 5:30 eller sådan noget.
- Hvis man genstarter tjenesten på ethvert tidspunkt (systemctl restart icinga2) – alle kontroller, der var under udførelse på det tidspunkt, vil vise alarmen critical <terminated by signal 15> på skærmen, og fra omverdenen ser det ud som om, at alt er faldet sammen ().
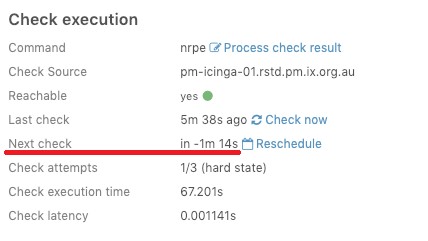
Men generelt – det fungerer.
Kilde: habr.com
