

Forord
Der findes et simpelt og meget nyttigt værktøj - , og det viser sig, at det har været en del af vores produktionsproces i meget lang tid (selv om jeg ikke kunne installere en version, var det helt sikkert ikke den seneste tilgængelige). Vi bruger det til dets primære formål - at opbygge binære patches. Når man ser på, hvad der er i depotet, bliver man lidt trist: det er i bund og grund blevet forkastet for længe siden, og meget af det er stærkt forældet (engang lavede min tidligere kollega nogle ændringer der, men det var for længe siden). Generelt besluttede jeg at genoplive dette: jeg forkede, fjernede det, jeg ikke planlægger at bruge, og flyttede projektet til , inline-de 'hot' mikrofunktioner, fjernede store arrays fra stacken (og variable længde arrays, som tydeligt gør mig irriteret), og kørte profilen igen - og fandt ud af, at omkring 40% af tiden blev brugt på …
Hvad så med fwrite?
I denne kode kaldes fwrite (i mit specifikke testtilfælde: opbygning af en patch mellem to nærtstående 300 MB filer, inddata helt i hukommelsen) millioner af gange med en lille buffer. Det er åbenlyst, at denne ting vil være en flaskehals, og derfor ønsker man at påvirke dette uden at skulle implementere forskellige datakilder eller asynkron I/O lige nu; man ville finde en enklere løsning. Det første, der kom i tankerne - at øge bufferstørrelsen
setvbuf(file, nullptr, _IOFBF, 64* 1024)men jeg fik ikke væsentlige forbedringer (nu tog fwrite omkring 37% af tiden) - så sagen er ikke, at data skrives hyppigt til disken. Hvis man ser 'under motorhjelmen' af fwrite, kan man se, at der inde bagved sker lock/unlock af FILE strukturen omtrent sådan her (pseudo-kode, hele analysen blev udført under Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Hvis man tror på profilen, tager _fwrite_nolock kun 6% af tiden, det resterende er overhead. I mit specifikke tilfælde er tråd-sikkerhed en åbenlys overflødighed, som jeg vil ofre ved at erstatte kaldet til fwrite med — man skal ikke gøre det kompliceret, selv ikke med argumenter. Resultatet: denne simple manipulation har reduceret omkostningerne til at skrive resultaterne med flere gange, som i den oprindelige version udgjorde næsten halvdelen af tidsforbruget. For øvrigt findes der en tilsvarende funktion i POSIX-verdenen — . Generelt set gælder det samme for fread. På denne måde kan man med et par #define få en ret så platform-uafhængig løsning uden unødvendige blokeringer i tilfælde, hvor de ikke er nødvendige (og det er ofte tilfældet).
fwrite, _fwrite_nolock, setvbuf
Lad os abstrahere fra det oprindelige projekt og fokusere på at teste et specifikt tilfælde: skrivning af en stor fil (512 Mb) i ekstremt små portioner — 1 byte. Testsystem: AMD Ryzen 7 1700, 16 Gb RAM, HDD 7200 rpm med 64 Mb cache, Windows 10 1809, binæret blev bygget som 32-bit, optimeringer aktiveret, biblioteket blev statisk linket.
Prøve til eksperimentet:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Som variabler vil TEST_BUFFER_SIZE blive anvendt, og i et par tilfælde vil vi erstatte fwrite_unlocked med fwrite. Lad os begynde med tilfælde fwrite uden eksplicit at angive bufferstørrelsen (vi kommenterer setvbuf og den relaterede kode): tid 27048906 µs, skrivehastighed — 18.93 Mb/s. Nu sætter vi bufferstørrelsen til 64 Kb: tid — 25037111 µs, hastighed — 20.44 Mb/s. Lad os nu teste _fwrite_nolock uden at kalde setvbuf: 7262221 µs, hastighed — 70.5 Mb/s!
Lad os eksperimentere videre med bufferstørrelsen (setvbuf):
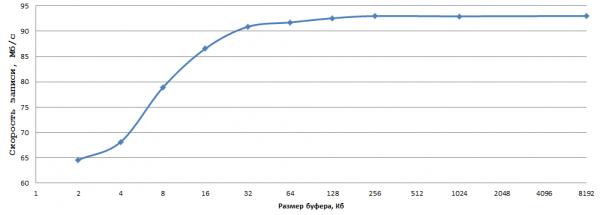
Dataene blev opnået som gennemsnit af 5 eksperimenter, jeg gad ikke at beregne fejlene. Personligt synes jeg, at 93 Mb/s ved skrivning af 1 byte på en almindelig HDD — det er et ret godt resultat, man skal blot vælge den optimale bufferstørrelse (i mit tilfælde 256 Kb — det er perfekt) og erstatte fwrite med _fwrite_nolock/fwrite_unlocked (hvis man naturligvis ikke har brug for trådsikkerhed).
Det samme gælder for fread under lignende forhold. Da jeg ikke har en "rigtig" maskine med linux ved hånden (enkortcomputerne tæller ikke), besluttede jeg at udføre et begrænset eksperiment på en virtuel maskine (Hyper-V, OpenSUSE 15, GCC 8.3.1) — mønstret er i princippet det samme: "rå" fwrite 20 Mb/s, fwrite + buffer på 256 Kb gav 23 Mb/s, fwrite_unlocked med samme buffer — 35 Mb/s (binæret 64-bit, blev bygget g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Efterord
Formålet med denne artikel var at beskrive en simpel og effektiv metode, der i mange tilfælde kan anvendes (jeg har aldrig arbejdet med funktionerne _fwrite_nolock/fwrite_unlocked, de er ikke så populære – men det burde de være). Jeg gør ikke krav på nyhedsværdien af materialet, men jeg håber, at artiklen vil være nyttig for samfundet.
Kilde: habr.com
