

TL; DR: JSONB kan betydeligt forenkle udviklingen af en database-scheme uden at gå på kompromis med ydeevnen i forespørgsler.
Introduktion
Lad os kigge på et klassisk eksempel, måske en af de ældste anvendelser i verden af relationelle databaser (database): vi har en entitet, og det er nødvendigt at gemme bestemte egenskaber (attributter) for denne entitet. Men ikke alle instanser kan have det samme sæt af egenskaber, og derudover kan det være muligt at tilføje flere egenskaber i fremtiden.
Den nemmeste måde at løse dette problem på er at oprette en kolonne i databasen for hver egenskabsværdi og blot udfylde dem, der er nødvendige for den specifikke instans af entiteten. Godt! Problemet er løst… indtil din tabel indeholder millioner af poster, og du får behov for at tilføje en ny post.
Lad os overveje EAV-mønsteret (), som forekommer ret ofte. Én tabel indeholder entiteter (poster), en anden tabel indeholder navne på egenskaber (attributter), og en tredje tabel forbinder entiteter med deres attributter og indeholder værdien af disse attributter for den aktuelle entitet. Dette giver dig mulighed for at have forskellige sæt af egenskaber for forskellige objekter og tilføje egenskaber "on the fly", uden at ændre databasen.
Ikke desto mindre ville jeg ikke skrive denne note, hvis der ikke var ulemper ved tilgangen med EAV. For eksempel kræver det at hente en eller flere entiteter, som har 1 attribut, 2 joins i forespørgslen: den første – join med attributtabelen, den anden – join med værditabellen. Hvis en entitet har 2 attributter, kræves der allerede 4 joins! Desuden opbevares alle attributter normalt som strenge, hvilket medfører typekonvertering både for resultatet og for WHERE-betingelsen. Hvis du skriver mange forespørgsler, er det ret ineffektivt i forhold til ressourcerne.
På trods af disse åbenlyse ulemper har EAV længe været brugt til at løse denne type problemer. Det var uundgåelige ulemper, og der var simpelthen ikke en bedre alternativ.
Men så kom der en ny "teknologi" i PostgreSQL...
Fra PostgreSQL 9.4 blev datatypen JSONB tilføjet for at opbevare binære JSON-data. Selvom opbevaring af JSON i dette format normalt kræver lidt mere plads og tid end almindelig tekst-JSON, så er udførelsen af operationer med det meget hurtigere. JSONB understøtter også indeksering, hvilket gør forespørgsler til det endnu hurtigere.
Datatypen JSONB giver os mulighed for at erstatte det omfangsrige EAV-mønster ved blot at tilføje én JSONB-kolonne i vores entitetstabel, hvilket i høj grad forenkler database-udformningen. Men mange hævder, at dette bør ledsages af et fald i ydeevnen... Derfor blev denne artikel til.
Opsætning af testdatabase
Til denne sammenligning har jeg oprettet en database på en ny installation af PostgreSQL 9.5 på en 80-dollars opsætning Ubuntu 14.04. Efter at have justeret nogle indstillinger i postgresql.conf, kørte jeg scriptet ved hjælp af psql. For at repræsentere data i EAV-format blev følgende tabeller oprettet:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Nedenfor er en tabel, hvor de samme data vil blive opbevaret, men med attributter i en JSONB-kolonne – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Det ser meget lettere ud, ikke? Derefter blev der tilføjet 10 millioner poster til entitetstabellerne (entity & entity_jsonb) og tilsvarende blev tabellerne, hvor EAV-mønsteret bruges, fyldt med ens data som JSONB-kolonnen – entity_jsonb.properties. På den måde fik vi flere forskellige datatyper blandt hele mængden af egenskaber. Eksempeldata:
{
  id:          1
  name:        "Entity1"
  description: "Test entity nr. 1"
  properties:  {
    color:        "red"
    lenght:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgium"
  }
}
Så nu har vi ens data til de to varianter. Lad os begynde at sammenligne implementeringerne i praksis!
Forenkling af design
Det er allerede blevet nævnt, at designet af databasen er blevet markant forenklet: én tabel, ved at bruge en JSONB-kolonne til egenskaber i stedet for at bruge tre tabeller til EAV. Men hvordan påvirker det forespørgslerne? Opdatering af en egenskab ved en entitet ser således ud:
-- EAV
UPDATE entity_attribute_value
SET value = 'blå'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blå"')
WHERE id = 120;
Som vi kan se, ser den sidste forespørgsel ikke ligefrem enklere ud. For at opdatere værdien af en egenskab i et JSONB-objekt skal vi bruge funktionen , og vi skal overføre vores nye værdien som et JSONB-objekt. Det er dog ikke nødvendigt at kende nogen identifikator på forhånd. Ved at se på EAV-eksemplet skal vi vide både entity_id og entity_attribute_id for at udføre opdateringen. Hvis du ønsker at opdatere en egenskab i JSONB-kolonnen baseret på objektnavnet, – så gøres alt dette i en simpel sætning.
Lad os nu vælge den enhed, vi lige har opdateret, efter betingelsen for dens nye farve:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blå';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blå';
Jeg tror, vi kan blive enige om, at det andet er kortere (uden join!), og dermed mere læsbart. Her vinder JSONB! Vi bruger JSON-operatoren ->>, for at hente farven som tekstværdi fra JSONB-objektet. Der er også en anden måde at opnå det samme resultat i JSONB-modellen ved hjælp af operatoren @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blå"}';
Dette er lidt mere komplekst: vi kontrollerer, om JSON-objektet i egenskabskolonnen indeholder objektet til højre for operatoren @>. Mindre læsbart, men mere effektivt (se videre).
Lad os forsimple brugen af JSONB endnu mere, når du har brug for at vælge flere egenskaber samtidigt. Det er her, JSONB-tilgangen virkelig skinner: vi vælger blot egenskaberne som ekstra kolonner i vores resultatsæt uden behov for joins:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'land'
FROM entity_jsonb
WHERE id = 120;
Med EAV skal du have 2 joins for hver egenskab, du ønsker at forespørge. Efter min mening viser ovenstående forespørgsler en betydelig forenkling i designet af databasen. Du kan også finde flere eksempler på, hvordan man skriver forespørgsler til JSONB i indlægget.
Nu er det tid til at tale om ydeevne.
Ydeevne
For at sammenligne ydeevnen har jeg brugt i forespørgsler for at beregne udførelsestid. Hver forespørgsel blev udført mindst tre gange, fordi planlæggeren kræver mere tid første gang. Først udførte jeg forespørgsler uden indekser. Det gav tydeligvis en fordel for JSONB, da de join, der er nødvendige for EAV, ikke kunne bruge indekser (feltet for fremmednøgle var ikke indekseret). Herefter oprettede jeg et indeks for to kolonner med fremmednøgler i EAV-værditabellen samt et indeks for JSONB-kolonnen.
Opdateringer af data viste følgende resultater i tid (i ms). Bemærk, at skalaen er logaritmisk:
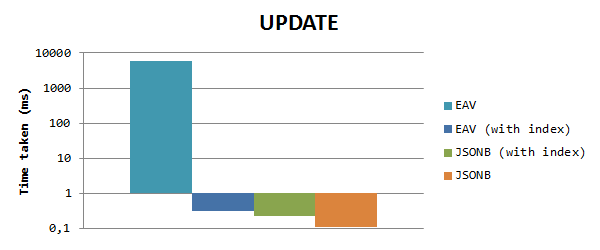
Vi ser, at JSONB er meget (> 50000-x) hurtigere end EAV, når der ikke bruges indekser, af den grund, der er nævnt ovenfor. Når vi indekserer kolonner med primære nøgler, næsten forsvinder forskellen, men JSONB er stadig 1,3 gange hurtigere end EAV. Bemærk, at indekset i JSONB-kolonnen her ikke har nogen indflydelse, da vi ikke bruger egenskabsfeltet i evalueringskriterierne.
For at vælge data baseret på egenskabsværdi får vi følgende resultater (normal skala):
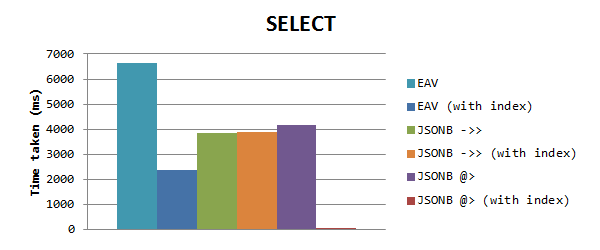
Man kan mærke, at JSONB igen fungerer hurtigere end EAV uden indekser, men når EAV har indekser, er det stadig hurtigere end JSONB. Men så så jeg, at tiden for JSONB-forespørgsler var den samme, hvilket fik mig til at indse, at GIN-indekset ikke aktiverede. Tilsyneladende, når du bruger GIN-indeks for en kolonne med udfyldte egenskaber, virker det kun ved brug af inkluderingsoperatoren @>. Jeg brugte dette i en ny test, hvilket havde en enorm indflydelse på tiden: kun 0,153 ms! Det er 15000 gange hurtigere end EAV, og 25000 gange hurtigere end operatoren ->>.
Jeg synes, det var hurtigt nok!
Størrelsen på databaserne
Lad os sammenligne størrelsen af tabellerne under begge tilgange. I psql kan vi vise størrelsen af alle tabeller og indekser med kommandoen dti+
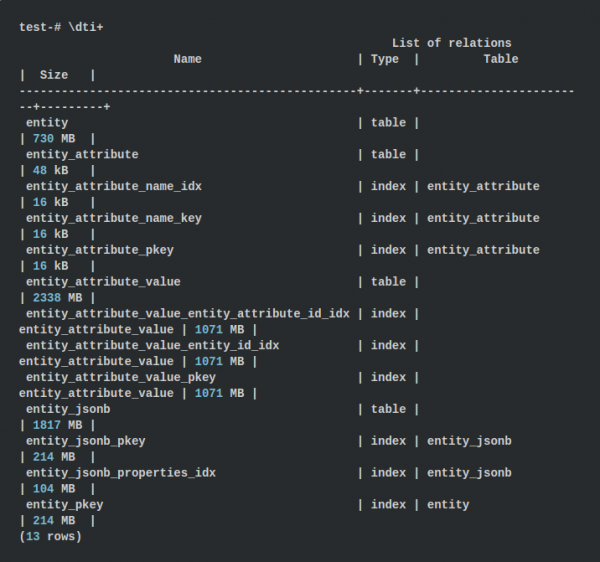
For EAV-tilgangen udgør størrelsen på tabellerne cirka 3068 MB, og indekserne op til 3427 MB, hvilket giver en samlet størrelse på 6,43 GB. Ved brug af JSONB-tilgangen bruges 1817 MB til tabellen og 318 MB til indekserne, hvilket udgør 2,08 GB. Det er tre gange mindre! Denne kendsgerning overraskede mig lidt, fordi vi gemmer egenskabsnavne i hvert JSONB-objekt.
Men tallene taler for sig selv: i EAV opbevarer vi 2 heltals udenlandske nøgler til attributværdien, hvilket resulterer i 8 bytes ekstra data. Desuden opbevares alle egenskaber i EAV som tekst, mens JSONB vil bruge numeriske og logiske værdier, hvor det er muligt, hvilket resulterer i en mindre mængde.
Resumé
Generelt mener jeg, at opbevaring af egenskaber for entiteter i JSONB-format kan forenkle design og vedligeholdelse af din database betydeligt. Hvis du udfører mange forespørgsler, vil alt, hvad der opbevares i én tabel med en entitet, virkelig fungere mere effektivt. Og det faktum, at det forenkler interaktionen mellem data allerede er en fordel, men også den resulterende database er 3 gange mindre i volumen.
Desuden, ifølge de udførte tests, kan vi konkludere, at tabet af ydeevne er meget ubetydeligt. I nogle tilfælde fungerer JSONB endda hurtigere end EAV, hvilket gør det endnu bedre. Dog dækker denne benchmarktest selvfølgelig ikke alle aspekter (for eksempel entiteter med et meget stort antal egenskaber, betydelige stigninger i antallet af eksisterende egenskaber,...), så hvis du har nogen forslag til, hvordan de kan forbedres, så tøv ikke med at skrive det i kommentarerne!
Kilde: habr.com
