

– Oh, ningún refugio resistirá el impacto de un meteoro. Pero al igual que cada uno de ustedes, tienen un respaldo, así que no se preocupen.
Stanislaw Lem, «Los diarios de las estrellas de Ijon Tichy»
La copia de seguridad se refiere a guardar una copia de los datos en algún lugar fuera de la ubicación principal de su almacenamiento.
El propósito principal de la copia de seguridad es la recuperación de datos después de su pérdida. En este sentido, a menudo se escucha que si hay una réplica de la base de datos, siempre se pueden recuperar los datos de ella, y que no se necesita la copia de seguridad. Sin embargo, la copia de seguridad permite resolver al menos tres tareas que no pueden resolverse mediante una réplica, y tampoco se puede inicializar una réplica sin una copia de seguridad.
En primer lugar, la copia de seguridad permite recuperar los datos después de un error lógico. Por ejemplo, un contable eliminó un grupo de asientos o un administrador de base de datos destruyó un espacio de tabla. Ambas operaciones son absolutamente legítimas desde el punto de vista de la base de datos, y el proceso de replicación las reproducirá en la base de datos replica.
En segundo lugar, las bases de datos modernas son sistemas de software bastante fiables, aunque ocasionalmente ocurren daños en las estructuras internas de la base de datos, después de los cuales se pierde el acceso a los datos. Lo que es especialmente molesto es que dicha violación suele ocurrir bajo alta carga o al instalar alguna actualización. Pero tanto la alta carga como las actualizaciones regulares indican que la base de datos no es de prueba, y los datos que se almacenan en ella son valiosos.
Finalmente, la tercera tarea que requiere la existencia de una copia de seguridad es la clonación de la base de datos, por ejemplo, con fines de prueba.
La copia de seguridad de bases de datos se basa de alguna manera en uno de dos principios:
- Extracción de datos seguida de su almacenamiento en un formato arbitrario;
- Instantánea del estado de los archivos de la base de datos y almacenamiento de registros.
Analicemos estos principios y las herramientas que los implementan con más detalle.
Exportación de datos
En el conjunto de utilidades que acompañan a cualquier sistema de gestión de bases de datos, siempre hay herramientas para la exportación e importación de datos. Los datos se guardan en un formato de texto o en un formato binario específico para el sistema de gestión de bases de datos en cuestión. A continuación se presenta una lista de tales herramientas:
Formato binario
Formato de texto
Oracle
DataPump Export/DataPump Import
Exportar/Importar
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
descargar/cargar
descargar/cargar
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
El formato de texto es bueno porque se puede editar o incluso crear con programas externos, mientras que el binario es útil porque permite descargar y cargar datos más rápidamente gracias a la economía de recursos en la conversión de formatos.
A pesar de la simplicidad y obviedad de la idea de exportar datos, este método se aplica raramente para la copia de seguridad de bases de datos industriales cargadas. Aquí están las razones por las cuales la exportación no es adecuada para copias de seguridad completas:
- el proceso de exportación genera una carga significativa en el sistema fuente;
- la exportación lleva mucho tiempo; para cuando se completa, ya no será relevante;
- hacer una exportación coherente de toda la base de datos bajo una alta carga es prácticamente imposible, ya que el SGBD debe mantener una instantánea de su estado en el momento en que comienza la exportación. Cuantas más transacciones se hayan realizado desde el inicio de la exportación, mayor será el tamaño de la instantánea (copias de datos no relevantes en PostgreSQL, espacio undo en Oracle, tempdb en Microsoft SQL Server, etc.);
- la exportación conserva la estructura lógica de los datos, pero no su estructura física: los parámetros de almacenamiento físico de las tablas, índices, etc.
Sin embargo, la exportación también tiene sus ventajas:
- alta selectividad: se pueden exportar tablas individuales, campos específicos e incluso filas individuales;
- los datos exportados se pueden cargar en una base de datos de otra versión, y si la exportación se realizó en formato de texto, también en otra base de datos.
Por lo tanto, la exportación se utiliza principalmente para tareas como la copia de seguridad de tablas pequeñas (por ejemplo, catálogos) o la distribución de conjuntos de datos con el próximo lanzamiento de la aplicación.
El método más común de copia de seguridad de bases de datos es la copia de archivos de la base de datos.
Copia «fría» de archivos de la base de datos
La idea obvia es detener la base de datos y copiar todos sus archivos. Esta copia de seguridad se llama «fría». Es un método extremadamente fiable y simple, pero tiene dos desventajas obvias:
- De una copia de seguridad "fría" solo se puede restaurar el estado de la base de datos que existía en el momento de la detención; las transacciones realizadas después del reinicio de la base no se incluirán en la copia de seguridad "fría".
- No todas las bases de datos tienen una ventana tecnológica en la que se pueda detener la base.
Si la copia de seguridad "fría" es aceptable para usted, debe recordar que
- La copia "fría" a veces debe incluir también los registros. Los métodos para determinar qué registros deben ir en la copia "fría" son únicos para cada SGBD. Por ejemplo, en Oracle es necesario copiar los llamados online redo, es decir, un número fijo de archivos de registro en un directorio especial, incluso cuando la base está detenida correctamente. En PostgreSQL, se deben almacenar todos los registros desde el registro que contiene el último punto de control, cuya información se encuentra en el archivo de control.
- El directorio de la base de datos puede contener archivos bastante grandes de espacios de tablas temporales que no es necesario incluir en la copia de seguridad. Por cierto, esta observación también es válida para la copia de seguridad "caliente".
La conservación de archivos "calientes"
La mayoría de las copias de seguridad de bases de datos modernas se realizan copiando archivos de la base de datos sin detenerla. Aquí se presentan varios problemas:
- En el momento de iniciar la copia, el contenido de la base de datos puede no coincidir con el contenido de los archivos, ya que parte de la información se encuentra en caché y aún no se ha escrito en el disco.
- Durante la copia, el contenido de la base puede cambiar. Si se utilizan estructuras de datos modificables, el contenido de los archivos cambia, y al usar estructuras inmutables, se cambia el conjunto de archivos: aparecen nuevos archivos y se eliminan los antiguos.
- Dado que la escritura de datos en la base y la lectura de archivos de la base no están sincronizadas, el programa de copia de seguridad puede leer una página incorrecta, donde la mitad corresponde a la versión antigua de la página, y la otra mitad a la nueva.
Para que una copia de seguridad sea coherente, cada SGBD tiene un comando que indica que ha comenzado el proceso de copia de seguridad. Sintácticamente, este comando puede variar:
- en Oracle es un comando separado ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- en PostgreSQL es la función pg_start_backup();
- En Microsoft SQL Server y DB2, la preparación para la copia de seguridad se realiza implícitamente durante la ejecución del comando BACKUP DATABASE;
- En MySQL Enterprise, Cassandra y MongoDB, la preparación se lleva a cabo implícitamente mediante utilidades externas: mysqlbackup, OpsCenter y Ops Manager, respectivamente.
A pesar de las diferencias sintácticas, el proceso de preparación para la copia de seguridad es similar.
Así es como se lleva a cabo la preparación para la copia de seguridad en sistemas de gestión de bases de datos con estructuras de disco cambiantes, es decir, en todos los sistemas relacionales tradicionales basados en disco:
- Se registra el momento de inicio de la copia de seguridad; la copia de seguridad deberá incluir los registros de la base de datos a partir de este momento.
- Se realiza un punto de control, es decir, todos los cambios que hayan ocurrido en las páginas de datos antes del momento registrado se escriben en el disco. Esto garantiza que los registros anteriores al inicio de la copia de seguridad no sean necesarios para la recuperación.
- Se activa un modo especial de registro: si una página de datos cambia por primera vez después de ser cargada desde el disco, en lugar de registrar en el log los cambios de la página, la base de datos registrará la página completa. Durante el procedimiento de preparación, todas las páginas se escriben en el disco, por lo que en el primer cambio, el bloque siempre se registrará completamente en el log. Sin embargo, si durante la copia de seguridad la página se vuelve a expulsar al disco, su siguiente cambio también resultará en la aparición de una copia completa de la página en el log. Esto garantiza que, si por alguna razón la página resulta incorrecta al copiar el archivo de datos, la aplicación del log la corregirá.
- Se bloquea el cambio de los encabezados de los archivos de datos, es decir, la parte cuyos cambios no se reflejan en los registros. Esto garantiza que el encabezado se copie correctamente y que luego se apliquen correctamente los registros al archivo de datos.
Una vez que se hayan realizado todos los procedimientos mencionados anteriormente, se pueden copiar los archivos de datos utilizando herramientas del sistema operativo como cp, rsync y otras. Activar el modo de respaldo reduce el rendimiento de la base de datos: en primer lugar, se incrementa el volumen de registros y, en segundo lugar, si hay un fallo durante el modo de respaldo, la recuperación será más prolongada, ya que los encabezados de los archivos de datos no se actualizan. Cuanto más rápido termine el respaldo, mejor será para la base de datos, por lo que aquí es apropiado usar herramientas como un snapshot del sistema de archivos o un split mirror (BCV) en el arreglo de discos. Algunos SGBD (Oracle, PostgreSQL) permiten al administrador elegir el método de copia, mientras que otros (Microsoft SQL Server) proporcionan una interfaz para integrar sus propias utilidades de respaldo con los mecanismos de sistemas de archivos o almacenamiento.
Al finalizar el respaldo, es necesario devolver la base de datos a un estado normal. En Oracle, esto se logra con el comando ALTER DATABASE/TABLESPACE END BACKUP, en PostgreSQL con la función pg_stop_backup(), y en otras bases de datos a través de subprogramas internos de los comandos correspondientes o servicios externos.
Así es como se ve el diagrama temporal del proceso de respaldo:
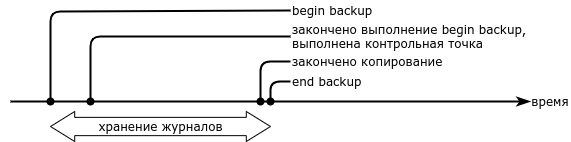
- La preparación para el respaldo (begin backup) toma tiempo, a veces considerable. Incluso si se utilizan volúmenes espejados o sistemas de archivos que permiten realizar snapshots, el proceso de respaldo no será instantáneo.
- Junto con los archivos de datos, es necesario conservar los registros desde el momento en que se comienza la preparación para el respaldo hasta que la base vuelva a su estado normal.
- Se puede restaurar a partir de este respaldo en el momento en que la base regresa a su estado normal. No es posible restaurar a un momento anterior.
Con bases de datos que utilizan estructuras de datos inmutables (snapshots en memoria, árboles LSM), la situación es más sencilla. La preparación para el respaldo consta de los siguientes pasos:
- Los datos en memoria se escriben en disco.
- Se registra la lista de archivos que entran en el respaldo. Hasta que el proceso de respaldo no finalice, no se permite a la base eliminar estos archivos, incluso si ya no son necesarios.
Tras la señal de finalización de la copia de seguridad, la base de datos con estructuras inmutables puede volver a eliminar los archivos innecesarios.
Recuperación a un punto
La copia de seguridad permite restaurar el estado de la base de datos en el momento en que se completó el comando de retorno del modo de copia de seguridad. Sin embargo, un accidente que requiera la recuperación puede ocurrir en cualquier momento. La tarea de restaurar el estado de la base de datos a un momento arbitrario se llama "recuperación a un punto" (point-in-time recovery).
Para proporcionar esta posibilidad, se deben conservar los registros de la base de datos desde el momento de finalización de la copia de seguridad, y durante el proceso de recuperación continuar aplicando los registros a la copia recuperada. Una vez que la base de datos se ha recuperado de la copia de seguridad al momento de finalización de la copia, el estado de la base (archivos y páginas almacenadas en caché) es garantizado como correcto, por lo que no se necesita un modo especial de registro. Al aplicar los registros hasta el momento deseado, se puede obtener el estado de la base de datos en cualquier momento.
Si la velocidad de recuperación de la copia de seguridad está limitada solo por el ancho de banda del disco, la velocidad de aplicación de los registros generalmente está limitada por el rendimiento del procesador. Si en la base de datos principal se producen cambios en paralelo, al restaurar todos los cambios se ejecutan secuencialmente, en el orden en que se leen del registro. Por lo tanto, el tiempo de recuperación depende de manera lineal de cuán lejos esté el punto de recuperación del punto de finalización de la copia de seguridad. Debido a esto, es necesario realizar copias de seguridad completas con bastante frecuencia, al menos una vez a la semana para bases con una carga transaccional baja y hasta copias diarias para bases de alta carga.
Copia de seguridad incremental
Para acelerar la recuperación a un punto, sería deseable poder realizar copias de seguridad con la mayor frecuencia posible, pero sin ocupar espacio adicional en los discos y sin sobrecargar la base de datos con tareas de copia de seguridad.
La solución a esta tarea es la copia de seguridad incremental, es decir, recopilar solo aquellas páginas de datos que han cambiado desde la última copia de seguridad.
La copia de seguridad incremental tiene sentido solo para bases de datos que utilizan estructuras de datos modificables.
El incremento puede contarse a partir de una copia de seguridad completa (copia acumulativa) o de cualquier copia previa (copia diferencial).
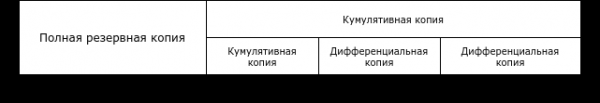
Desafortunadamente, no existe una terminología uniforme, y diferentes fabricantes utilizan diferentes términos:
Diferencial
Acumulativa
Oracle
Diferencial
Acumulativa
PostgresPro
Incremental
—
Microsoft SQL Server
—
Diferencial
IBM DB2
Delta
Incremental
Cuando hay copias incrementales, el proceso de restauración a un punto específico es el siguiente:
- se restaura la última copia de seguridad completa realizada antes del punto de restauración;
- sobre la copia completa se restauran las copias incrementales;
- se aplican los registros desde el inicio de la copia de seguridad hasta el punto de restauración.
La existencia de una copia acumulativa acelera el proceso de restauración. Por ejemplo, para restaurar el estado de la base entre T3 y T4, es necesario restaurar dos copias incrementales, mientras que para restaurar a un punto después de T4, solo se necesita una.
Es evidente que el volumen de una copia acumulativa es menor que el de varias copias diferenciales, porque algunas páginas han cambiado varias veces y cada copia incremental contiene su versión de la página.
Hay tres formas de crear una copia de seguridad incremental:
- crear una copia completa y calcular la diferencia con la copia completa anterior;
- analizar los registros, crear una lista de páginas modificadas y respaldar las páginas incluidas en la lista;
- consultar las páginas modificadas en la base de datos.
El primer método ahorra espacio en disco, pero no resuelve el problema de reducir la carga en la base de datos. Además, si tenemos una copia de seguridad completa, convertirla en incremental es inútil, ya que la restauración de la copia completa es más rápida que la restauración de la copia completa anterior y el incremento. La tarea de ahorrar espacio en disco con este enfoque es mejor dejarla a componentes especializados con mecanismos de deduplicación integrados. Estos pueden ser tanto sistemas de almacenamiento especiales (EMC DataDomain, HPE StorageWorks VLS, toda la línea de NetApp) como productos de software (ZFS, Veritas NetBackup PureFile, Windows Server Data Deduplication).
El segundo y tercer método se diferencian en el mecanismo utilizado para identificar la lista de páginas modificadas. Analizar los registros es más intensivo en recursos, y además, para llevarlo a cabo, es necesario conocer la estructura de los archivos de registro. Es más sencillo preguntar a la propia base de datos qué páginas han cambiado, pero para ello, el núcleo del SGBD debe contar con la funcionalidad de seguimiento de bloques modificados (block change tracking).
Por primera vez, la funcionalidad de copias de seguridad incrementales fue creada en el software Oracle Recovery Manager (RMAN), que apareció en la versión Oracle 8i. Oracle implementó de inmediato el seguimiento de bloques modificados, por lo que no es necesario analizar los registros.
PostgreSQL no realiza un seguimiento de los bloques modificados, por lo que la herramienta pg_probackup, desarrollada por la empresa rusa Postgres Professional, determina las páginas modificadas mediante el análisis del registro. Sin embargo, la compañía también proporciona el SGBD PostgresPro, que incluye la extensión ptrack, que sigue los cambios en las páginas. Al utilizar pg_probackup con el SGBD PostgresPro, la herramienta solicita las páginas modificadas directamente de la base de datos, al igual que lo hace RMAN.
Microsoft SQL Server, al igual que Oracle, sigue las páginas modificadas, pero el comando BACKUP solo permite realizar copias de seguridad completas y acumulativas.
En DB2 existe la posibilidad de realizar un seguimiento de las páginas modificadas, pero por defecto está desactivada. Una vez activada, DB2 permitirá realizar copias de seguridad completas, diferenciales y acumulativas.
Una diferencia importante entre las herramientas descritas en esta sección (excepto pg_probackup) y las herramientas de copias de seguridad basadas en archivos es que estas solicitan las imágenes de las páginas a la base de datos, en lugar de leer los datos desde el disco por sí mismas. La desventaja de este enfoque es una ligera carga adicional sobre la base de datos. Sin embargo, esta desventaja se compensa ampliamente con el hecho de que la página leída siempre es correcta, por lo que no es necesario activar un modo especial de registro durante el proceso de copia de seguridad.
Una vez más, es importante mencionar que la existencia de copias incrementales no elimina la necesidad de contar con registros para la recuperación en un momento específico. Por lo tanto, en bases de datos industriales, los registros se sobrescriben continuamente en un medio externo, y las copias de seguridad, completas y/o incrementales, se crean según un calendario.
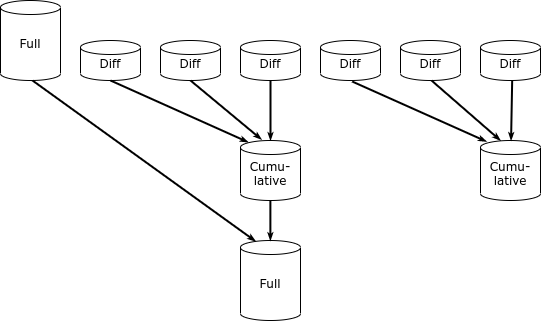
La mejor implementación hasta hoy de la idea de copia de seguridad incremental es el sistema de hardware y software (en la terminología de Oracle, un sistema diseñado) Zero Data Loss Recovery Appliance: una solución especializada de Oracle para la copia de seguridad de su propia base de datos. Este sistema consiste en un clúster servidores con una gran cantidad de discos, en los cuales se ha instalado una versión modificada del software Recovery Manager y puede funcionar tanto con otros sistemas de hardware y software de Oracle (Database Appliance, Exadata, SPARC Supercluster) como con bases de datos Oracle en una infraestructura tradicional. A diferencia del RMAN 'normal', en ZDLRA se ha implementado el concepto de 'incremento eterno' (incremental forever). El sistema crea una copia completa de la base de datos solo una vez y luego realiza copias solo incrementales. Módulos adicionales de RMAN permiten combinar copias, creando nuevas copias completas a partir de las incrementales.
Acreditamos a los desarrolladores rusos que pg_probackup también puede combinar copias incrementales.
A diferencia de muchas preguntas similares, la pregunta '¿qué método de copia de seguridad es el mejor?' tiene una respuesta clara: lo mejor es la herramienta nativa del sistema de gestión de bases de datos utilizada, que ofrece la posibilidad de copia de seguridad incremental.
Para el administrador de bases de datos, son mucho más importantes las cuestiones de elección de la estrategia de copia de seguridad y la integración de las herramientas de copia de seguridad de bases de datos en la infraestructura corporativa. Pero estas cuestiones están más allá del alcance de este artículo.
Fuente: habr.com
