

La question « comment implanter DevOps chez soi » est posée depuis des années, mais il n'existe pas beaucoup de bonnes ressources. Parfois, vous devenez une victime de la publicité de consultants pas très éclairés, qui cherchent à vendre leur temps, peu importe comment. Parfois, ce sont des paroles vagues et très générales sur la manière dont les grandes entreprises naviguent dans l'univers. La question se pose : qu'est-ce que cela signifie pour nous ? Cher auteur, pourriez-vous énoncer clairement vos idées sous forme de liste ?
Tout cela provient du fait qu'il n'y a pas encore beaucoup de pratique réelle et de compréhension des résultats des transformations culturelles dans les entreprises. Les changements culturels sont des processus longs dont les résultats ne se manifestent pas en une semaine ou un mois. Nous avons besoin de quelqu'un d'assez ancien, qui a vu les entreprises se construire et s'effondrer au fil des ans.
John Willis — l'un des pères du DevOps. Avec des dizaines d'années d'expérience dans un grand nombre d'entreprises, John a récemment remarqué des modèles spécifiques qui se manifestent dans le travail avec chacune d'elles. En utilisant ces archétypes, John guide les entreprises sur le véritable chemin de la transformation DevOps. Plus d'informations sur ces archétypes se trouvent dans la traduction de sa présentation lors de la conférence DevOops 2018.
À propos du conférencier :
Plus de 35 ans dans la gestion IT, a participé à la création du précurseur d'OpenCloud chez Canonical, a été impliqué dans 10 startups, dont deux ont été vendues à Dell et Docker. Actuellement Vice-Président des pratiques DevOps et numériques chez SJ Technologies.
Ensuite, un récit de la part de John.
Je m'appelle John Willis, et vous pouvez plus facilement me trouver sur Twitter, . C'est aussi mon pseudonyme sur Gmail et GitHub. Vous pouvez également trouver des enregistrements vidéo de mes conférences et leurs présentations. vous pouvez trouver des vidéos de mes conférences et les présentations qui y sont associées.
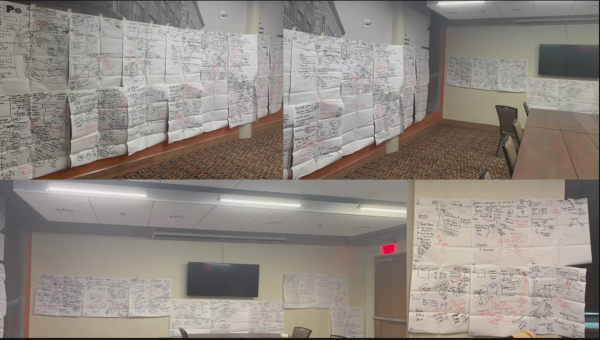
J'ai beaucoup de réunions avec des CIO de grandes entreprises. Ils se plaignent souvent de ne pas comprendre ce qu'est le DevOps, et ceux qui essaient de leur expliquer parlent de quelque chose de leur propre domaine. Une autre plainte fréquente est que le DevOps ne fonctionne pas, bien que les directeurs semblent faire tout ce qu'on leur a recommandé. Il s'agit de grandes entreprises qui existent depuis plus de cent ans. Après avoir discuté avec eux, je suis arrivé à la conclusion que pour de nombreux problèmes, des solutions relativement simples sont souvent plus adaptées que des technologies avancées. Pendant des semaines, j'ai simplement dialogué avec des personnes de différents départements. Ce que vous voyez sur la première image de ce post est l'apparence de ma salle après trois jours de travail sur le dernier projet.
Qu'est-ce que le DevOps ?
En effet, si vous demandez à dix personnes différentes, elles donneront dix réponses différentes. Mais ce qui est intéressant, c'est que toutes ces réponses seront correctes. Il n'y a pas de mauvaise réponse ici. J'ai étudié le DevOps en profondeur pendant environ dix ans et j'ai été le premier Américain à participer au premier DevOpsDay. Je ne dirais pas que je suis plus intelligent que ceux qui s'occupent du DevOps, mais il est peu probable qu'il y ait quelqu'un qui y ait consacré autant d'efforts. Je considère que le DevOps émerge lorsque le capital humain et la technologie se combinent. Nous oublions souvent la dimension humaine, même si nous parlons beaucoup de diverses cultures.
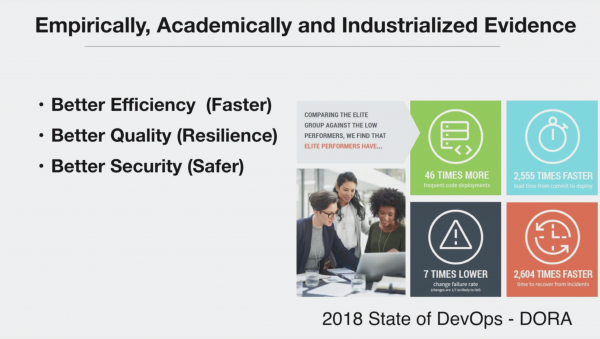
Nous disposons actuellement de nombreuses données, cinq années de recherche académique et nous avons établi un processus de vérification des théories à une échelle industrielle. Ces recherches nous disent ceci : si l'on combine certains schémas comportementaux dans la culture organisationnelle, on peut obtenir une accélération de 2000 fois. Cette accélération correspond à une amélioration similaire de la résilience. C'est une mesure quantitative de l'avantage que le DevOps peut offrir à toute entreprise. Il y a quelques années, j'ai parlé du DevOps à un directeur général d'une entreprise figurant sur la liste Fortune 5000. Lorsque je me préparais pour la présentation, j'étais très nerveux, car je devais résumer mes années d'expérience en cinq minutes.
En fin de compte, j'ai donné la définition du DevOps: c'est un ensemble de pratiques et de modèles permettant de transformer le capital humain en capital organisationnel à haute performance. Un exemple est la façon dont Toyota fonctionne depuis les 50 ou 60 dernières années.
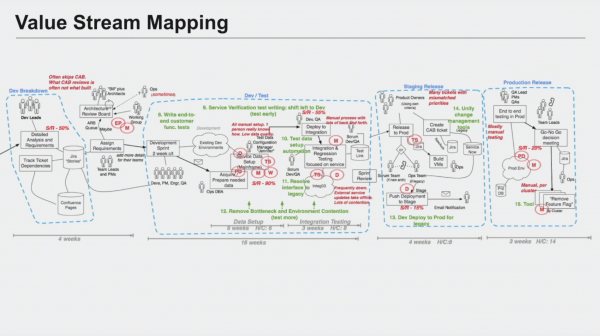
(Ces schémas et les suivants ne servent pas de référence, mais d'illustration. Leur contenu variera pour chaque nouvelle entreprise. Néanmoins, vous pouvez voir l'image séparément et l'agrandir
L'une des pratiques les plus réussies de ce type est la cartographie de flux de valeur. Plusieurs bons livres ont été écrits à ce sujet, l'un des auteurs les plus connus étant Karen Martin. Cependant, au cours de la dernière année, j'en suis arrivé à la conclusion que même cette approche est trop technologique. Elle a, sans aucun doute, de nombreux avantages, dont j'ai beaucoup profité. Mais quand le directeur général vous demande pourquoi son entreprise ne peut pas passer à de nouveaux rails, il est encore trop tôt pour parler de la cartographie de flux de valeur. Il existe de nombreuses questions fondamentalement plus importantes auxquelles il faut d'abord répondre.
Il me semble que l'erreur de nombreux collègues est qu'ils se contentent de donner à l'entreprise un guide en cinq points, puis reviennent après six mois pour voir ce qui s'est passé. Même une bonne méthode comme la cartographie de flux de valeur a, disons, des zones mortes (blind spots). Après des centaines d'entretiens avec des directeurs de diverses entreprises, j'ai développé un certain schéma permettant de décomposer le problème en éléments constitutifs, et nous allons maintenant discuter de chacun de ces éléments. Avant d'appliquer des solutions technologiques, j'utilise ce schéma, et au final, tous mes murs se retrouvent couverts de schémas. Récemment, j'ai travaillé avec un fonds mutuel, et j'ai fini par avoir 100 à 150 de ces schémas.
Une mauvaise culture digère de bonnes approches au petit déjeuner
L'idée principale est la suivante : aucune méthode Lean, Agile, SAFE ou DevOps ne pourra aider si la culture de l'organisation elle-même est mauvaise. C'est comme plonger en profondeur sans bouteille de plongée ou opérer sans radiographie. En d'autres termes, pour paraphraser Drucker et Deming : une mauvaise culture organisationnelle absorbera tout bon système et ne crachera pas.
Pour résoudre ce problème majeur, il est nécessaire d'entreprendre les étapes suivantes :
- Rendre tout le travail visible : il faut rendre tout le travail visible. Pas dans le sens où il doit obligatoirement apparaître sur un écran quelconque, mais dans le sens où il doit être observable.
- Consolider les systèmes de gestion du travail : Il est nécessaire de consolider les systèmes de gestion. Dans le problème des connaissances « tribales » et des connaissances institutionnelles, dans 9 cas sur 10, le goulot d'étranglement est constitué par les personnes. Dans le livre le problème se retrouvait chez un seul individu, Brent, au sujet duquel le projet accusait un retard de trois ans. Et je rencontre des « Brents » partout. Pour résoudre ces goulots d'étranglement, j'utilise les deux éléments suivants dans notre liste.
- Méthodologie de la théorie des contraintes : théorie des contraintes.
- Astuces de collaboration : hacks de collaboration.
- Toyota Kata (): Je ne vais pas parler beaucoup de Toyota Kata. Si cela vous intéresse, sur mon GitHub presque sur chacun de ces thèmes.
- Organisation orientée marché : organisation axée sur le marché.
- Auditeurs shift-left : audit précoce dans le cycle.
Je commence à travailler avec l'organisation de manière très simple : je vais dans l'entreprise et je parle avec les employés. Comme on le voit, aucune haute technologie. Tout ce qu'il faut, c'est d'avoir quelque chose pour écrire. Je regroupe plusieurs équipes dans une même pièce et j'analyse ce qu'elles me disent du point de vue de mes 7 archétypes. Ensuite, je leur donne un marqueur et leur demande de transcrire au tableau tout ce qu'elles ont déjà exprimé à voix haute. En général, lors de ce type de réunions, il y a une personne qui prend des notes, et dans le meilleur des cas, elle parvient à enregistrer 10 % de la discussion. Grâce à ma méthode, ce taux peut atteindre environ 40 %.
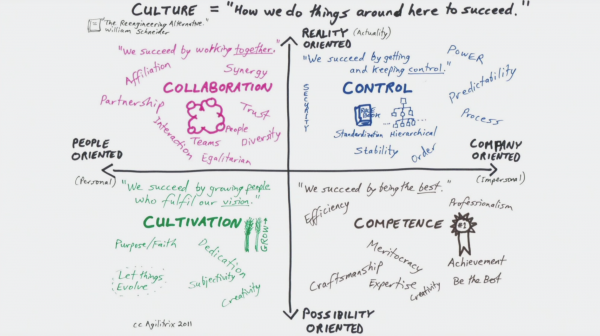
(Cette illustration peut être )
Mon approche est fondée sur le travail de William Schneider (William Schneider, ). Au cœur de cette approche se trouve l'idée que toute organisation peut être décomposée en quatre quadrants. Ce schéma résulte généralement de mon travail avec les nombreuses autres schémas qui émergent lors de l'analyse de l'organisation. Supposons que nous ayons une organisation avec un haut niveau de contrôle, mais avec une faible compétence. C'est un scénario extrêmement indésirable : quand tout le monde agit de manière rigide, mais que personne ne sait ce qu'il faut faire.
Une option nettement améliorée avec un haut niveau de contrôle et de compétence. Si une entreprise est rentable, peut-être que DevOps n'est pas nécessaire. Travailler avec une entreprise ayant un bon niveau de contrôle, une compétence faible mais une collaboration élevée et une culture forte est le plus intéressant. Cela signifie qu'il y a beaucoup de personnes qui aiment travailler là-bas et que le turnover est faible.
(Cette illustration peut être )
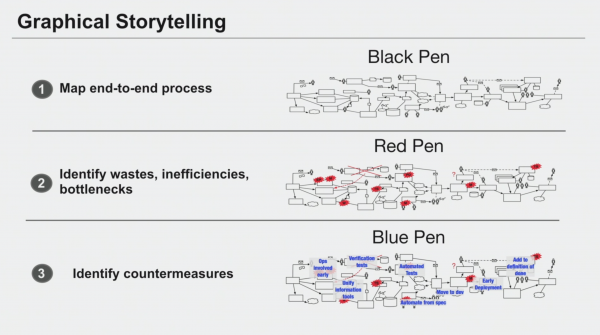
Je pense que les méthodes avec des recommandations strictes finissent par obstruer la recherche de la vérité. En particulier, dans le value stream mapping, il existe de nombreuses règles concernant la manière de structurer l'information. Au début du processus, dont je parle, ces règles ne sont pas nécessaires. Si quelqu'un, avec un marqueur à la main, décrit sur un tableau la situation réelle de l'entreprise, c'est le meilleur moyen de comprendre les choses. Cette information n'atteint pas les directeurs. À ce moment-là, il est absurde d'interrompre une personne et de dire qu'elle a mal dessiné une flèche. À ce stade, il vaut mieux utiliser des règles simples, par exemple : une abstraction multi-niveaux peut être créée simplement en utilisant des marqueurs de différentes couleurs.
Je répète, pas de haute technologie. La réalité objective est représentée par un marqueur noir, montrant comment tout fonctionne. Avec un marqueur rouge, les gens indiquent ce qu'ils n'aiment pas dans la situation actuelle. Il est important que ce soit eux qui l'écrivent, pas moi. Lorsque, après la réunion, je me rends chez le directeur des technologies de l'information, je ne propose pas une liste de 10 points à corriger. Je cherche à établir des liens entre ce que disent les gens de l'entreprise et les modèles éprouvés existants. Enfin, avec un marqueur bleu, des solutions potentielles au problème sont proposées.
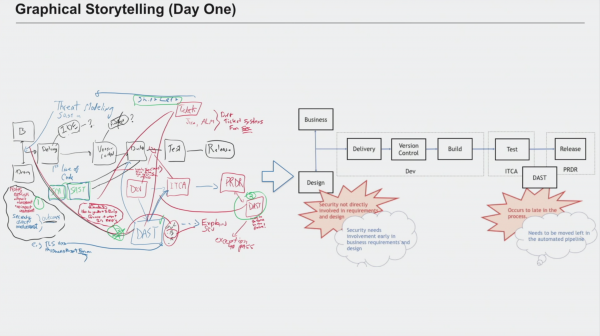
(Cette illustration peut être )
Un exemple de cette approche est visible ci-dessus. Au début de cette année, j'ai travaillé avec une banque. Les employés du département de sécurité étaient convaincus qu'ils ne devaient pas assister aux évaluations des exigences et à la conception (design and requirement reviews).
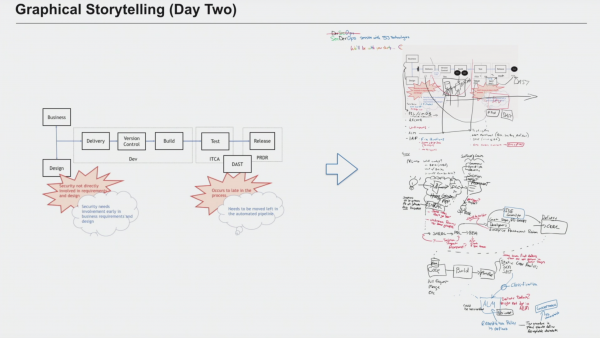
(Cette illustration peut être )
Puis nous avons parlé avec des personnes d'autres départements et il s'est avéré qu'il y a environ 8 ans, les développeurs de logiciels avaient évincé les employés de sécurité parce qu'ils ralentissaient le travail. Cela s'était ensuite transformé en une interdiction qui était perçue comme un fait établi. Pourtant, il n'y avait en réalité aucune interdiction.
Notre réunion a pris un tour très confus : pendant environ trois heures, cinq équipes différentes n'ont pas pu m'expliquer ce qui se passe entre le code et la compilation. Et c'est pourtant la chose la plus simple. La plupart des consultants DevOps partent du principe que cela est déjà connu de tous.
Puis la personne en charge de la gouvernance IT, qui était restée silencieuse pendant quatre heures, s'est soudainement animée lorsque nous avons abordé son sujet, et nous a occupés encore longtemps. À la fin, je lui ai demandé ce qu'il pensait de la réunion, et je n'oublierai jamais sa réponse. Il a dit : « Auparavant, je pensais qu'il n'y avait que deux manières de livrer des logiciels dans notre banque, maintenant je sais qu'il y en a cinq, et je ne soupçonnais même pas trois d'entre elles ».
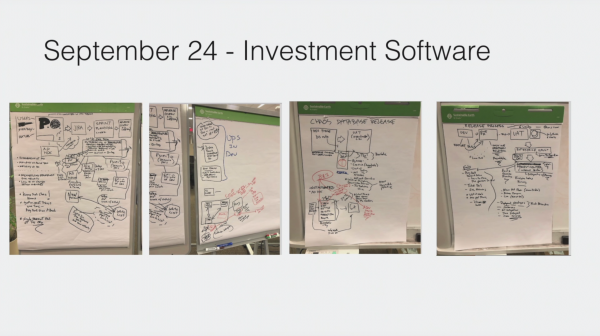
(Cette illustration peut être )
La dernière réunion dans cette banque a eu lieu avec l'équipe qui s'occupe des logiciels d'investissement. C'est avec elle que j'ai découvert qu'il est préférable d'écrire des schémas avec un marqueur sur une feuille plutôt que sur un tableau, et même mieux que sur un tableau interactif.
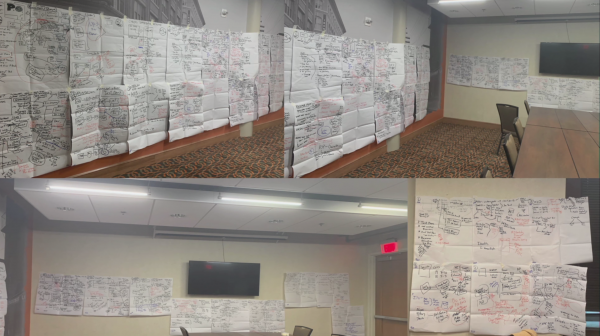
Les photos que vous voyez montrent à quoi ressemblait la salle de conférence de l'hôtel le quatrième jour de notre réunion. Et ces schémas ont été utilisés pour rechercher des patterns, c'est-à-dire des archétypes.
Ainsi, je pose des questions aux employés, ils notent les réponses avec des marqueurs de trois couleurs (noir, rouge et bleu). J'analyse leurs réponses en quête d'archétypes. Maintenant, discutons de tous les archétypes dans l'ordre.
1. Make All Work Visible: Rendre le travail visible
Dans la plupart des entreprises avec lesquelles je travaille, un pourcentage très élevé du travail est inconnu. Par exemple, c'est lorsque qu'un employé demande à un autre de faire quelque chose. Dans de grandes organisations, jusqu'à 60 % du travail peut être non planifié. Et jusqu'à 40 % du travail n'est pas du tout documenté. Si c'était Boeing, je ne prendrais plus jamais leur vol. Si seule la moitié du travail est documentée, on ne sait pas si ce travail est fait correctement ou non. Tous les autres moyens deviennent inutiles - il n'est pas pertinent d'essayer d'automatiser quoi que ce soit, car les 50 % connus peuvent précisément être la partie la plus harmonieuse et structurée du travail, dont l'automatisation ne donnera pas de grands résultats, tandis que le pire se trouve dans la moitié invisible. En l'absence de documentation, il est impossible de trouver toutes sortes de hacks et de travaux cachés, de déceler les goulets d'étranglement, ces fameux « Brents » dont j'ai déjà parlé. Il y a un excellent livre de Dominica DeGrandis. . Elle identifie cinq différents « voleurs de temps » (thieves of time):
- Trop de travail en cours (WIP)
- Dépendances inconnues
- Travail non planifié
- Priorités conflictuelles
- Travail négligé
C'est une analyse très précieuse, et le livre est remarquable, mais tous ces conseils sont inutiles si seuls 50 % des données sont visibles. Les méthodes proposées par Dominica peuvent être appliquées si la précision est supérieure à 90 %. Je parle de situations où un supérieur donne une tâche de 15 minutes à un subordonné, et cela prend en réalité trois jours ; mais le supérieur ne sait pas que ce subordonné dépend encore de quatre ou cinq autres personnes.
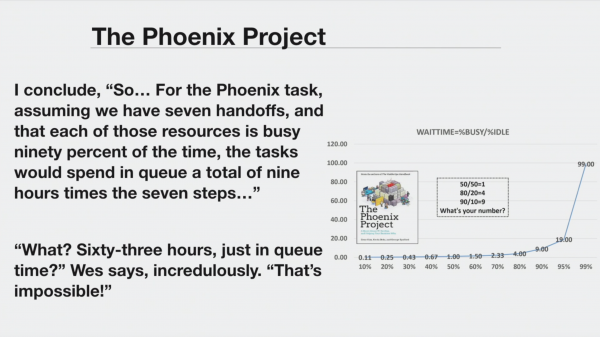
Le Projet Phoenix est une histoire remarquable sur un projet en retard de trois ans. L'un des personnages risque de perdre son emploi à cause de cela, et il rencontre un autre personnage présenté comme une sorte de Socrate. Ce dernier l'aide à comprendre ce qui a mal tourné. Il s'avère qu'il y a une administrateur système dans l'entreprise, nommé Brent, et que tout le travail passe d'une manière ou d'une autre par lui. Lors d'une réunion, l'un des subordonnés demande : pourquoi chaque tâche de 30 minutes prend-elle une semaine ? En réponse, une très simplifiée illustration de la théorie des files d'attente et de la loi de Little est donnée, révélant qu'à 90 % d'occupation, chaque heure de travail prend 9 heures. Chaque tâche doit être envoyée à sept autres personnes, transformant ainsi cette heure en 63 heures, 7 multiplié par 9. Je souligne cela pour illustrer qu'il faut avoir des données pour appliquer la loi de Little ou toute théorie de file d'attente un tant soit peu complexe.
Donc, quand je parle de visibilité, je ne veux pas dire que tout doit être à l'écran, mais qu'il faut au moins avoir des données. Quand elles existent, il s'avère souvent qu'il y a une très grande quantité de travail non planifié qui, pour une raison quelconque, est dirigé vers Brent, alors qu'il n'y a aucune nécessité. Et Brent est un gars formidable, il ne dit jamais « non », mais il ne dit à personne comment il accomplit son travail.
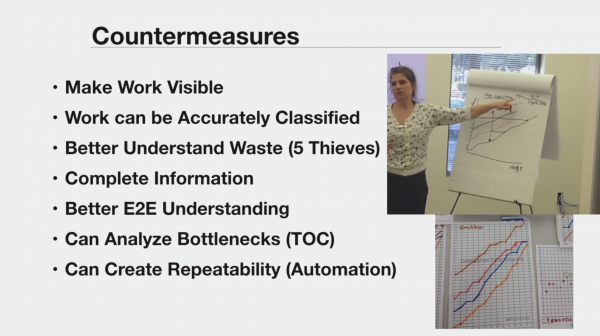
Lorsque le travail est visible, il est possible de classer les données de manière soignée (c'est exactement ce que Dominique fait sur la photo), d'appliquer l'abstraction des cinq fuites de temps et d'automatiser.
2. Consolider les systèmes de gestion du travail : Gestion des tâches
Les archétypes dont je parle ressemblent à une sorte de pyramide. Si le premier est bien réalisé, le deuxième constitue une sorte de surcouche. Beaucoup d'entre eux ne fonctionnent pas pour les startups, mais il faut les garder à l'esprit pour les grandes entreprises, comme celles qui figurent sur la liste des Fortune 5000. Dans la dernière entreprise où j'ai travaillé, il y avait 10 systèmes de suivi des erreurs (système de tickets). Dans une équipe, il y avait Remedy, une autre avait développé son propre système, la troisième utilisait Jira, et certaines se débrouillaient juste avec des emails. Le même problème survient si l'entreprise dispose de 30 pipelines différents, mais je n'ai pas le temps de discuter de tous ces cas.
Je discute avec des gens de la manière dont les tickets sont créés, de ce qui leur arrive ensuite, comment ils sont contournés. Ce qui est le plus intéressant, c'est que les gens lors de nos réunions parlent assez sincèrement. J'ai demandé combien de personnes attribuent « mineur / pas d'impact » à des tickets qui auraient en réalité dû recevoir « impact majeur ». Il s'est avéré que presque tout le monde le fait. Je ne fais pas de délation et j'essaie de ne pas identifier les personnes. Quand on me fait une confession sincère, je ne dévoile pas l'individu. Mais quand presque tout le monde contourne le système, cela signifie que toute la sécurité est en réalité une façade. Par conséquent, aucune conclusion ne peut être tirée des données de ce système.
Pour résoudre le problème des tickets, il est nécessaire de choisir un système principal. Si vous utilisez Jira, alors ce ne doit être que Jira. S'il y a une alternative, ce doit être celle-ci. L'idée est que les tickets doivent être considérés comme une étape supplémentaire du processus de développement. Chaque action doit avoir un ticket qui doit passer par le workflow de développement. Les tickets sont envoyés à l'équipe qui les place sur le tableau et en assume ensuite la responsabilité.
Cela concerne tous les départements, y compris l'infrastructure et les opérations. Dans ce cas, il est possible de dresser une représentation à peu près fiable de la situation. Une fois ce processus établi, il s'avère qu'il est facile de déterminer qui est responsable de chaque application. Parce qu'à présent, nous recevons non pas 50 %, mais 98 % de nouveaux services. Si ce processus principal fonctionne, la précision s'améliore dans l'ensemble du système.
Pipeline des services
Cela concerne encore une fois uniquement les grandes entreprises. Si vous êtes une nouvelle société dans un nouveau domaine, retroussez vos manches et travaillez avec votre Travis CI ou CircleCI. En ce qui concerne les entreprises Fortune 5000, un exemple significatif est celui de la banque où j'ai travaillé. Ils ont reçu la visite de Google, qui leur a montré des graphiques sur d'anciennes systèmes IBM. Les gars de Google ont demandé avec incompréhension : où est le code source pour cela ? Et il n'y a pas de code source, même pas d'interface graphique. C'est la réalité avec laquelle travaillent les grandes organisations : des dossiers bancaires de 40 ans sur un ancien mainframe. Un de mes clients utilise des conteneurs Kubernetes avec des motifs de Circuit Breaker, plus Chaos Monkey, tout cela pour l'application KeyBank. Mais ces conteneurs se connectent finalement à une application en COBOL.
Les gars de Google étaient convaincus qu'ils résoudraient tous les problèmes de mon client, puis ils ont commencé à poser des questions : qu'est-ce que le IBM datapipe ? On leur répond : c'est un connecteur. À quoi se connecte-t-il ? Au système Sperry. Et ça, c'est quoi ? Et ainsi de suite. À première vue, on pourrait penser : où est le DevOps ici ? Mais en réalité, c'est possible. Il existe des systèmes de livraison qui permettent de transmettre le flux de travail aux équipes de livraison.
3. Théorie des contraintes : Theory of Constraints
Passons au troisième archétype : la connaissance institutionnelle / « tribale ». En général, dans toute organisation, il y a quelques personnes qui savent tout et dirigent tout. Ce sont ceux qui travaillent le plus longtemps dans l'organisation et qui connaissent toutes les astuces.
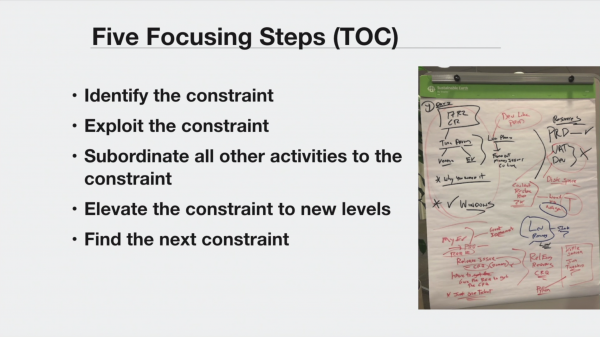
Lorsqu'on remarque cela sur le graphique, je souligne ces personnes avec un marqueur : par exemple, il s'avère qu'un certain Lou est présent à toutes les réunions. Et pour moi, c'est clair : c'est le Brent local. Lorsque le directeur des technologies de l'information doit choisir entre moi en t-shirt et baskets et un gars en costume de chez IBM, on me choisit parce que je peux informer le directeur de choses que l'autre gars ne lui dira pas et qui pourraient être délicates à entendre. Je leur dis que dans leur société, il y a un goulet d'étranglement, une certaine personne nommée Fred et une autre nommée Lou. Ce goulet d'étranglement doit être résolu, leur savoir doit être acquis d'une manière ou d'une autre.
Pour résoudre ce genre de problème, je peux, par exemple, proposer d'utiliser Slack. Un directeur avisé demanderait pourquoi ? Habituellement, dans de tels cas, les consultants DevOps répondent : parce que tout le monde le fait. Si le directeur est réellement avisé, il dira : et alors ? Et c'est à ce moment-là que le dialogue se termine. Et ma réponse est : parce qu'il y a quatre goulots d'étranglement dans l'entreprise, Fred, Lou, Suzie et Jane. Pour institutionnaliser leur savoir, il faut d'abord introduire Slack. Tous vos wikis sont complètement inutiles, car personne n'est au courant de leur existence. Si l'équipe d'ingénieurs travaille à la fois sur des projets externes et internes, tout le monde doit savoir qu'il peut se tourner vers l'équipe de développement externe ou l'équipe d'infrastructure pour poser des questions. C'est alors que Lou ou Fred disposera probablement de temps pour consulter le wiki. Ensuite, quelqu'un dans Slack peut demander pourquoi, disons, l'étape 5 ne fonctionne pas. Et à ce moment-là, Lou ou Fred corrigeront l'instruction dans le wiki. Si ce processus est bien en place, beaucoup d'autres choses deviendront rapidement plus simples.
C'est là ma principale réflexion : pour recommander des technologies avancées, il faut d'abord mettre en ordre les bases, et cela peut être réalisé avec les solutions technologiquement simples que je viens de décrire. Si l'on commence par des technologies avancées sans expliquer pourquoi elles sont nécessaires, cela ne se termine généralement pas bien. L'un de nos clients utilise Azure ML, une solution très bon marché et simple. Environ 30 % des questions étaient déjà traitées par la machine auto-apprenante elle-même. Et ce sont des opérateurs qui ne faisaient pas de data science, de statistiques ou de mathématiques qui l'ont développée. C'est révélateur. Le coût d'une telle solution est minimal.
4. Hacks de collaboration : Hacking de la collaboration
Le quatrième archétype concerne la nécessité de lutter contre l'isolement. La plupart des gens le savent déjà : l'isolement engendre de l'hostilité. Si chaque département est à son étage, et que les gens ne se rencontrent que dans l'ascenseur, l'hostilité entre eux se développe très facilement. En revanche, si les gens se trouvent dans la même pièce, elle disparaît immédiatement. Lorsque quelqu'un lance une accusation commune, par exemple, tel ou tel interface ne fonctionne jamais, il n'y a rien de plus simple que de déconstruire cette accusation. Il suffit aux développeurs qui ont créé l'interface de commencer à poser des questions précises, et il s'avérera bientôt que, par exemple, l'utilisateur utilise mal l'outil.
Il existe de nombreuses façons de surmonter l'isolement. Une fois, on m'a demandé de conseiller une banque en Australie, mais j'ai refusé car j'ai deux enfants et une femme. Tout ce que j'ai pu leur recommander, c'est le 'graphical storytelling'. C'est une méthode qui fonctionne prouvée. Une autre manière intéressante est les rencontres de type 'lean coffee'. Dans une grande organisation, c'est un excellent moyen de partager les connaissances. De plus, on peut organiser des devopsdays internes, des hackathons, etc.
5. Coaching Kata
Comme je l'ai déjà averti dès le début, je ne vais pas en parler aujourd'hui. Si cela vous intéresse, vous pouvez consulter .
Il y a aussi une bonne présentation sur ce sujet de Mike Rother :
6. Orienté Marché : organisation orientée sur le marché
Ici, il existe différents problèmes. Par exemple, les personnes en 'I', les personnes en 'T' et les personnes en 'E'. Les personnes en 'I' se concentrent uniquement sur une seule chose. Elles existent généralement dans des organisations avec des départements isolés. 'T' signifie qu'une personne connaît bien une chose, mais excelle aussi dans d'autres domaines. 'E' ou même 'peigne' se réfère à une personne ayant de nombreuses compétences.
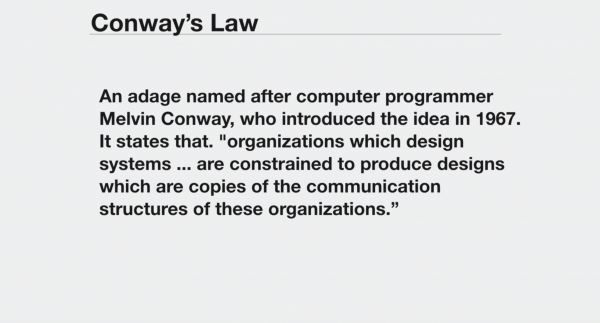
La loi de Conway s'applique ici (), qui peut être résumé de manière très simple : si trois équipes travaillent sur un compilateur, alors le résultat sera un compilateur en trois parties. Par conséquent, si le niveau d'isolement au sein d'une organisation est élevé, même Kubernetes, Circuit breaker, API extensibility et autres tendances de cette organisation seront organisés de la même manière que l'organisation elle-même. Strictement selon Conway, et en dépit de vous tous, jeunes geeks.
La solution à ce problème a été décrite de nombreuses fois. Il existe, par exemple, des archétypes organisationnels décrits par Fernando Fernandez. L'architecture problématique dont je viens de parler, avec une isolation, est une architecture orientée fonctionnelle. Le deuxième type — le pire, l'architecture matricielle, où c'est un mélange des deux autres. Le troisième — c'est ce qui est observé dans la plupart des startups, et les grandes entreprises essaient également d'adopter ce type. C'est une organisation orientée vers le marché. Ici, l'optimisation vise à obtenir la réponse la plus rapide aux demandes des clients. Cela s'appelle parfois une organisation plate.
Cette structure est décrite de différentes manières par beaucoup, j'aime la formulation build/run teams, chez Amazon, cela s'appelle two pizza teams. Dans cette structure, toutes les personnes de type « I » se regroupent autour d'un service, et progressivement elles se rapprochent du type « T », et si une bonne gestion est en place, elles peuvent même devenir « E ». Le premier contre-argument ici — dans une telle structure, il y a des éléments superflus. Pourquoi a-t-on besoin d'un testeur dans chaque division, alors qu'il pourrait y avoir un département spécial de testeurs ? À quoi je réponds : les dépenses superflues dans ce cas sont le prix à payer pour que, dans le futur, toute l'organisation devienne de type « E ». Dans cette structure, le testeur apprend progressivement sur les réseaux, l'architecture, la conception, etc. Au final, chaque participant de l'organisation est complètement informé de tout ce qui se passe dans l'organisation. Si vous voulez savoir comment ce schéma fonctionne dans l'industrie, lisez .
7. Auditeurs shift-left : audit aux premières étapes du cycle. La conformité aux règles de sécurité visible
C'est quand vos actions ne passent pas, pour ainsi dire, le test de l'odeur. Les gens qui travaillent pour vous ne sont pas stupides. S'ils ont, comme dans l'exemple ci-dessus, constamment signalé un impact mineur ou nul pendant trois ans et que personne n'a rien remarqué, tout le monde sait que le système ne fonctionne pas. Ou un autre exemple — le conseil sur les changements, où chaque semaine, disons, il faut soumettre des rapports. Là, un groupe de personnes (je dois ajouter, pas très bien payé), qui théoriquement devraient savoir comment fonctionne le système dans son ensemble, travaille. Et au cours des cinq dernières années, vous avez probablement remarqué que nos systèmes sont d'une complexité folle. Cinq ou six personnes doivent prendre une décision sur un changement qu'elles n'ont pas apporté et dont elles ne savent rien.
Bien sûr, cette approche ne fonctionne pas. Je dois me débarrasser de ces choses, car ces personnes ne protègent pas le système. La décision doit être prise par l'équipe elle-même, car l'équipe doit en être responsable. Sinon, une situation paradoxale se produit, où un manager, qui n'a jamais écrit de code de sa vie, dit à un programmeur combien de temps cela devrait prendre pour écrire le code. Dans une entreprise avec laquelle j'ai travaillé, il y avait sept conseils différents qui examinaient chaque changement, y compris le conseil d'architecture, des produits, etc. Il existait même un délai de réflexion obligatoire, bien qu'un employé m'ait dit qu'en dix ans de travail, personne n'avait jamais rejeté d'importantes modifications de la part de cette personne durant ce délai.
Il faut inviter les auditeurs à venir, plutôt que de s'en débarrasser. Dites-leur que vous écrivez des conteneurs binaires immuables qui, s'ils passent tous les tests, restent inchangés pour toujours. Dites-leur que vous avez un pipeline as code, et expliquez ce que cela signifie. Montrez-leur le schéma suivant : un binaire immuable uniquement en lecture dans un conteneur, qui passe tous les tests de vulnérabilité ; et ensuite, non seulement personne n'y touche — même le système qui crée le pipeline n'est pas touché, car il est également créé dynamiquement. J'ai des clients, Capital One, qui utilisent Vault pour créer quelque chose ressemblant à une blockchain. Il n'est pas nécessaire de montrer aux auditeurs des « recettes » de Chef, il suffit de montrer la blockchain, qui indique clairement ce qu'il est advenu du ticket Jira en production et qui en est responsable.
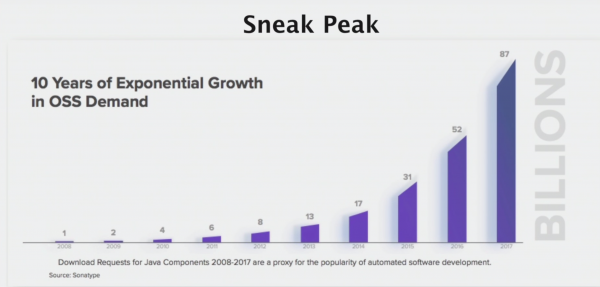
Selon , créé en 2018 par Sonatype, en 2017, il y avait 87 milliards de requêtes de téléchargement OSS.
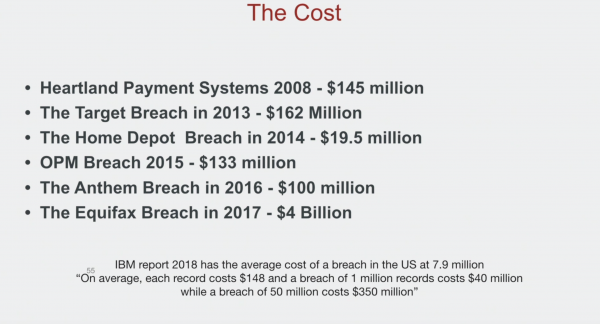
Les pertes dues aux vulnérabilités sont excessivement élevées. D'ailleurs, les chiffres que vous voyez ci-dessus n'incluent pas les coûts alternatifs. En quelques mots sur ce qu'est le DevSecOps. Je veux tout de suite préciser que je ne suis pas intéressé par des débats sur la pertinence de ce nom. L'idée est que, puisque les DevOps ont eu un grand succès, il faut essayer d'ajouter la sécurité à ce pipeline.
Un exemple de cette séquence :
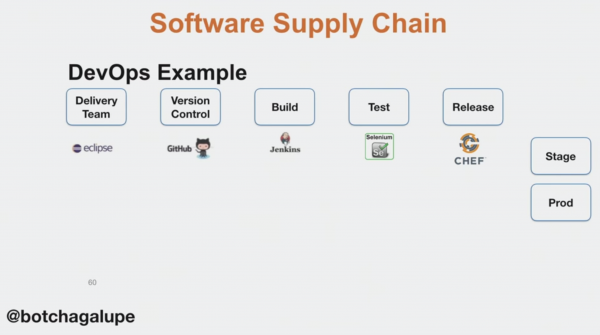
Ce n'est pas une recommandation de produits spécifiques, bien que je les apprécie tous. Je les ai donnés comme exemple pour montrer que le DevOps, basé à l'origine sur la paradigme de l'organisation industrielle, permet d'automatiser chaque étape du travail sur le produit.
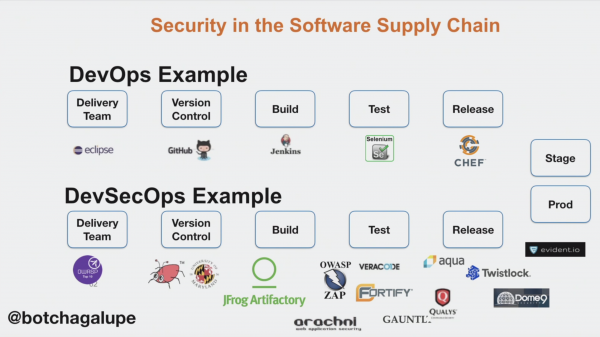
Et il n'y a aucune raison pour laquelle nous ne pourrions pas appliquer la même approche à la sécurité.
Conclusion
En conclusion, je vais donner quelques conseils pour le DevSecOps. Il est essentiel d'inclure des auditeurs dans le processus de création de vos systèmes et de prendre le temps de les former. Il faut collaborer avec les auditeurs. Ensuite, il est crucial de mener une lutte sans merci contre les faux positifs. Même avec l'outil d'analyse de vulnérabilités le plus coûteux, il est possible de créer de mauvaises habitudes chez vos développeurs si vous ne comprenez pas le rapport signal/bruit. Les développeurs seront submergés par les notifications et finiront par les ignorer. Si vous avez entendu parler de l'affaire Equifax, vous connaissez un peu la situation : le signal le plus critique a été ignoré. De plus, il est important d'expliquer les vulnérabilités de manière à ce qu'il soit clair comment elles impactent les affaires. Par exemple, vous pouvez dire qu'il s'agit de la même vulnérabilité que celle de l'affaire Equifax. Les vulnérabilités de sécurité doivent être considérées comme d'autres problèmes logiciels, c'est-à-dire qu'elles doivent être intégrées dans le processus DevOps global. Elles doivent être gérées via Jira, Kanban, etc. Les développeurs ne doivent pas penser que quelqu'un d'autre s'en chargera — au contraire, c'est un travail qui incombe à tous. Enfin, il est nécessaire de déployer des efforts pour former les gens.
Liens utiles
Voici quelques présentations de la conférence DevOops qui pourraient vous intéresser :
- Sergueï Berdnikov, Artiom Kalitchkine — Histoire à succès, ou « Dev+DevOps+Ops » (, )
- Baruch Sadogursky, Leonid Igorlik — DevOps à grande échelle : une tragédie grecque en trois actes (, )
- Alexandre Titov, Kirill Talkachev —
- Timothy Lister —
Jetez un œil à DevOops 2020 Moscou — il y a aussi beaucoup d'autres choses intéressantes.
Source : habr.com
