

Ponekad, da biste riješili problem, samo ga trebate pogledati iz drugog kuta. Čak i ako su u proteklih 10 godina slični problemi rješavani na isti način s različitim učincima, nije činjenica da je ova metoda jedina.
Postoji takva tema kao što je odlazak kupaca. Stvar je neizbježna, jer kupci bilo koje tvrtke mogu iz više razloga prestati koristiti njezine proizvode ili usluge. Naravno, za poduzeće, odljev je prirodna, ali ne i najpoželjnija radnja, pa svi pokušavaju minimizirati ovaj odljev. Još bolje, predvidite vjerojatnost odlaska za određenu kategoriju korisnika ili određenog korisnika i predložite neke korake za njihovo zadržavanje.
Potrebno je analizirati i pokušati zadržati klijenta, ako je moguće, iz najmanje sljedećih razloga:
- privlačenje novih kupaca je skuplje od postupaka zadržavanja. Za privlačenje novih kupaca u pravilu je potrebno izdvojiti nešto novca (reklamiranje), dok se postojeće kupce može aktivirati posebnom ponudom uz posebne uvjete;
- Razumijevanje razloga zašto kupci odlaze ključno je za poboljšanje proizvoda i usluga.
Postoje standardni pristupi predviđanju odljeva. Ali na jednom od AI prvenstva odlučili smo isprobati Weibullovu distribuciju za ovo. Najčešće se koristi za analizu preživljavanja, vremensku prognozu, analizu prirodnih katastrofa, industrijsko inženjerstvo i slično. Weibullova distribucija je posebna funkcija distribucije parametrizirana s dva parametra  и
 .
Wikipedia
Općenito, to je zanimljiva stvar, ali za predviđanje odljeva, i općenito u fintechu, ne koristi se tako često. U nastavku ćemo vam reći kako smo mi (Laboratorij za rudarenje podataka) to učinili, istovremeno osvojivši zlato na prvenstvu umjetne inteligencije u kategoriji "AI u bankama".
O odljevu općenito
Hajdemo malo razumjeti što je odlazak kupaca i zašto je toliko važan. Baza kupaca je važna za posao. U ovu bazu dolaze novi kupci, primjerice, koji su za neki proizvod ili uslugu saznali iz oglasa, žive neko vrijeme (aktivno koriste proizvode) i nakon nekog vremena prestanu s korištenjem. To se razdoblje naziva "Životni ciklus kupca" - izraz koji opisuje faze kroz koje kupac prolazi kada sazna za proizvod, donese odluku o kupnji, plati, koristi i postane lojalan potrošač te na kraju prestane koristiti proizvod. iz ovog ili onog razloga. Sukladno tome, churn je završna faza životnog ciklusa klijenta, kada klijent prestaje koristiti usluge, a za posao to znači da je klijent prestao donositi profit ili bilo kakvu korist.
Svaki klijent banke je određena osoba koja bira jednu ili drugu bankovnu karticu posebno za svoje potrebe. Ako često putujete, dobro će vam doći kartica s miljama. Puno kupuje - pozdrav, cashback kartica. Mnogo kupuje u određenim trgovinama - a za to već postoji posebna partnerska plastika. Naravno, ponekad se kartica odabire prema kriteriju "Najjeftinija usluga". Općenito, ovdje ima dovoljno varijabli.
A osoba također bira samu banku - ima li smisla birati karticu banke čije su podružnice samo u Moskvi i regiji, kada ste iz Habarovska? Čak i ako je kartica takve banke barem 2 puta isplativija, prisutnost poslovnica banke u blizini i dalje je važan kriterij. Da, 2019. je već tu i digital je naše sve, ali niz problema s nekim bankama moguće je riješiti samo u poslovnici. Plus, opet, neki dio stanovništva puno više vjeruje fizičkoj banci nego aplikaciji na pametnom telefonu, i to treba uzeti u obzir.
Kao rezultat toga, osoba može imati mnogo razloga za odbijanje bankovnih proizvoda (ili same banke). Promijenio sam posao, a tarifa kartice iz plaće u “Za obične smrtnike”, što je manje isplativo. Preselio sam se u drugi grad gdje nema poslovnica banaka. Nije mi se svidjela interakcija s nekvalificiranim operaterom u poslovnici. Odnosno, možda postoji više razloga za zatvaranje računa nego za korištenje proizvoda.
A klijent ne samo da može jasno izraziti svoju namjeru - doći u banku i napisati izjavu, već jednostavno prestati koristiti proizvode bez raskida ugovora. Odlučeno je koristiti strojno učenje i AI za razumijevanje takvih problema.
Štoviše, odljev korisnika može se pojaviti u bilo kojoj industriji (telekomunikacijski, internetski pružatelji usluga, osiguravajuća društva, općenito, gdje god postoji baza korisnika i periodične transakcije).
Što smo učinili
Prije svega, bilo je potrebno opisati jasnu granicu - od kada počinjemo smatrati da je klijent otišao. Sa stajališta banke koja nam je dostavila podatke za naš rad, status aktivnosti klijenta bio je binarni – ili je aktivan ili nije. Postojala je oznaka ACTIVE_FLAG u tablici "Aktivnost", čija je vrijednost mogla biti ili "0" ili "1" ("Neaktivno" i "Aktivno"). I sve bi bilo u redu, ali osoba je takva da ga može aktivno koristiti neko vrijeme, a onda ispadne s popisa aktivnih na mjesec dana - razbolio se, otišao u drugu zemlju na odmor ili čak otišao testirati kartica druge banke. Ili možda nakon dužeg razdoblja neaktivnosti ponovno počnite koristiti usluge banke
Stoga smo odlučili nazvati razdoblje neaktivnosti određeno kontinuirano vremensko razdoblje tijekom kojeg je zastavica bila postavljena na "0".
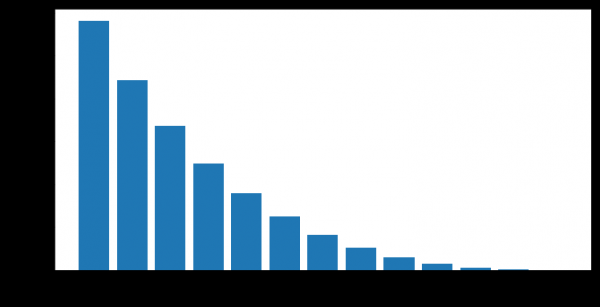
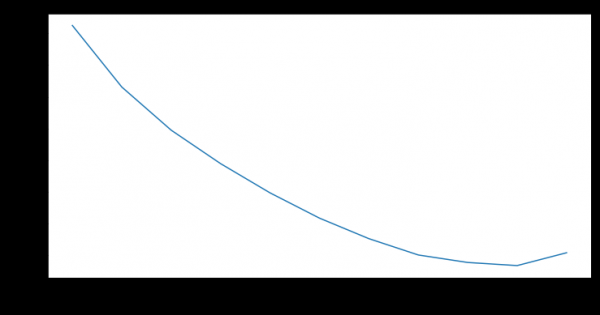
Klijenti prelaze iz neaktivnog u aktivnog nakon razdoblja neaktivnosti različitih duljina. Imamo priliku izračunati stupanj empirijske vrijednosti “pouzdanosti razdoblja neaktivnosti” - odnosno vjerojatnost da će osoba ponovno početi koristiti bankovne proizvode nakon privremene neaktivnosti.
Na primjer, ovaj grafikon prikazuje nastavak aktivnosti (ACTIVE_FLAG=1) klijenata nakon nekoliko mjeseci neaktivnosti (ACTIVE_FLAG=0).
Ovdje ćemo malo pojasniti skup podataka s kojim smo počeli raditi. Dakle, banka je dostavila agregirane podatke za 19 mjeseci u sljedećim tablicama:
- “Aktivnost” - mjesečne transakcije korisnika (kartičnim putem, u internetskom i mobilnom bankarstvu), uključujući obračun plaća i podatke o prometu.
- “Kartice” - podaci o svim karticama koje klijent ima, s detaljnim tarifnim rasporedom.
- „Ugovori” - informacije o klijentovim ugovorima (otvorenim i zatvorenim): zajmovi, depoziti itd., s naznakom parametara svakog.
- “Kupci” - skup demografskih podataka (spol i dob) i dostupnost podataka za kontakt.
Za rad su nam bile potrebne sve tablice osim “Mape”.
Ovdje je postojala još jedna poteškoća - u ovim podacima banka nije naznačila kakva se aktivnost odvijala na karticama. Odnosno, mogli smo razumjeti ima li transakcija ili ne, ali više nismo mogli odrediti njihovu vrstu. Stoga je bilo nejasno je li klijent podizao gotovinu, primao plaću ili novac trošio na kupovinu. Također nismo imali podatke o stanju računa, što bi bilo korisno.
Sam uzorak bio je nepristran - u ovom odjeljku, tijekom 19 mjeseci, banka nije pokušala zadržati klijente i minimizirati odljev.
Dakle, o razdobljima neaktivnosti.
Da bi se formulirala definicija odljeva, mora se odabrati razdoblje neaktivnosti. Za izradu prognoze odljeva u određenom trenutku  , morate imati povijest kupaca najmanje 3 mjeseca u intervalu
 . Naša je povijest bila ograničena na 19 mjeseci, pa smo odlučili uzeti razdoblje neaktivnosti od 6 mjeseci, ako je dostupno. A za minimalno razdoblje za kvalitetnu prognozu trebalo nam je 3 mjeseca. Brojke za 3 i 6 mjeseci uzeli smo empirijski na temelju analize ponašanja podataka kupaca.
Definiciju odljeva kupaca formulirali smo na sljedeći način: mjesec odljeva kupaca  ovo je prvi mjesec sa ACTIVE_FLAG=0, gdje od ovog mjeseca postoji najmanje šest uzastopnih nula u polju ACTIVE_FLAG, odnosno mjesec od kojeg je klijent bio neaktivan 6 mjeseci.
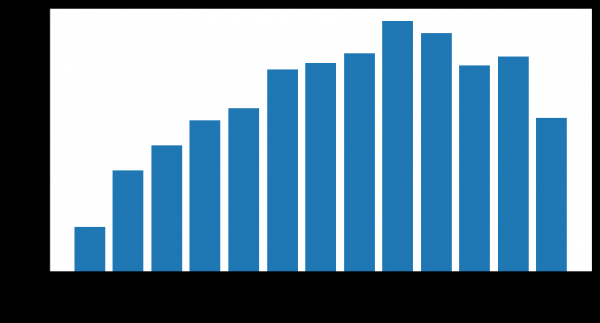
Broj klijenata koji su otišli
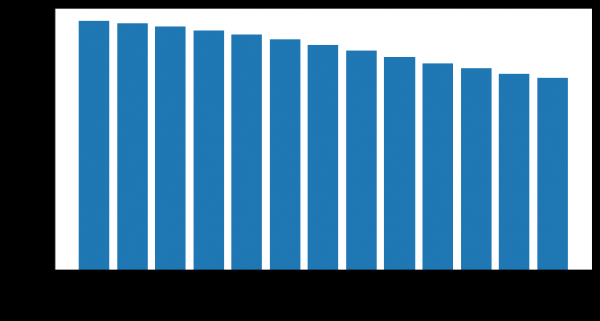
Broj preostalih klijenata
Kako se izračunava odljev?
U ovakvim natjecanjima, i općenito u praksi, često se na ovaj način predviđa odljev. Klijent koristi proizvode i usluge u različitim vremenskim razdobljima, podaci o interakciji s njim predstavljaju se kao vektor značajki fiksne duljine n. Najčešće te informacije uključuju:
- Podaci koji karakteriziraju korisnika (demografski podaci, marketinški segment).
- Povijest korištenja bankarskih proizvoda i usluga (to su radnje klijenata koje su uvijek vezane uz određeno vrijeme ili razdoblje intervala koji nam je potreban).
- Vanjski podaci, ako ih je bilo moguće dobiti - na primjer, recenzije s društvenih mreža.
I nakon toga, oni izvode definiciju odljeva, različitu za svaki zadatak. Zatim koriste algoritam strojnog učenja, koji predviđa vjerojatnost odlaska klijenta  na temelju vektora faktora
 . Za treniranje algoritma koristi se jedan od dobro poznatih okvira za konstruiranje ansambala stabala odlučivanja, , , ili njihove izmjene.
Sam algoritam nije loš, ali ima nekoliko ozbiljnih nedostataka kada je u pitanju predviđanje odljeva.
- On nema tzv. "pamćenje". Ulaz modela je određeni broj značajki koje odgovaraju trenutnoj točki u vremenu. Kako bi se pohranili podaci o povijesti promjena parametara, potrebno je izračunati posebne značajke koje karakteriziraju promjene parametara tijekom vremena, na primjer, broj ili iznos bankovnih transakcija u posljednja 1,2,3, XNUMX, XNUMX mjeseca. Ovaj pristup može samo djelomično odražavati prirodu privremenih promjena.
- Fiksni horizont predviđanja. Model može predvidjeti odlazak kupaca samo za unaprijed definirano vremensko razdoblje, na primjer, predviđanje mjesec dana unaprijed. Ako je potrebna prognoza za različito vremensko razdoblje, na primjer, tri mjeseca, tada morate ponovno izgraditi set za obuku i ponovno obučiti novi model.
Naš pristup
Odmah smo odlučili da nećemo koristiti standardne pristupe. Osim nas, na prvenstvo se prijavilo još 497 ljudi od kojih je svaki iza sebe imao poprilično iskustvo. Dakle, pokušavati učiniti nešto prema standardnoj shemi u takvim uvjetima nije dobra ideja.
I počeli smo rješavati probleme s kojima se suočava model binarne klasifikacije predviđanjem distribucije vjerojatnosti vremena prestanka kupca. Može se vidjeti sličan pristup , omogućuje vam fleksibilnije predviđanje odljeva i testiranje složenijih hipoteza nego u klasičnom pristupu. Kao obitelj distribucija koje modeliraju vrijeme odljeva, odabrali smo distribuciju za njegovu široku upotrebu u analizi preživljavanja. Ponašanje klijenta može se promatrati kao svojevrsno preživljavanje.
Evo primjera Weibullove distribucije gustoće vjerojatnosti ovisno o parametrima  и
 :
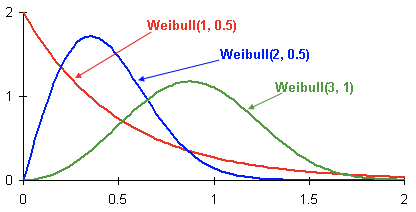
Ovo je funkcija gustoće vjerojatnosti odlaska triju različitih kupaca tijekom vremena. Vrijeme je prikazano u mjesecima. Drugim riječima, ovaj grafikon pokazuje kada će klijent najvjerojatnije odustati u sljedeća dva mjeseca. Kao što vidite, klijent s distribucijom ima veći potencijal ranijeg odlaska od klijenata s Weibullom (2, 0.5) i Weibullom (3,1) distribucije.
Rezultat je model koji, za svakog klijenta, za svakog
mjesec predviđa parametre Weibullove distribucije, koja najbolje odražava pojavu vjerojatnosti odljeva tijekom vremena. Detaljnije:
- Ciljne značajke na skupu za obuku su preostalo vrijeme do odlaska u određenom mjesecu za određenog klijenta.
- Ako ne postoji stopa prestanka kupca, pretpostavljamo da je vrijeme prestanka veće od broja mjeseci od tekućeg mjeseca do kraja povijesti koju imamo.
- Korišteni model: rekurentna neuronska mreža s LSTM slojem.
- Kao funkciju gubitka koristimo negativnu funkciju logaritma vjerojatnosti za Weibullovu distribuciju.
Evo prednosti ove metode:
- Distribucija vjerojatnosti, osim očite mogućnosti binarne klasifikacije, omogućuje fleksibilno predviđanje raznih događaja, primjerice, hoće li klijent prestati koristiti usluge banke unutar 3 mjeseca. Također, ako je potrebno, razne metrike mogu biti prosječne u ovoj distribuciji.
- LSTM rekurentna neuronska mreža ima memoriju i učinkovito koristi cjelokupnu dostupnu povijest. Kako se priča širi ili pročišćava, točnost se povećava.
- Pristup se može lako skalirati kada se vremenska razdoblja dijele na manja (na primjer, kada se mjeseci dijele na tjedne).
Ali nije dovoljno stvoriti dobar model, potrebno je i pravilno procijeniti njegovu kvalitetu.
Kako je ocijenjena kvaliteta?
Odabrali smo Lift Curve kao metriku. Koristi se u poslovanju za takve slučajeve zbog jasnog tumačenja, dobro je opisan и . Ako značenje ove metrike opišete u jednoj rečenici, to bi bilo "Koliko puta algoritam daje najbolje predviđanje u prvom  % nego nasumično."
Modeli treninga
Uvjetima natječaja nije uspostavljena posebna metrika kvalitete po kojoj bi se mogli usporediti različiti modeli i pristupi. Štoviše, definicija odljeva može biti različita i može ovisiti o iskazu problema, koji je pak određen poslovnim ciljevima. Stoga, kako bismo razumjeli koja je metoda bolja, obučili smo dva modela:
- Često korišteni pristup binarne klasifikacije koji koristi algoritam strojnog učenja skupnog stabla odlučivanja ();
- Weibull-LSTM model
Skup za testiranje sastojao se od 500 unaprijed odabranih klijenata koji nisu bili u skupu za obuku. Hiper-parametri odabrani su za model korištenjem unakrsne provjere, raščlanjeni prema klijentu. Isti skupovi značajki korišteni su za obuku svakog modela.
S obzirom na to da model nema memoriju, za njega su uzete posebne značajke koje pokazuju omjer promjena parametara za jedan mjesec i prosječne vrijednosti parametara u posljednja tri mjeseca. Ono što karakterizira stopu promjene vrijednosti u posljednja tri mjeseca. Bez toga, model temeljen na Random Forestu bio bi u nepovoljnijem položaju u odnosu na Weibull-LSTM.
Zašto je LSTM s Weibullovom distribucijom bolji od pristupa skupnog stabla odlučivanja
Ovdje je sve jasno na samo par slika.
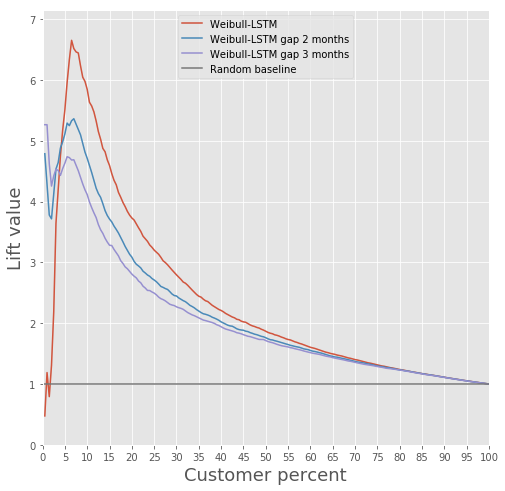
Usporedba krivulje uzgona za klasični algoritam i Weibull-LSTM
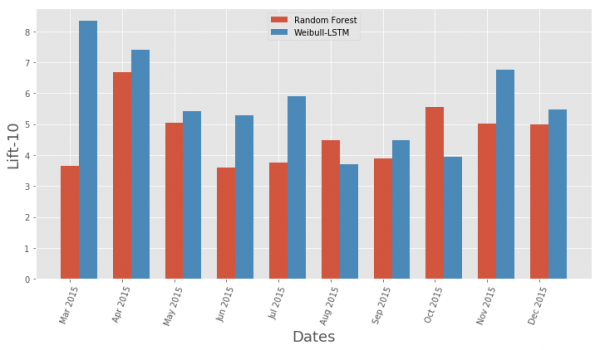
Usporedba metrike krivulje porasta po mjesecima za klasični algoritam i Weibull-LSTM
Općenito, LSTM je superiorniji od klasičnog algoritma u gotovo svim slučajevima.
Predviđanje odljeva
Model koji se temelji na rekurentnoj neuronskoj mreži s LSTM ćelijama s Weibullovom distribucijom može unaprijed predvidjeti odljev korisnika, na primjer, predvidjeti odlazak kupaca unutar sljedećih n mjeseci. Razmotrimo slučaj za n = 3. U ovom slučaju, za svaki mjesec, neuronska mreža mora ispravno odrediti hoće li klijent otići, počevši od sljedećeg mjeseca pa do n-tog mjeseca. Drugim riječima, mora ispravno odrediti hoće li kupac ostati nakon n mjeseci. To se može smatrati prognozom unaprijed: predviđanje trenutka kada je klijent tek počeo razmišljati o odlasku.
Usporedimo krivulju porasta za Weibull-LSTM 1, 2 i 3 mjeseca prije odljeva:
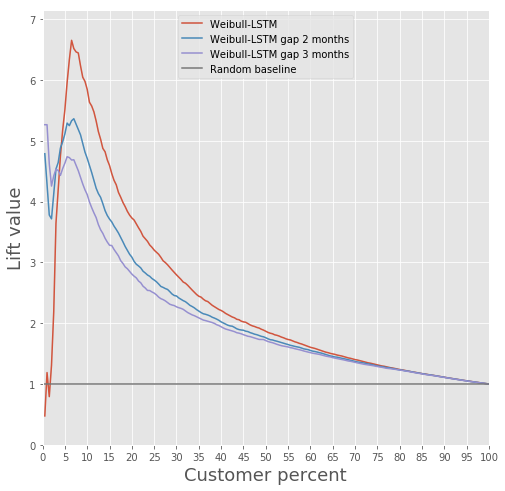
Gore smo već napisali da su važne i prognoze za klijente koji više nisu aktivni neko vrijeme. Stoga ćemo ovdje uzorku dodati takve slučajeve kada je korisnik koji je otišao već bio neaktivan jedan ili dva mjeseca, te provjeriti klasificira li Weibull-LSTM takve slučajeve ispravno kao odljev. Budući da su takvi slučajevi bili prisutni u uzorku, očekujemo da će se mreža dobro nositi s njima:
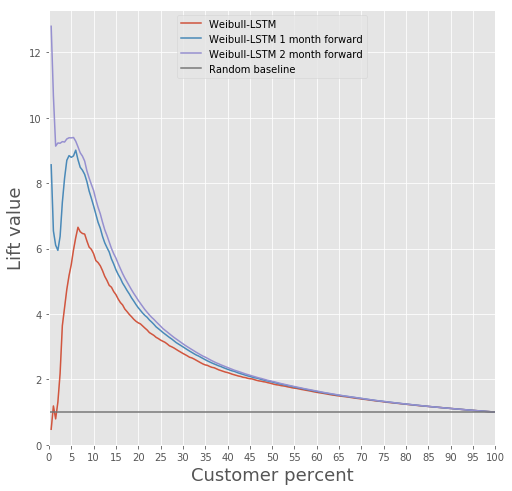
Zadržavanje kupaca
Zapravo, to je glavna stvar koja se može učiniti, imajući pri ruci informaciju da se takvi i takvi klijenti spremaju prestati koristiti proizvod. Govoreći o izgradnji modela koji bi mogao ponuditi nešto korisno kupcima kako bi ih zadržali, to se ne može učiniti ako nemate povijest sličnih pokušaja koji bi dobro završili.
Mi nismo imali takvu priču, pa smo odlučili ovako.
- Gradimo model koji identificira zanimljive proizvode za svakog klijenta.
- Svaki mjesec pokrećemo klasifikator i identificiramo kupce koji potencijalno odlaze.
- Nekim klijentima nudimo proizvod, prema modelu iz točke 1. i zapamtite naše akcije.
- Nakon nekoliko mjeseci gledamo tko je od tih potencijalno odlazećih klijenata otišao, a tko ostao. Tako formiramo uzorak za obuku.
- Model treniramo pomoću povijesti dobivene u koraku 4.
- Po želji ponavljamo postupak, zamjenjujući model iz koraka 1 modelom dobivenim u koraku 5.
Test kvalitete takvog zadržavanja može se napraviti redovitim A/B testiranjem - kupce koji potencijalno odlaze dijelimo u dvije skupine. Jednome nudimo proizvode na temelju našeg modela zadržavanja, a drugome ne nudimo ništa. Odlučili smo trenirati model koji bi mogao biti koristan već u točki 1 našeg primjera.
Htjeli smo učiniti segmentaciju što je moguće razumljivijom. Da bismo to učinili, odabrali smo nekoliko značajki koje je lako protumačiti: ukupan broj transakcija, plaće, ukupni promet na računu, dob, spol. Značajke iz tablice „Karte“ nisu uzete u obzir kao neinformativne, a značajke iz tablice 3 „Ugovori“ nisu uzete u obzir zbog složenosti obrade kako bi se izbjeglo curenje podataka između validacijskog skupa i skupa za obuku.
Grupiranje je provedeno korištenjem Gaussovih modela mješavina. Akaike informacijski kriterij omogućio nam je da odredimo 2 optimuma. Prvi optimum odgovara 1 klasteru. Drugi optimum, manje izražen, odgovara 80 klastera. Na temelju ovog rezultata možemo izvući sljedeći zaključak: izuzetno je teško podijeliti podatke u klastere bez unaprijed zadanih informacija. Za bolje klasteriranje potrebni su vam podaci koji detaljno opisuju svakog klijenta.
Stoga je razmatran problem učenja pod nadzorom kako bi se svakom pojedinom klijentu ponudio drugačiji proizvod. Razmatrani su sljedeći proizvodi: “Oročeni depozit”, “Kreditna kartica”, “Overdraft”, “Potrošački kredit”, “Kredit za automobil”, “Hipoteka”.
Podaci su uključivali još jednu vrstu proizvoda: „Tekući račun“. Ali nismo ga uzeli u obzir zbog niskog sadržaja informacija. Za korisnike koji su klijenti banke, tj. nisu prestali koristiti njegove proizvode, izgrađen je model za predviđanje koji bi ih proizvod mogao zanimati. Kao model odabrana je logistička regresija, a kao metrika procjene kvalitete korištena je vrijednost porasta za prvih 10 percentila.
Kvaliteta modela može se procijeniti na slici.
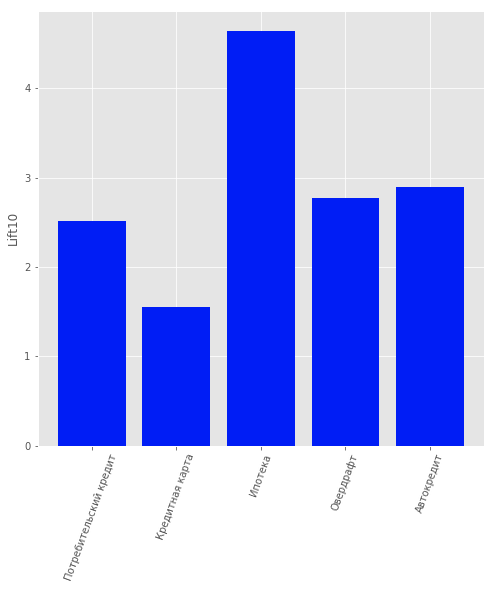
Rezultati modela preporuke proizvoda za kupce
Ukupan
Ovaj pristup donio nam je prvo mjesto u kategoriji “AI u bankama” na RAIF-Challenge 2017 AI prvenstvu.
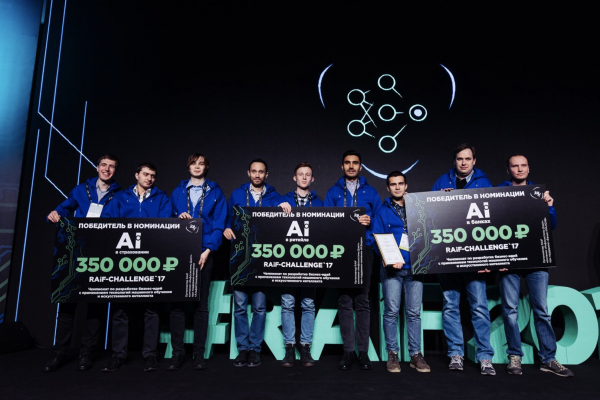
Očigledno, glavno je bilo pristupiti problemu iz nekonvencionalnog kuta i koristiti metodu koja se inače koristi za druge situacije.
Iako bi masovni odljev korisnika mogao biti prirodna katastrofa za usluge.
Ova metoda se može uzeti u obzir za bilo koje drugo područje gdje je važno uzeti u obzir odljev, ne samo banke. Njime smo, primjerice, izračunali vlastiti odljev - u sibirskim i peterburškim podružnicama Rostelecoma.
"Data Mining Laboratory" tvrtka "Traži portal "Sputnik"
Izvor: www.habr.com
