

Prijevod članka pripremljen je uoči početka tečaja .
Kako uštedjeti na troškovima oblaka pri radu s Kubernetesom? Ne postoji jedinstveno pravo rješenje, ali ovaj članak opisuje nekoliko alata koji vam mogu pomoći da učinkovitije upravljate svojim resursima i smanjite troškove računalstva u oblaku.
Napisao sam ovaj članak imajući na umu Kubernetes za AWS, ali on će se primjenjivati (gotovo) na isti način na druge pružatelje usluga oblaka. Pretpostavljam da vaši klasteri već imaju konfigurirano automatsko skaliranje (). Uklanjanje resursa i smanjivanje vaše implementacije samo će vam uštedjeti novac ako također smanji vašu flotu radnih čvorova (EC2 instance).
Ovaj članak će obuhvatiti:
- čišćenje neiskorištenih resursa ()
- Smanjite skaliranje u neradno vrijeme ()
- koristeći horizontalno automatsko skaliranje (HPA),
- smanjenje prekomjerne rezervacije resursa (, VPA)
- koristeći Spot instance
Čišćenje neiskorištenih resursa
Raditi u brzom okruženju je sjajno. Želimo tehnološke organizacije . Brža isporuka softvera također znači više implementacija PR-a, okruženja za pregled, prototipova i analitičkih rješenja. Sve je raspoređeno na Kubernetesu. Tko ima vremena za ručno čišćenje testnih implementacija? Lako je zaboraviti na brisanje eksperimenta starog tjedan dana. Račun za oblak na kraju će porasti zbog nečega što smo zaboravili zatvoriti:
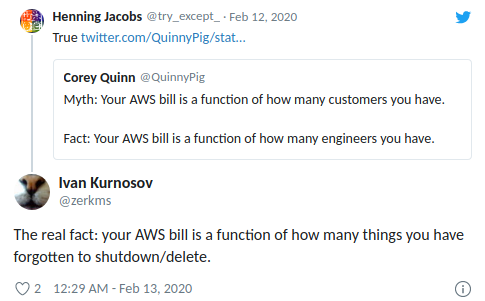
(Henning Jacobs:
Zhiza:
(navodnici) Corey Quinn:
Mit: Vaš AWS račun je funkcija broja korisnika koje imate.
Činjenica: Vaš AWS rezultat je funkcija broja inženjera koje imate.
Ivan Kurnosov (odgovara):
Prava činjenica: Vaš AWS rezultat je funkcija broja stvari koje ste zaboravili onemogućiti/izbrisati.)
(kube-domar) pomaže u čišćenju vašeg klastera. Konfiguracija domara je fleksibilna i za globalnu i za lokalnu upotrebu:
- Pravila na razini klastera mogu definirati maksimalno vrijeme života (TTL) za PR/test implementacije.
- Pojedinačni resursi mogu biti označeni s janitor/ttl, na primjer za automatsko uklanjanje šiljka/prototipa nakon 7 dana.
Opća pravila definirana su u YAML datoteci. Njegov put se propušta kroz parametar --rules-file u kube-domar. Ovdje je primjer pravila za uklanjanje svih imenskih prostora -pr- na ime nakon dva dana:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Sljedeći primjer regulira upotrebu oznake aplikacije na modulima Deployment i StatefulSet za sve nove Deployments/StatefulSet-ove u 2020., ali u isto vrijeme dopušta izvođenje testova bez ove oznake tjedan dana:
- id: require-application-label
  # удалить deployments и statefulsets без метки "application"
  resources:
    - deployments
    - statefulsets
  # см. http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Pokrenite vremenski ograničenu demo verziju od 30 minuta na klasteru koji pokreće kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Još jedan izvor povećanja troškova su trajni volumeni (AWS EBS). Brisanjem Kubernetes StatefulSeta ne brišu se njegovi trajni volumeni (PVC - PersistentVolumeClaim). Neiskorišteni EBS volumeni mogu lako rezultirati troškovima od stotina dolara mjesečno. Kubernetes Janitor ima značajku čišćenja neiskorištenog PVC-a. Na primjer, ovo pravilo će ukloniti sve PVC-ove koje nije montirao modul i na koje ne upućuje StatefulSet ili CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor može vam pomoći da svoj klaster održite čistim i spriječite polagano gomilanje troškova računalstva u oblaku. Slijedite upute za implementaciju i konfiguraciju .
Smanjite stvaranje kamenca u neradno vrijeme
Sustavi za testiranje i postavljanje obično su potrebni za rad samo tijekom radnog vremena. Neke proizvodne aplikacije, kao što su back office/administratorski alati, također zahtijevaju samo ograničenu dostupnost i mogu se onemogućiti preko noći.
(kube-downscaler) omogućuje korisnicima i operaterima smanjenje sustava tijekom neradnog vremena. Implementacije i StatefulSetovi mogu se skalirati na nula replika. CronJobs može biti suspendiran. Kubernetes Downscaler je konfiguriran za cijeli klaster, jedan ili više imenskih prostora ili pojedinačne resurse. Možete postaviti ili "vrijeme mirovanja" ili, obrnuto, "vrijeme rada". Na primjer, kako biste smanjili stvaranje kamenca što je više moguće tijekom noći i vikenda:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # не отключать компоненты инфраструктуры
  - --exclude-namespaces=kube-system,infra
  # не отключать kube-downscaler, а также оставить Postgres Operator, чтобы исключенными БД можно было управлять
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Ovdje je grafikon za skaliranje radnih čvorova klastera vikendom:
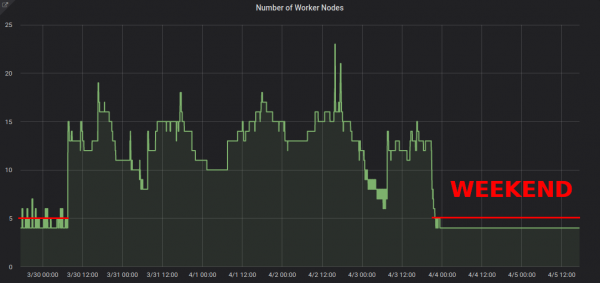
Smanjenje s ~13 na 4 radnička čvora svakako čini primjetnu razliku u vašem AWS računu.
Ali što ako trebam raditi tijekom "prekida rada" klastera? Određene implementacije mogu se trajno isključiti iz skaliranja dodavanjem napomene downscaler/exclude: true. Implementacije se mogu privremeno isključiti korištenjem napomene downscaler/exclude-until s apsolutnom vremenskom oznakom u formatu GGGG-MM-DD HH:MM (UTC). Ako je potrebno, cijeli se klaster može smanjiti uvođenjem modula s napomenom downscaler/force-uptime, na primjer, pokretanjem nginx blank:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # удалить развертывание через час
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Vidjeti , ako ste zainteresirani za upute za implementaciju i dodatne opcije.
Koristite horizontalno automatsko skaliranje
Mnoge aplikacije/usluge rade s dinamičkim obrascem učitavanja: ponekad su njihovi moduli u stanju mirovanja, a ponekad rade punim kapacitetom. Upravljanje stalnom flotom kapsula za izlaženje na kraj s maksimalnim vršnim opterećenjem nije ekonomično. Kubernetes podržava horizontalno automatsko skaliranje preko resursa (HPA). Upotreba CPU-a često je dobar pokazatelj za skaliranje:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando je stvorio komponentu za jednostavno povezivanje prilagođenih metrika za skaliranje: (kube-metrics-adapter) je generički metrički adapter za Kubernetes koji može prikupljati i posluživati prilagođene i vanjske metrike za horizontalno automatsko skaliranje podova. Podržava skaliranje na temelju Prometheusove metrike, SQS redova čekanja i drugih postavki. Na primjer, da skalirate svoju implementaciju na prilagođenu metriku koju predstavlja sama aplikacija kao JSON u /metrics, koristite:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.<metricType>.<metricName>.<collectorName>/<configKey>
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Konfiguriranje vodoravnog automatskog skaliranja s HPA-om trebala bi biti jedna od zadanih radnji za poboljšanje učinkovitosti usluga bez stanja. Spotify ima prezentaciju sa svojim iskustvom i preporukama za HPA: .
Smanjite prebukiranost resursa
Radna opterećenja Kubernetesa određuju njihove potrebe za procesorom/memorijom putem "zahtjeva za resurse". CPU resursi mjere se u virtualnim jezgrama ili češće u "milicoresima", na primjer 500m podrazumijeva 50% vCPU-a. Memorijski resursi se mjere u bajtovima, a mogu se koristiti uobičajeni sufiksi, kao što je 500Mi, što znači 500 megabajta. Zahtjevi za resursima "zaključavaju" kapacitet na radnim čvorovima, što znači da će pod sa zahtjevom za CPU od 1000m na čvoru s 4 vCPU-a ostaviti samo 3 vCPU-a dostupnim drugim podovima.
Slab (višak rezerve) je razlika između traženih resursa i stvarne upotrebe. Na primjer, pod koji zahtijeva 2 GiB memorije, ali koristi samo 200 MiB ima ~1,8 GiB "viška" memorije. Višak košta. Može se grubo procijeniti da 1 GiB redundantne memorije košta ~10 USD mjesečno.
(kube-resource-report) prikazuje višak rezervi i može vam pomoći da odredite potencijal uštede:
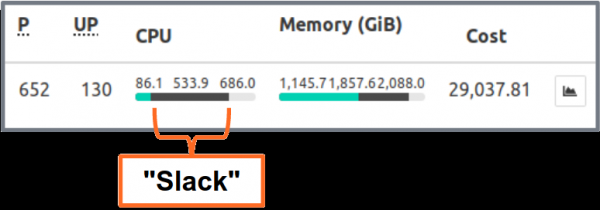
prikazuje višak agregiran primjenom i naredbom. To vam omogućuje da pronađete mjesta gdje se zahtjevi za resursima mogu smanjiti. Generirano HTML izvješće pruža samo snimku korištenja resursa. Trebali biste pogledati korištenje procesora/memorije tijekom vremena kako biste odredili odgovarajuće zahtjeve za resursima. Evo grafikona Grafana za "tipičnu" uslugu s puno CPU-a: sve jedinice koriste znatno manje od 3 tražene CPU jezgre:
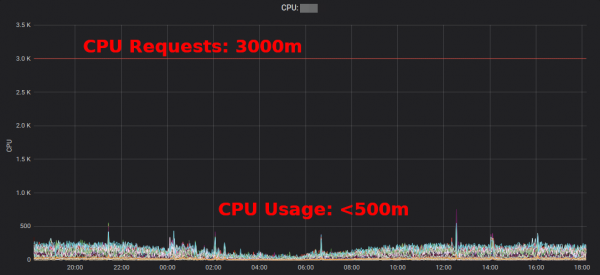
Smanjenje CPU zahtjeva s 3000m na ~400m oslobađa resurse za druga radna opterećenja i omogućuje da klaster bude manji.
"Prosječna upotreba CPU-a EC2 instanci često se kreće u jednoznamenkastom postotku," . Dok za EC2 Promjena nekih upita Kubernetes resursa u YAML datoteci jednostavna je i može donijeti velike uštede.
Ali želimo li stvarno da ljudi mijenjaju vrijednosti u YAML datotekama? Ne, strojevi to mogu puno bolje! Kubernetes (VPA) čini upravo to: prilagođava zahtjeve za resursima i ograničenja prema radnom opterećenju. Evo primjera grafikona Prometheus CPU zahtjeva (tanka plava linija) prilagođenih VPA-om tijekom vremena:
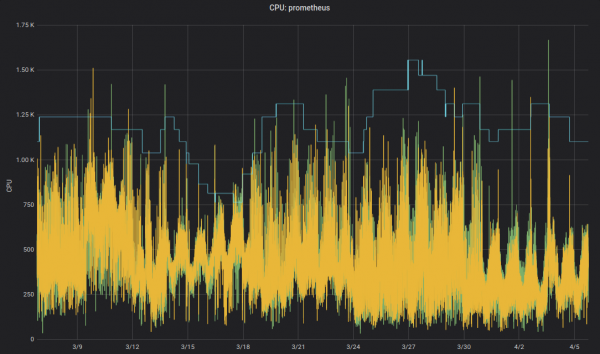
za komponente infrastrukture. Nekritične aplikacije također mogu koristiti VPA.
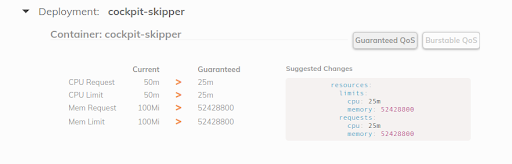
iz Fairwinda je alat koji stvara VPA za svaku implementaciju u prostoru imena, a zatim prikazuje VPA preporuku na svojoj nadzornoj ploči. Može pomoći programerima da postave ispravne CPU/memorijske zahtjeve za svoje aplikacije:
Napisao sam malu 2019., a nedavno u .
Korištenje EC2 spot instanci
Posljednje, ali ne i najmanje važno, troškovi AWS EC2 mogu se smanjiti korištenjem Spot instanci kao Kubernetes radnih čvorova . Spot instance dostupne su uz popust do 90% u usporedbi s cijenama na zahtjev. Pokretanje Kubernetesa na EC2 Spotu dobra je kombinacija: trebate navesti nekoliko različitih vrsta instanci za veću dostupnost, što znači da možete dobiti veći čvor za istu ili nižu cijenu, a povećani kapacitet mogu koristiti Kubernetes radna opterećenja u kontejnerima.
Kako pokrenuti Kubernetes na EC2 Spot? Postoji nekoliko opcija: upotrijebite uslugu treće strane kao što je SpotInst (sada se zove "Spot", ne pitajte me zašto) ili jednostavno dodajte Spot AutoScalingGroup (ASG) u svoj klaster. Na primjer, ovdje je CloudFormation isječak za Spot ASG "optimiziran kapacitetom" s više vrsta instanci:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Neke napomene o korištenju Spot-a s Kubernetesom:
- Morate rukovati Spot prekidima, na primjer spajanjem čvora kada je instanca zaustavljena
- Zalando koristi službeno automatsko skaliranje klastera s prioritetima skupa čvorova
- Spot čvorovi prihvatiti "registracije" radnih opterećenja za pokretanje u Spotu
Rezime
Nadam se da će vam neki od predstavljenih alata biti korisni za smanjenje vašeg računa za oblak. Većinu sadržaja članka također možete pronaći na .
Koje su vaše najbolje prakse za uštedu troškova oblaka na Kubernetesu? Javite mi na .
Zapravo, manje od 3 vCPU-a će ostati upotrebljivo jer je propusnost čvora smanjena zbog rezerviranih resursa sustava. Kubernetes razlikuje kapacitet fizičkog čvora i "dodijeljene" resurse ().
Primjer izračuna: jedna m5.large instanca s 8 GiB memorije iznosi ~84 $ mjesečno (eu-central-1, On-Demand), tj. blokiranje 1/8 čvora je otprilike ~$10/mjesečno.
Postoji mnogo više načina da smanjite svoj EC2 račun, kao što su rezervirane instance, plan štednje itd. - Neću ovdje pokrivati te teme, ali svakako biste ih trebali pogledati!
Izvor: www.habr.com
