

U ovom članku ću govoriti o tome kako se projekt na kojem radim pretvorio iz velike monolite u skup mikroservisa.
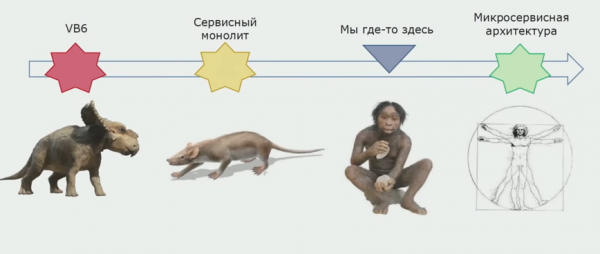
Projekt je započeo svoju povijest davno, početkom 2000-ih. Prve verzije napisane su u Visual Basic 6. S vremenom je postalo jasno da će razvoj na ovom jeziku biti teško održavati, jer se IDE i sam jezik slabo razvijaju. Krajem 2000-ih odlučeno je prelazak na perspektivniji C#. Nova verzija se pisala paralelno s doradom stare, a postepeno je sve više koda bilo na .NET. Backend na C# je prvotno bio orijentiran na servisnu arhitekturu, ali su se prilikom razvoja koristile zajedničke biblioteke s logikom, a servisi su se pokretali u jedinstvenom procesu. Tako je nastala aplikacija koju smo nazivali "servisni monolit".
Jedna od rijetkih prednosti takve povezanosti bila je mogućnost da servisi pozivaju jedni druge preko vanjskog API-ja. Postojale su jasne pretpostavke za prelazak na ispravniju servisnu, a u budućnosti i mikroservisnu arhitekturu.
Svoj posao na dekompoziciji započeli smo otprilike 2015. godine. Iako još nismo postigli idealno stanje - ostali su dijelovi velikog projekta koje je već teško nazvati monolitima, ali ni na mikroservise ne izgledaju. Unatoč tome, napredak je značajan.
O tome ću pisati u članku.
Sadržaj
Arhitektura i problemi postojećeg rješenja
Prvotna arhitektura izgledala je ovako: UI — odvojena aplikacija, monolitni dio napisan u Visual Basic 6, aplikacija na .NET predstavljala je niz povezanih servisa koji rade s dovoljno velikom bazom podataka.
Nedostaci prijašnjeg rješenja
Jedinstvena tačka greške
Imali smo jedinstvenu tačku otkaza: aplikacija na .NET je radila u jednom procesu. Ako bi došlo do kvara u bilo kojem od modula, cela aplikacija bi se srušila i morali bismo je ponovo pokrenuti. Kako automatizujemo veliki broj procesa za različite korisnike, usled kvara u jednom od njih, svi su na neko vreme prestali raditi. Čak ni rezervisanje nije pomoglo kod programskih grešaka.
Lista promjena
Ova nijansa je pretežno organizacijska. U našoj aplikaciji postoji mnogo korisnika, i svi žele da je nadograde što je brže moguće. Ranije je bilo nemoguće uraditi to istovremeno, pa su se svi korisnici povlačili u red. Ovaj proces izazivao je negativne reakcije u poslovanju, jer su morali dokazivati da njihovi zahtevi imaju vrednost. Razvojni tim je trošio vreme na organizaciju tog reda. To je oduzimalo mnogo vremena i resursa, a proizvod nije mogao da se menja onako brzo kako su to želeli.
Neoptimalno korišćenje resursa
Prilikom postavljanja servisa u jedinstvenom procesu, uvek smo u potpunosti kopirali konfiguraciju sa servera na server. Želeli smo da postavimo najopterećenije servise odvojeno, kako bismo izbegli prokletstvo resursa i dobili fleksibilniju kontrolu nad našom razvojnom šemom.
Težak unos modernih tehnologija
Poznata svima problematika među programerima: postoji želja da se u projekt unesu moderne tehnologije, ali nema mogućnosti. U velikim monolitnim rešenjima, svaka nadogradnja trenutne biblioteke, ne govorimo o prelazu na novu, postaje poprilično složena stvar. Potrebno je dugo ubeđivati tim lidera da će doneti više benefita nego što će biti potrošeno nerava.
Složenost isporuke promena
Ovo je bio najteži problem – imali smo izdanja svaka dva meseca.
Svako izdanje je postajalo prava katastrofa za banku, uprkos testiranju i naporima programera. Poslovanje je shvatilo da na početku nedelje neće raditi deo funkcionalnosti. A programeri su znali da ih čeka nedelja ozbiljnih incidenata.
Svi su želeli da promene situaciju.
Očekivanja od mikroservisa
Isporuka komponenti prema spremnosti. Isporuka komponenti prema spremnosti zahvaljujući dekompoziciji rešenja i odvojenim procesima.
Mali produktni timovi. To je važno jer je s velikim timom koji radi na starom monolitu teško upravljati. Takav tim bio je primoran raditi po strogom postupku, dok su željeli više kreativnosti i neovisnosti. To su si mogli priuštiti samo mali timovi.
Izolacija servisa u zasebnim procesima. Idealan bi scenarij bio izolirati servise u kontejnerima, ali velik broj servisa napisanih na .NET Frameworku radi samo na Windowsu. Posljednjih se godina pojavljuju servisi na .NET Core, ali ih još uvijek nema mnogo.
Fleksibilnost implementacije. Željeli bismo kombinirati servise onako kako mi to želimo, a ne kako kod to zahtijeva.
Korištenje novih tehnologija. To je zanimljivo svakom programeru.
Problemi prelaska
Naravno, ako bi bilo lako razbiti monolit na mikrosservise, o tome se ne bi govorilo na konferencijama i pisale bi se članke. U ovom procesu ima mnogo zamki, opisat ću glavne koje su nam pravile probleme.
Prvi problem tipično za većinu monolita: povezanost poslovne logike. Kada pišemo monolit, želimo ponovo koristiti naše klase kako bismo izbjegli suvišan kod. Prijelazom na mikrosservise to postaje problem: sav kod je dovoljno čvrsto povezan i teško je odvojiti servise.
U trenutku početka rada u repozitoriju je bilo više od 500 projekata i više od 700 tisuća linija koda. To je prilično veliko rješenje i drugi problem. Jednostavno je bilo nemoguće uzeti i podijeliti ga na mikrosservise.
Treći problem — nedostatak potrebne infrastrukture. U suštini, bavili smo se ručnim kopiranjem izvornih kodova na servere.
Kako preći od monolita do mikroservisa
Izdvajanje mikrosservisa
Prvo, odmah smo sebi odredili da je razdvajanje mikrosservisa iterativan proces. Uvijek su od nas tražili da istovremeno radimo na razvoju poslovnih zadataka. Kako ćemo to tehnički realizirati — to je već naš problem. Stoga smo se pripremali za iterativni proces. Na drugi način ne može kada imate veliku aplikaciju koja nije prvotno pripremljena za prepisivanje.
Koje načine koristimo za izdvajanje mikrosservisa?
Prvi način — izdvajanje postojećih modula kao usluga. U tom pogledu smo imali sreće: već su postojale usluge koje su radile na WCF protokolu. Bile su raspoređene u zasebnim paketima. Premještali smo ih odvojeno, dodajući maleni pokretački modul svakom paketu. Napravljen je uz pomoć sjajne biblioteke Topshelf, koja omogućava pokretanje aplikacije kao usluge ili kao konzolnog programa. Ovo je praktično za otklanjanje grešaka, jer nije potrebno dodatne projekte unutar rješenja.
Usluge su bile povezane poslovnom logikom, jer su koristile zajedničke pakete i radile s zajedničkom bazom podataka. Teško ih je bilo nazvati čistim mikrouslužbama. Ipak, mogli smo te usluge izdavati odvojeno, u različitim procesima. To je već smanjilo utjecaj jednih na druge, smanjujući problem paralelne izrade i jedinstvene tačke kvara.
Paketa s hostom je samo jedna linija koda u klasi Program. Rad s Topshelf-om smo sakrili u pomoćnu klasu.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
Drugi način izdvajanja mikrouslužbi: izraditi ih za rješavanje novih zadataka. Ako pritom monolit ne raste, to je već odlično, znači da idemo u pravom smjeru. Za rješavanje novih zadataka nastojali smo praviti posebne usluge. Ako je bila mogućnost, stvarali smo usluge koje su „kanonične“, što potpuno upravljaju svojim modelom podataka, odvojenom bazom podataka.
Mi, kao i mnogi, počeli smo s uslugama za autentifikaciju i autorizaciju. One su savršene za to. Nezavisne su, obično imaju odvojen model podataka. Same ne komuniciraju s monolitom, već se on obraća njima za rješavanje određenih zadataka. Na ovim uslugama možemo započeti prijelaz na novu arhitekturu, testirati infrastrukturu, isprobati neke pristupe povezane s mrežnim bibliotekama itd. U našoj organizaciji nema timova koji ne bi uspjeli napraviti uslugu autentifikacije.
Treći način izdvajanja mikrouslužbi, koji koristimo, pomalo je specifičan za nas. To je izdvajanje poslovne logike iz UI sloja. Naša glavna UI aplikacija je desktop aplikacija, koja je, kao i backend, napisana u C#. Programeri povremeno griješe i iznose na UI dijelove logike koji bi trebali postojati u backendu i ponovo se koristiti.
Ako pogledamo stvarni primjer iz koda UI dijela, jasno je da veći dio ovog rješenja sadrži pravu poslovnu logiku, koja je korisna u drugim procesima, ne samo za izgradnju UI obrasca.
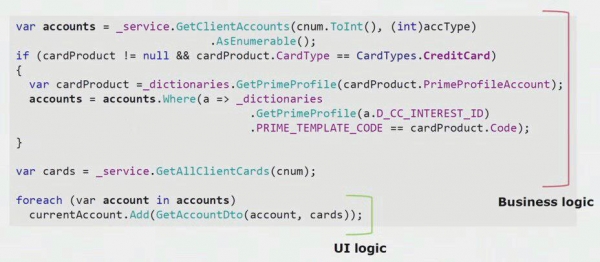
Stvarne logike UI tu je samo posljednjih nekoliko redaka. Premjestili smo je na server kako bismo omogućili ponovnu upotrebu, smanjujući tako UI i postižući ispravnu arhitekturu.
Četvrti, najvažniji način izdvajanja mikroservisa, koji također omogućava smanjenje monolita, jeste izdvajanje postojećih servisa s preradom. Kada postojeće module izdvojimo onakve kakvi jesu, rezultat ne sviđa uvijek programerima, a poslovni proces od vremena stvaranja funkcionalnosti mogao je zastarjeti. Zahvaljujući refaktoringu, možemo podržati novi poslovni proces, jer se zahtjevi poslovanja neprestano mijenjaju. Možemo poboljšati izvorni kod, ukloniti poznate defekte, stvoriti kvalitetniji model podataka. Prikuplja se mnogo prednosti.
Izdvajanje servisa s preradom neodvojivo je povezano s pojmom ograničenog konteksta. Ovaj pojam dolazi iz predmetno-orijentiranog projektiranja. Znači odjeljak domenne modela, u kojem su svi pojmovi jedinstvenog jezika jednoznačno definirani. Razmotrimo primjer konteksta osiguranja i računa. Imamo monolitnu aplikaciju i potrebno je raditi sa računa u osiguranju. Očekujemo da će programer pronaći u drugoj biblioteci postojeću klasu „Račun“, napraviti referencu na nju iz klase „Osiguranje“, i dobit ćemo funkcionalni kod. Princip DRY bit će poštovan, zadatak će se uz pomoć postojećeg koda brže realizirati.
Na kraju se pokazuje da su kontekst računa i osiguranja povezani. Kada se pojave novi zahtjevi, ova veza će ometati razvoj, povećavajući složenost i onako složene poslovne logike. Da bismo riješili ovaj problem, potrebno je u kodu pronaći granice između konteksta i ukloniti njihova kršenja. Na primjer, kontekstu osiguranja, sasvim je moguće, bit će dovoljan 20-znamenkasti broj računa HNB-a i datum otvaranja računa.
Kako bismo odvojili te ograničene kontekste jedne od drugih i započeli proces izdvajanja mikroservisa iz monolitnog rješenja, koristili smo pristup stvaranja vanjskih API-ja unutar aplikacije. Ako smo znali da neki modul treba postati mikroservis, kako bi se promijenio u okviru procesa, odmah smo radili pozive logike koja pripada drugom ograničenom kontekstu, kroz vanjske pozive. Na primjer, putem REST-a ili WCF-a.
Čvrsto smo odlučili da nećemo izbjegavati kod koji zahtijeva obavljanje distribuiranih transakcija. U našem slučaju pokazalo se dovoljno lako pridržavati se ove pravilnosti. Do sada nismo naišli na situacije kada su stvarno potrebne stroge distribuirane transakcije — sasvim je dovoljno konačno usklađivanje između modula.
Razmotrimo konkretan primjer. Imamo pojam orkestratora — cijevi koja obrađuje entitet 'zahtjeva'. Redom stvara klijenta, račun i bankovnu karticu. Ako su klijent i račun uspješno kreirani, a kreiranje kartice nije uspjelo, zahtjev ne prelazi u status 'uspješno' i ostaje u statusu 'kartica nije kreirana'. U budućnosti će pozadinska aktivnost pokupiti to i završiti. Sustav je neko vrijeme u stanju nesuglasnosti, ali nas to, u cijelosti, zadovoljava.
U slučaju da se pojavi situacija kada će biti potrebno usklađeno sačuvati dio podataka, vjerojatno ćemo otići na povećanje servisa kako bismo obradili to u jednom procesu.
Razmotrimo primjer izdvajanja mikroservisa. Na koji način se može relativno sigurno dovesti do produkcije? U ovom primjeru imamo poseban dio sustava — modul obračuna plaća, jedan od dijelova koda koji bismo željeli učiniti mikroservisnim.
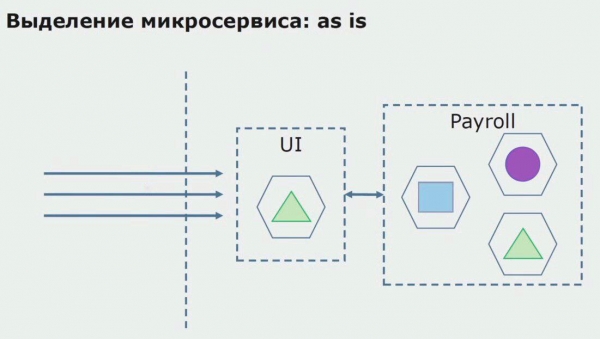
Prvo kreiramo mikroservis, prepisujući kod. Poboljšavamo određene aspekte koji nam nisu odgovarali. Provodimo nove poslovne zahtjeve od klijenta. Dodajemo API Gateway u vezu između UI-a i backend-a, koji će omogućiti prosljeđivanje poziva.
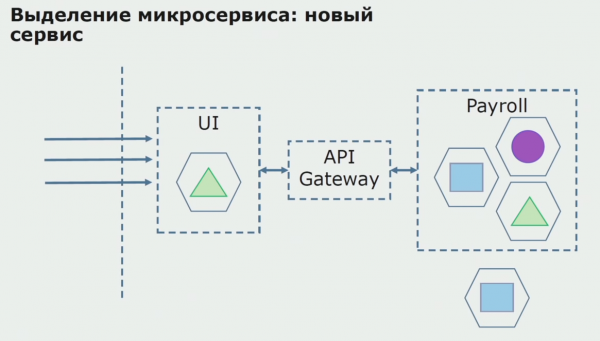
Zatim ovu konfiguraciju puštamo u pogon, ali u pilot stanju. Većina naših korisnika i dalje koristi stare poslovne procese. Za nove korisnike razvijamo novu verziju monolitne aplikacije koja više ne uključuje taj proces. U suštini, imamo vezu monolita i mikroservisa koja radi kao pilot.
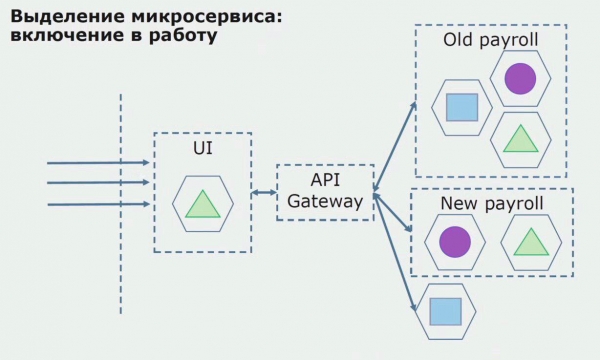
Ako imamo uspješan pilot, shvaćamo da nova konfiguracija doista radi i možemo ukloniti stari monolit te ostaviti novu konfiguraciju umjesto starog rješenja.
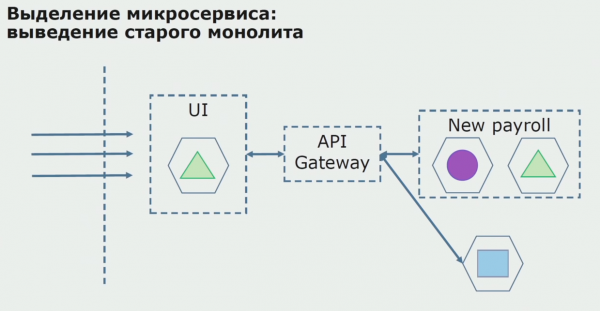
Dakle, koristimo gotovo sve postojeće metode za razdvajanje izvornog koda monolita. Sve one nam omogućuju smanjivanje veličine dijelova aplikacije i prijenos na nove biblioteke, čineći izvorni kod kvalitetnijim.
Rad s BDD-om
Baza podataka se teže razdvaja nego izvorni kod, jer sadrži ne samo trenutnu shemu, već i akumulirane povijesne podatke.
Naša baza podataka, kao i mnoge druge, imala je još jedan važan nedostatak — ogroman je veličinu. Ova baza podataka projektirana je prema složenoj poslovnoj logici monolita, a između tablica različitih ograničenih konteksta nastale su veze.
U našem slučaju, na kraju svih nevolja (velika baza podataka, brojne veze, ponekad nejasne granice između tablica) pojavila se problematika koja se susreće u mnogim velikim projektima: korištenje šablona shared database. Podaci su uzimani iz tablica preko view-a, replicirani i isporučivani u druge sustave gdje su bila potrebna ta replikacija. Kao rezultat toga, nismo mogli izdvojiti tablice u zasebnu shemu, jer su bile aktivno korištene.
U razdvajanju nam pomaže to isto razdvajanje na ograničene kontekste u kodu. Obično nam daje dovoljno dobar uvid u to kako razbijamo podatke na razini baze podataka. Razumijemo koje tablice pripadaju jednom ograničenom kontekstu, a koje drugom.
Primijenili smo dva globalna načina odvajanja baze podataka: odvajanje postojećih tablica i odvajanje s preradom.
Odvajanje postojećih tablica je metoda koja se dobro primjenjuje kada je struktura podataka kvalitetna, zadovoljava poslovne zahtjeve i svima odgovara. U tom slučaju možemo izdvojiti postojeće tablice u zasebnu shemu.
Odvajanje s preradom je potrebno kada se poslovni model značajno promijenio, a tablice više ne zadovoljavaju naše potrebe.
Odvajanje postojećih tablica. Moramo odrediti što ćemo odvajati. Bez tog znanja ništa neće funkcionirati, a ovdje nam može pomoći odvajanje ograničenih konteksta u kodu. Obično, ako uspijemo shvatiti granice konteksta u izvornoj kodu, postaje jasno koje tablice trebaju biti na popisu za odvajanje.
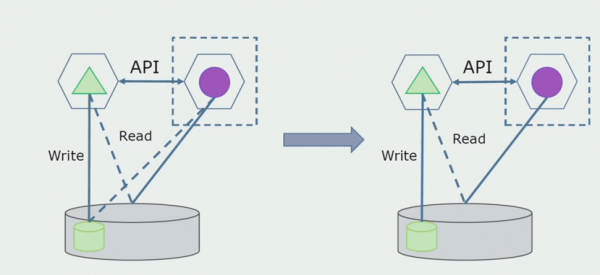
Zamislimo da imamo rješenje u kojem dva modula monolita komuniciraju s jednom bazom podataka. Moramo osigurati da samo jedan modul komunicira s dijelom odvojenih tablica, a drugi neka započne komunikaciju s njom preko API-ja. U početku je dovoljno da se preko API-ja vrši samo upis. Ovo je preduvjet da bismo mogli govoriti o neovisnosti mikroslužbi. Veze za čitanje mogu ostati, dok u tome nema velikih problema.
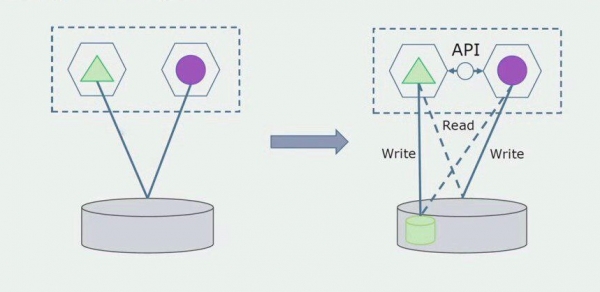
Sljedeći korak je da dio koda koji radi s odvojenim tablicama, s preradom ili bez nje, izdvojimo u zasebnu mikroslužbu i pokrenemo u zasebnom procesu, kontejneru. To će biti zasebna usluga s vezom prema bazi podataka monolita i onim tablicama koje se ne odnose izravno na njega. Monolit će još uvijek komunicirati za čitanje s odvojenom dijelom.
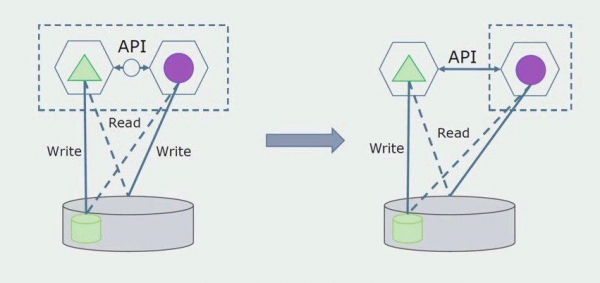
Kasnije ćemo ukloniti tu vezu, tj. čitanje podataka monolitne aplikacije iz odvojenih tablica također ćemo prevesti na API.
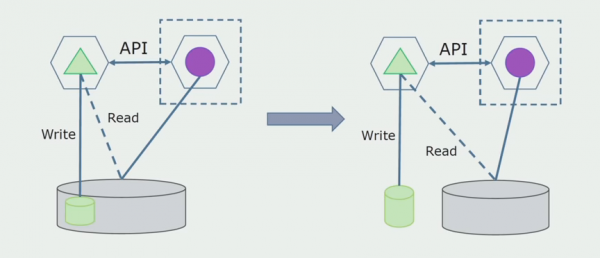
Nakon toga izdvojit ćemo iz zajedničke BDP tablice s kojima radi samo nova mikroslužba. Možemo premjestiti tablice u zasebnu shemu ili čak u zasebnu fizičku BDP. Ostala je veza za čitanje između mikroslužbe i BDP-a monolita, ali u tome nema ničega strašnog, u takvoj konfiguraciji on može opstati dovoljno dugo.
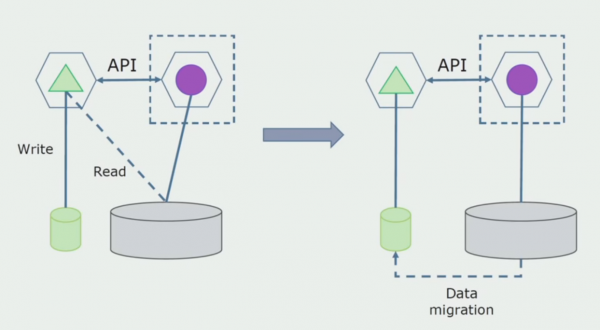
Posljednji korak je potpuno ukloniti sve veze. U tom slučaju, možda će nam trebati migracija podataka iz glavne baze. Ponekad želimo ponovo iskoristiti neke replicirane podatke ili referentne podatke iz vanjskih sustava u više baza. To se neprekidno događa.
Odjel za preradu. Ova metoda je vrlo slična prvoj, samo ide obrnutim redoslijedom. Odmah odvajamo novu bazu podataka i novu mikroservisnu jedinicu koja komunicira s monolitom putem API-ja. No, ostaje set tablica baze podataka koje želimo u budućnosti ukloniti. Više nam nisu potrebne, u novom modelu su zamijenjene.
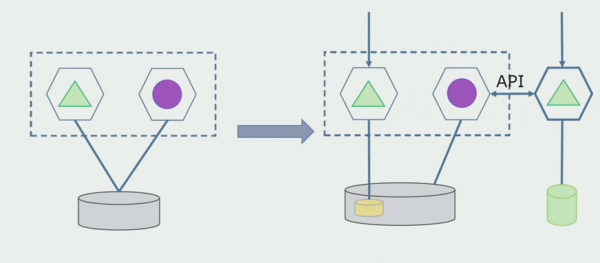
Kako bi ova shema radila, vjerojatno će nam trebati prijelazno razdoblje.
Dalje postoje dva moguća pristupa.
Prvi: dupliciramo sve podatke u novim i starim bazama. U tom slučaju dolazi do redundancije podataka, mogu se javiti problemi s sinkronizacijom. Međutim, možemo imati dva različita klijenta. Jedan će raditi s novom verzijom, drugi sa starom.
Drugi: dijelimo podatke prema nekom poslovnom kriteriju. Na primjer, imali smo 5 proizvoda koji su pohranjeni u staroj bazi podataka. Šesti u okviru nove poslovne zadaće stavljamo u novu bazu podataka. No, trebat će nam API Gateway koji će sinkronizirati te podatke i pokazati klijentu odakle i što treba uzeti.
Oba pristupa su funkcionalna, odaberite ovisno o situaciji.
Nakon što se uvjerimo da sve radi, dio monolita koji radi sa starim strukturama baze podataka može se isključiti.
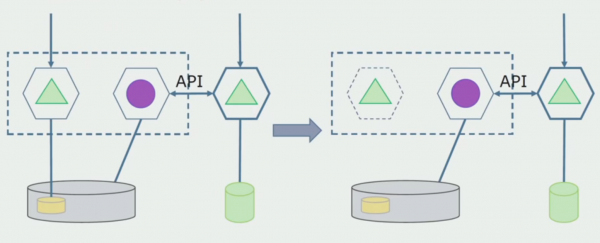
Zadnji korak će biti brisanje starih struktura podataka.
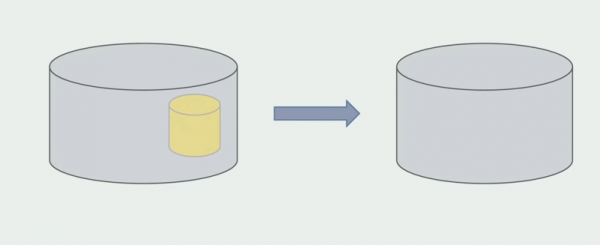
Zaključak je da imamo problema s bazama podataka: teško ih je koristiti u usporedbi s izvorom koda, teže ih je dijeliti, ali to se može i treba raditi. Pronašli smo neke načine koji omogućuju relativno sigurnu provedbu, jer je lako napraviti grešku s podacima nego s izvorom koda.
Rad s izvorni kodom
Ovako je izgledala shema izvornog koda kada smo počeli analizirati monolitni projekt.
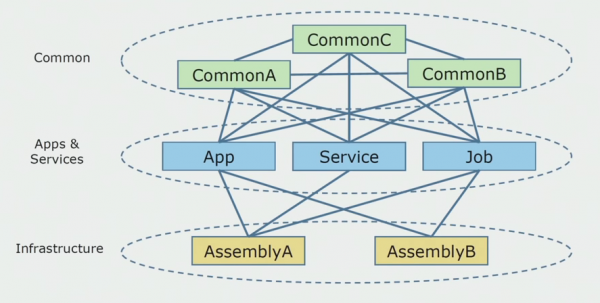
Može se uvjetno podijeliti na tri sloja. To je sloj pokrenutih modula, plug-inova, servisa i pojedinačnih aktivnosti. U suštini, to su bile ulazne točke unutar monolitnog rješenja. Sve su bile čvrsto povezane slojem Common. U njemu se nalazila poslovna logika koju su servisi zajednički koristili, te mnoštvo veze. Svaki servis i plug-in koristio je do 10 i više common biblioteka, ovisno o njihovoj veličini i savjesti programera.
Imali smo sreće, imali smo infrastrukturne biblioteke koje su se mogle koristiti zasebno.
Ponekad se događalo da neki Common objekti zapravo nisu pripadali ovom sloju, već su bili infrastrukturne biblioteke. To se rješavalo preimenovanjem.
Najviše brige izazivali su ograničeni konteksti. Ponekad su se 3-4 konteksta miješala u jednoj Common biblioteci i koristila jedni druge unutar istih poslovnih funkcija. Trebalo je shvatiti gdje se to može podijeliti i prema kojim granicama, te što dalje raditi s mapiranjem tog razdvajanja na biblioteke izvornog koda.
Formulirali smo nekoliko pravila za proces razdvajanja koda.
Prvo: više nismo htjeli zajedničko korištenje poslovne logike između servisa, aktivnosti i plug-inova. Željeli smo učiniti poslovnu logiku neovisnom unutar mikroservisa. S druge strane, mikroservisi bi, idealno, trebali biti smatrani servisima koji postoje potpuno neovisno. Smatram da je ovaj pristup pomalo rasipan, a i teško ga je postići, jer, na primjer, servisi napisani u C# će se ionako povezivati standardnom bibliotekom. Naš sustav je napisan u C#, druge tehnologije zasad nismo koristili. Stoga smo odlučili da si možemo priuštiti korištenje zajedničkih tehničkih biblioteka. Najvažnije je da u njima ne bude nikakvih fragmenata poslovne logike. Ako imate zgodnu omotnicu oko ORM-a koju koristite, tada je preseljenje iz servisa u servis vrlo skupo.
Naš tim je obožavatelj predmetno orijentiranog projektiranja, stoga nam je "lukova arhitektura" savršeno odgovarala. Temelj naših usluga nije bio sloj za pristup podacima, već skup s domenom logike koja sadrži samo poslovnu logiku i lišena je veza s infrastrukturom. Na ovaj način možemo neovisno razvijati domensku skupinu za rješavanje problema povezanih s okvirima.
U ovoj fazi susreli smo se s prvim ozbiljnim problemom. Usluga je trebala referencirati jednu domensku skupinu, dok smo željeli da logika bude neovisna, a tu nam je jako smetao princip DRY. Razvijatelji su željeli izbjeći dupliciranje ponovnim korištenjem klasa iz susjednih skupina, što je rezultiralo ponovnim povezivanjem domena. Analizirali smo rezultate i odlučili da možda problem leži i u strukturi skladišta izvornog koda. Imali smo veliki repozitorij u kojem su ležali svi izvorni kodovi. Rješenje za cijeli projekt vrlo je teško bilo sastaviti na lokalnom računalu. Stoga su se za dijelove projekta stvarala mala odvojena rješenja i nitko nije zabranio dodavanje neke zajedničke ili domenske skupine i ponovno korištenje. Jedini alat koji nam nije dopuštao to bilo je pregledavanje koda. No, ponekad je i on zakašnjavao.
Tada smo počeli prelaziti na model s odvojenim repozitorijima. Poslovna logika prestala je prolaziti iz usluge u uslugu, a domene su stvarno postale neovisne. Ograničeni konteksti se jasno podržavaju. Kako u tom procesu ponovno koristimo infrastrukturne biblioteke? Odvojili smo ih u poseban repozitorij, zatim ih stavili u Nuget pakete koje smo smjestili u Artifactory. Pri svakoj promjeni, izgradnja i objava odvijaju se automatski.
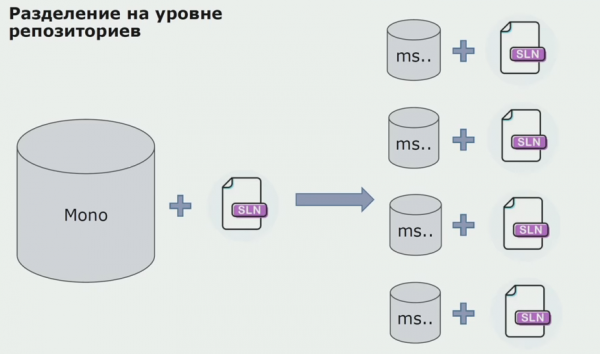
Naše usluge počele su se referirati na interne infrastrukturne pakete na isti način kao i na vanjske. Vanjske biblioteke preuzimamo iz Nugeta. Za rad s Artifactoryjem, gdje smo smjestili te pakete, koristili smo dva upravitelja paketa. U malim repozitorijima također smo koristili Nuget. U repozitorijima s više usluga koristili smo Paket, koji osigurava veću dosljednost verzija između modula.
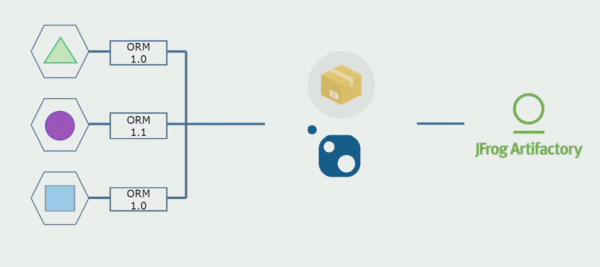
Dakle, radom na izvor kodu, malo promijenivši arhitekturu i razdvajanjem repozitorija, činimo naše usluge neovisnijima.
Problemi infrastrukture
Većina nedostatka pri prelasku na mikroslužbe povezana je s infrastrukturom. Trebat će vam automatizirano implementiranje, potrebne su nove biblioteke za rad s infrastrukturom.
Ručno postavljanje u okruženja
Prvotno smo rješenja za okruženje instalirali ručno. Kako bismo automatizirali taj proces, stvorili smo CI/CD kanal. Odabrali smo proces neprekidne isporuke, jer je neprekidno implementiranje za nas trenutno neprihvatljivo s aspekta poslovnih procesa. Stoga se puštanje u rad vrši pritiskom na gumb, dok se testiranje odvija automatski.
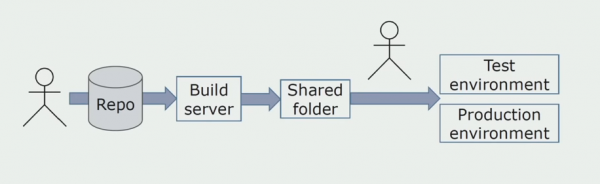
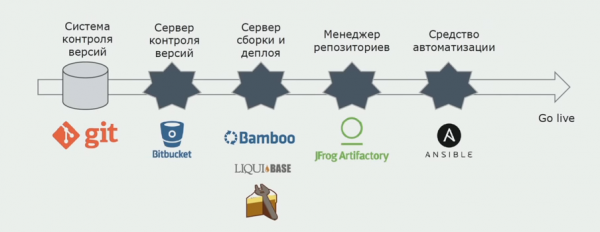
Mi koristimo Atlassian, Bitbucket za pohranu izvornih kodova i Bamboo za izradu. Sviđa nam se pisanje skripti za izradu na Cakeu, jer je to isti C#. U Artifactory dolaze već gotovi paketi, a Ansible automatski ide na testne servere, nakon čega ih odmah možemo testirati.
Odvojeno logiranje
Nekada, jedna od ideja monolita bila je osigurati zajedničko logiranje. Također smo trebali shvatiti što učiniti s odvojenim logovima koji su smješteni na diskovima. Logovi se pišu u tekstualne datoteke. Odlučili smo koristiti standardni ELK stack. Nismo htjeli pisati direktno u ELK putem providera, već smo odlučili doraditi tekstualne logove i zapisivati u njih ID traganja u obliku identifikatora, dodajući naziv usluge, kako bismo te logove mogli kasnije analizirati.
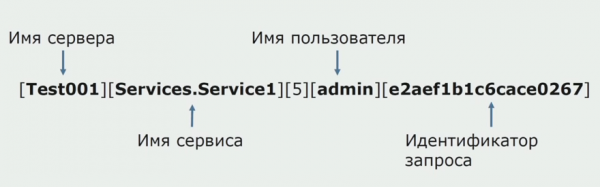
Pomoću Filebeata dobivamo mogućnost prikupljanja naših logova s poslužitelja, a zatim ih pretvarati, uz pomoć Kibanе graditi upite u UI i gledati kako je poziv prolazio između usluga. U tome značajno pomaže ID traganja.
Testiranje i debagiranje povezanih servisa
Isprva nismo u potpunosti razumjeli kako da debagujemo razvijene servise. S monolitom je sve bilo jednostavno, pokretali smo ga na lokalnom računalu. Također smo pokušavali raditi s mikroservisima, ali ponekad za potpuno pokretanje jednog mikroservisa treba pokrenuti i nekoliko drugih, što je neudobno. Shvatili smo da je potrebno preći na model u kojem na lokalnom računalu ostavljamo samo servis ili servise koje želimo debagovati. Ostali servisi koriste se s poslužitelja koji se konfiguracijom podudaraju s produkcijom. Nakon debagovanja, prilikom testiranja, na testni poslužitelj daju se samo izmijenjeni servisi za svaku zadaću. Tako se testira rješenje u obliku u kojem će se ono u budućnosti naći u produkciji.
Postoje poslužitelji na kojima su samo produkcijske verzije servisa. Ti poslužitelji su potrebni u slučaju incidenata, za provjeru isporuke prije implementacije i za unutarnje obuke.
Dodali smo proces automatskog testiranja pomoću popularne biblioteke Specflow. Testovi se automatski pokreću pomoću NUnit-a odmah nakon implementacije iz Ansibla. Ako je pokrivenost zadatka potpuno automatska, onda nema potrebe za ručnim testiranjem. Iako ponekad dodatno ručno testiranje još uvijek može biti potrebno. Za određivanje koji testovi pokrenuti za određenu zadaću koristimo oznake u Jiri.
Dodatno je porasla potreba za testiranjem opterećenja, koje se ranije provodilo samo u rijetkim slučajevima. Za pokretanje testova koristimo JMeter, za njihovo pohranjivanje — InfluxDB, a za izradu grafova procesa — Grafanu.
Što smo postigli?
Prvo, oslobodili smo se pojma "izdanje". Nestali su dvomjesečni monstruozni izdavački procesi, kada se ovaj mega sustav implementirao u produkcijsko okruženje, privremeno kršeći poslovne procese. Sada implementiramo servise u prosjeku svaka 1,5 dana, grupirajući ih, jer ulaze u upotrebu nakon odobrenja.
U našem sustavu nema fatalnih kvarova. Ako smo objavili mikroservis s greškom, onda će povezana funkcionalnost biti slomljena, dok ostala funkcionalnost neće biti pogođena. To značajno poboljšava korisničko iskustvo.
Možemo upravljati rasporedom implementacije. Moguće je izdvojiti grupe servisa od ostatka rešenja ako to bude potrebno.
Osim toga, značajno smo smanjili problem sa velikim redom za dorade. Imamo posebne proizvodne timove koji rade na delu servisa nezavisno. Tu već dobro odgovara Scrum proces. Konkretnom timu može biti dodeljen poseban vlasnik proizvoda koji mu postavlja zadatke.
Sažetak
- Mikroservisi su pogodna rešenja za dekompoziciju složenih sistema. Tokom procesa počinjemo da razumemo šta imamo u našem sistemu, koja su ograničena konteksta i gde su njihove granice. To omogućava pravilno raspoređivanje dorada po modulima i sprečava zamršavanje koda.
- Mikroservisi donose organizacijske prednosti. O njima se često govori samo kao o arhitekturi, ali svaka arhitektura je potrebna za rešavanje poslovnih potreba, a ne sama po sebi. Stoga možemo reći da su mikroservisi pogodna rešenja za rešavanje zadataka malim timovima, s obzirom na to da je Scrum trenutno vrlo popularan.
- Razdvajanju — to je iterativni proces. Ne možete uzeti aplikaciju i jednostavno je podeliti na mikroservise. Proizvod koji dobijete teško da će biti funkcionalan. Pri izdavanju mikroservisa, isplativo je prepisivati postojeći legacy, tj. pretvarati ga u kod koji nam se sviđa i bolje zadovoljava potrebe poslovanja u pogledu funkcionalnosti i brzine.
Malo upozorenje: troškovi prelaska na mikroservise su prilično značajni. Samo rešavanje problema infrastrukture oduzelo je mnogo vremena. Stoga, ako imate malu aplikaciju koja ne zahteva specifično skaliranje, ako nema mnogo korisnika koji se bore za pažnju i vreme vašeg tima, onda možda mikroservisi nisu ono što vam danas treba. To je prilično skupo. Ako započnete proces sa mikroservisima, troškovi će u početku biti veći nego da isti projekat započnete razvojem monolita.
P.S. Emotivnija priča (kao da je lično vama) – po .
Ovde je puna verzija izveštaja.
Izvor: habr.com
