

Predstavljamo vam treći dio prijevoda materijala o putu koji je kompanija Dropbox prošla prilikom implementacije sustava provjere tipova Python koda.
→ Prethodni dijelovi: i
Postizanje 4 milijuna redaka tipiziranog koda
Još jedan važan zadatak (to je bio drugi najpopularniji problem koji je brinuo one koji su sudjelovali u internim anketama) bio je povećanje obima koda u Dropboxu koji je pokriven provjerama tipova. Isprobali smo nekoliko pristupa za rješavanje ovog zadatka — od prirodnog rasta obima tipizirane kod baze do fokusiranja napora članova tima mypy na statičkom i dinamičkom automatiziranom izvođenju tipova. Na kraju se činilo da nema jednostavne pobjedničke strategije, ali smo uspjeli postići brzi rast obima annotiranog koda kombinirajući više pristupa.
Kao rezultat, u našem najvećem Python repozitoriju (s backend kodom) broj redaka annotiranog koda dosegao je gotovo 4 milijuna. Rad na statičkoj tipizaciji koda trajao je otprilike tri godine. Mypy sada podržava različite vrste izvještaja o pokrivenosti koda tipovima, koji olakšavaju praćenje napretka tipizacije. Konkretno, možemo generirati izvještaje o kodu s neodređenostima u tipovima, poput onih kod eksplicitne upotrebe tipa Any u anotacijama, koje nije moguće provjeriti, ili s onima kao što su uvozi vanjskih biblioteka za koje nema anotacija tipova. Kao dio projekta za poboljšanje točnosti provjere tipova u Dropboxu, doprinosili smo poboljšanju definicija tipova (takozvanih stub datoteka) za neke popularne open-source biblioteke u centraliziranom Python repozitoriju .
Implementirali smo (i standardizirali u sljedećim PEP-ovima) nove mogućnosti sustava tipova, koje omogućuju korištenje preciznijih tipova za neke specifične Python uzorke. Znatni primjer toga je TypeDict, koji pruža tipove za JSON-slične rječnike s fiksnim skupom string ključeva, pri čemu svaki od njih ima vrijednost vlastitog tipa. Nastavit ćemo širiti sustav tipova. Vjerojatno će naš sljedeći korak biti poboljšanje podrške za mogućnosti Pythona u radu s brojevima.
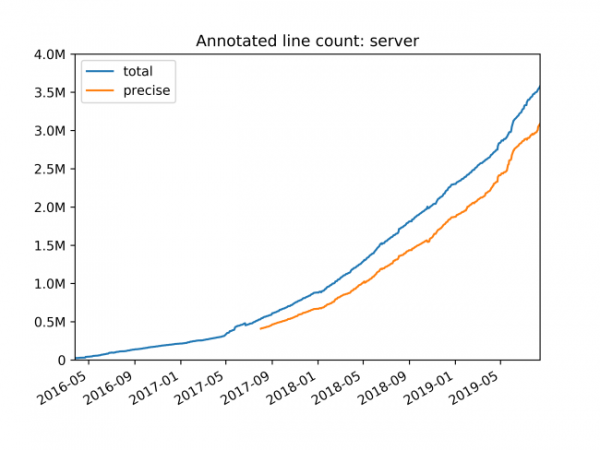
Broj redaka annotiranog koda: server
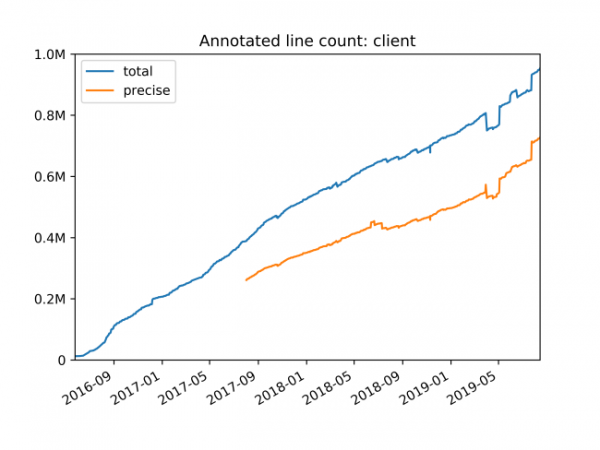
Broj redaka anotiranog koda: klijent
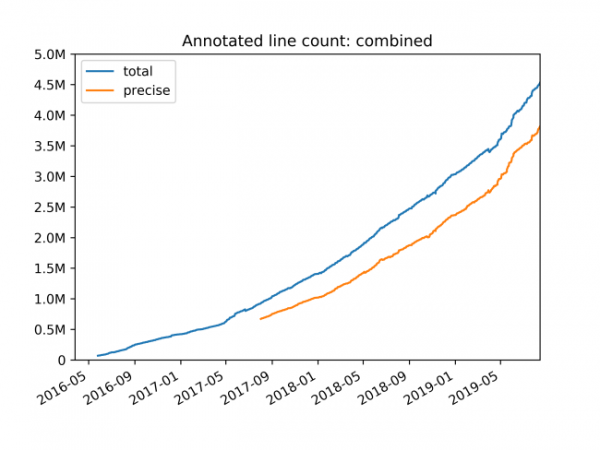
Ukupan broj redaka anotiranog koda
Evo pregleda glavnih značajki mjera koje smo poduzeli za povećanje volumena anotiranog koda u Dropboxu:
Strogost anotacije. Postupno smo povećavali zahtjeve za strogost anotacije novog koda. Počeli smo s preporukama linters-a koje su sugerirale dodavanje anotacija u datoteke koje već imaju neke anotacije. Sada zahtijevamo prisutnost anotacija tipova u novim Python datotekama i u većini postojećih datoteka.
Izvještaji o tipizaciji. Svakodnevno šaljemo timovima izvještaje o razini tipizacije njihovog koda i pružamo savjete o tome što bi trebalo anotirati kao prvo.
Popularizacija mypy. O mypy pričamo na raznim događanjima i komuniciramo s timovima, pomažući im da počnu koristiti anotacije tipova.
Ankete. Povremeno provodimo ankete među korisnicima kako bismo utvrdili glavne probleme. Spremni smo ići dovoljno daleko kako bismo riješili te probleme (čak i do stvaranja novog jezika radi ubrzanja mypy!).
Performanse. Značajno smo poboljšali performanse mypy-a zahvaljujući korištenju demona i mypyc-a. To je učinjeno kako bi se ublažile nelagode u procesu anotiranja i kako bi se omogućilo rad s velikim količinama koda.
Integracija s urednicima. Stvorili smo alate za podršku pokretanju mypy-a u urednicima koji su popularni u Dropboxu. Uključuje PyCharm, Vim i VS Code. To je znatno pojednostavilo proces rada na anotiranju koda i provjeri njegove funkcionalnosti. Ove aktivnosti su obično karakteristične za anotiranje postojećeg koda.
Statička analiza. Stvorili smo alat za ispis potpisa funkcija koristeći alate statičke analize. Ovaj alat može raditi samo u relativno jednostavnim situacijama, ali nam je pomogao da bez velikih napora povećamo pokrivenost koda tipovima.
Podrška za vanjske biblioteke. U mnogim našim projektima koristi se skup alata SQLAlchemy. U njemu se koriste dinamičke mogućnosti Pythona koje tipovi PEP 484 ne mogu izravno modelirati. U skladu s PEP 561, stvorili smo odgovarajući stub-datoteku i napisali dodatak za mypy.), poboljšavajući podršku za SQLAlchemy.
Izazovi s kojima smo se suočili
Put do 4 milijuna linija tipiziranog koda nije nam uvijek bio lak. Na tom putu naišli smo na brojne prepreke i napravili nekoliko grešaka. Ovo su neki od problema s kojima smo se suočili. Nadamo se da će priča o njima pomoći drugima da izbjegnu slične poteškoće.
Propuštene datoteke. Počeli smo raditi s provjerom samo malog broja datoteka. Sve što nije uključeno u taj broj nije se provjeravalo. Datoteke su se dodavale na popis provjere kada su se pojavile prve anotacije. Ako je nešto bilo uvezeno iz modula izvan područja provjere, radilo se o radu s tipovima vrednosti Any, koji se uopće nisu provjeravali. To je dovelo do značajnog gubitka točnosti tipiziranja, posebno u ranim fazama migracije. Ovakav pristup iznenađujuće je dobro funkcionirao, iako je tipična situacija bila da dodavanje datoteka u područje provjere otkriva probleme u drugim dijelovima kodne baze. U najgorem slučaju, kada su se spojila dva izolirana područja koda, u kojima su neovisno provjeravani tipovi, ispostavilo se da su tipovi tih područja nespojivi jedni s drugima. To je dovelo do potrebe za brojnim promjenama u anotacijama. Sada, gledajući unatrag, shvaćamo da smo trebali što ranije dodati u područje provjere tipova mypy osnovne bibliotečke module. To bi naš rad učinilo mnogo predvidljivijim.
Annotiranje starog koda. Kada smo započeli rad, imali smo oko 4 milijuna linija već postojećeg Python koda. Bilo je jasno da je annotiranje cijelog tog koda zadatak koji nije lak. Izradili smo alat, nazvan PyAnnotate, koji može prikupljati informacije o tipovima tijekom izvođenja testova i dodavati anotacije tipova u kod na temelju prikupljenih informacija. Međutim, nismo primijetili posebno široku primjenu ovog alata. Prikupljanje informacija o tipovima bilo je sporo, a automatski generirane anotacije često su zahtijevale mnogo ručnih ispravaka. Razmišljali smo o automatskom pokretanju ovog alata pri svakom pregledu koda ili o prikupljanju informacija o tipovima na temelju analize određenog malog obujma stvarnih mrežnih zahtjeva, no odlučili smo to ne učiniti, jer bi bilo koji od tih pristupa bio previše rizičan.
Na kraju se može primijetiti da je većina koda ručno anotirana od strane njegovih vlasnika. Kako bismo usmjerili ovaj proces u pravom smjeru, pripremamo izvještaje o posebno važnim modulima i funkcijama koje treba anotirati. Na primjer, važno je obogatiti anotacijama tipa knjižnični modul koji se koristi na stotinama mjesta. Dok stari servis koji se zamjenjuje novim više nije toliko važan za anotaciju. Također, eksperimentiramo s korištenjem statičke analize za generiranje anotacija tipova za stari kod.
Ciklički importi. Gore sam govorio o cikličkim importima (o „klupčicama ovisnosti”), čije je postojanje otežalo ubrzanje mypy-a. Osim toga, morali smo ozbiljno raditi na tome da mypy podrži sve vrste idiomâ, čiji su uzrok ovi ciklički importi. Nedavno smo završili veliki projekt redizajna sustava koji je ispravio većinu problema mypy-a u vezi cikličnih uvoza. Ovi problemi, zapravo, potekli su iz vrlo ranih dana projekta, još iz Alore, obrazovnog jezika na koji je projekt mypy prvotno bio usmjeren. Sintaksa Alore olakšava rješavanje problema cikličkih uvoznih naredbi. Moderni mypy naslijedio je neka ograničenja iz svoje rane, jednostavne implementacije (koja je odlično odgovarala za Alore). Python otežava rad s cikličnim importima uglavnom zbog dvosmislenosti izraza. Na primjer, tijekom operacije dodjele vrijednosti, može se zapravo odrediti pseudonim tipa. Mypy nije uvijek u stanju prepoznati takve stvari sve dok veći dio ciklusa uvoza nije obrađen. U Alore nije bilo takvih dvosmislenosti. Neuspješna rješenja donesena u ranim fazama razvoja sustava mogu programeru donijeti neugodno iznenađenje mnogo godina kasnije.
Zaključci: put do 5 milijuna linija koda i novih horizonta
Projekt mypy prošao je dug put — od ranih prototipova do sustava kojim se kontroliraju tipovi produkcijskog koda obujma od 4 milijuna linija. Tijekom razvoja mypy-a standardizirana su tipovna podaci u Pythonu. U današnje vrijeme razvila se snažna ekosustav oko tipiziranja Python koda. U njemu je pronađeno mjesto za podršku knjižnicama, postoje alati za IDE i uređivače, a tu su i nekoliko sustava za kontrolu tipova, od kojih svaki ima svoje prednosti i mane.
Iako se provjera tipova već smatra nečim što se podrazumijeva u Dropboxu, siguran sam da još uvijek živimo na pragu tipiziranja Python koda. Mislim da će se tehnologije provjere tipova nastaviti razvijati i poboljšavati.
Ako još niste koristili provjere tipova u svom velikom Python projektu, znajte da je sada pravo vrijeme za prelazak na statičku tipizaciju. Razgovarao sam s onima koji su napravili taj prelazak. Nitko od njih nije požalio. Kontrola tipova pretvara Python u jezik koji je mnogo prikladniji za razvoj velikih projekata nego "obični Python."
Dragi čitatelji! Koristite li kontrolu tipova u svojim Python projektima?
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish