

TL; DR: JSONB može značajno pojednostaviti razvoj sheme baze podataka bez gubitka performansi u upitima.
Uvod
Uzmimo klasičan primjer, vjerojatno jedan od najstarijih načina korištenja u svijetu relacijskih baza podataka: imamo entitet i potrebno je pohraniti određena svojstva (atribute) tog entiteta. No, ne mogu svi primjeri imati isti skup svojstava, a moguće je i dodavanje novih svojstava u budućnosti.
Najjednostavniji način rješavanja ovog problema je stvaranje stupca u tablici baze podataka za svaku vrijednost svojstva i jednostavno popunjavanje onih koje su potrebne za određeni primjer entiteta. Odlično! Problem riješen… sve dok vaša tablica ne sadrži milijune zapisa i ne dobijete potrebu za dodavanjem novog zapisa.
Razmotrite obrazac EAV (), koji se često koristi. Jedna tablica sadrži entitete (zapise), druga tablica sadrži imena svojstava (atributa), a treća tablica povezuje entitete s njihovim atributima i sadrži vrijednost tih atributa za trenutni entitet. To vam omogućuje da imate različite skupove svojstava za različite objekte, kao i dodavanje svojstava “u letu”, bez promjene strukture baze podataka.
Ipak, ne bih pisao ovu bilješku da nije bilo nedostataka u pristupu korištenju EAV-a. Naime, za dobivanje jednog ili više entiteta koji imaju po jedan atribut potrebno je 2 join-a (spajanja) u upitu: prvi – spajanje s tablicom atributa, drugi – spajanje s tablicom vrijednosti. Ako entitet ima 2 atributa, tada su potrebna već 4 join-a! Osim toga, svi atributi obično se čuvaju kao stringovi, što dovodi do konverzije tipova, kako za rezultat, tako i za uvjet WHERE. Ako pišete mnogo upita, to je prilično rasipno u pogledu korištenja resursa.
Unatoč ovim očitim nedostacima, EAV se već dugo koristi za rješavanje ovakvih problema. To su bili neizbježni nedostaci, a bolja alternativa jednostavno nije postojala.
Ali tada je u PostgreSQL-u došla nova “tehnologija”...
Od PostgreSQL 9.4, uveden je tip podatka JSONB za pohranu binarnih JSON podataka. Iako pohrana JSON-a u ovom formatu obično traje malo duže i zauzima više prostora nego običan tekstualni JSON, izvođenje operacija s njim je mnogo brže. Također, JSONB podržava indeksiranje, što dodatno ubrzava upite.
Tip podatka JSONB omogućuje nam da zamijenimo glomazni obrazac EAV dodavanjem samo jedne JSONB kolone u našu tablicu entiteta, što znatno pojednostavljuje dizajn baze podataka. Međutim, mnogi tvrde da bi to trebalo dovesti do smanjenja performansi… Upravo iz tog razloga i nastaje ovaj članak.
Postavljanje testne baze podataka
Za ovu usporedbu, stvorio sam bazu podataka na novoj instalaciji PostgreSQL 9.5 na 80-dolarskoj konfiguraciji Ubuntu 14.04. Nakon postavljanja nekih parametara u postgresql.conf, pokrenuo sam skriptu pomoću psql-a. Za predstavljanje podataka u obliku EAV kreirane su sljedeće tablice:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
U nastavku je prikazana tablica gdje će biti pohranjeni isti podaci, ali s atributima u koloni tipa JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Izgleda puno jednostavnije, zar ne? Zatim je u tablice entiteta (entity & entity_jsonb) dodano 10 milijuna zapisa, i tako su ispunjeni identičnim podacima tablice gdje se koristi EAV obrazac i pristup s JSONB kolonom – entity_jsonb.properties. Tako smo dobili nekoliko različitih tipova podataka među svim skupovima svojstava. Primjer podataka:
{
  id:          1
  name:        "Entity1"
  description: "Testni entitet br. 1"
  properties:  {
    color:        "crvena"
    lenght:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgija"
  }
}
Dakle, sada imamo iste podatke za dvije varijante. Počnimo uspoređivati implementacije u radu!
Pojednostavljenje dizajna
Već je rečeno da je dizajn baze podataka znatno pojednostavljen: jedna tablica, korištenjem JSONB kolone za svojstva, umjesto korištenja tri tablice za EAV. No, kako to utječe na upite? Ažuriranje jednog svojstva entiteta izgleda ovako:
-- EAV
UPDATE entity_attribute_value
SET value = 'plava'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"plava"')
WHERE id = 120;
Kao što vidimo, posljednji upit ne izgleda jednostavnije. Da bismo ažurirali vrijednost svojstva u JSONB objektu, moramo koristiti funkciju , i moramo proslijediti našu novu vrijednost kao JSONB objekt. Međutim, ne trebamo unaprijed znati nijedan identifikator. Gledajući primjer s EAV, trebamo znati i entity_id i entity_attribute_id da bismo izvršili ažuriranje. Ako želite ažurirati svojstvo u JSONB stupcu na temelju naziva objekta, - to se sve radi jednom jednostavnom linijom.
Sada, odaberimo entitet koji smo upravo ažurirali prema uvjetu njegove nove boje:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'plava';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'plava';
Mislim da se možemo složiti da je druga opcija kraća (bez join!), a time i čitljivija. Ovdje JSONB pobjeđuje! Koristimo operator JSON ->> da dobijemo boju kao tekstualnu vrijednost iz JSONB objekta. Postoji i drugi način postizanja istog rezultata u JSONB modelu koristeći operator @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "plava"}';
To je malo složenije: provjeravamo sadrži li JSON objekt u stupcu svojstava objekt koji se nalazi desno od operatora @>. Manje čitljivo, ali učinkovitije (vidi dalje).
Dopustite da još više pojednostavimo korištenje JSONB kada trebate odabrati više svojstava istovremeno. Tada se JSONB pristup stvarno isplati: jednostavno odabiremo svojstva kao dodatne stupce u našim skupovima rezultata bez potrebe za spajanjima:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
S EAV trebate 2 spoja za svako svojstvo koje želite zatražiti. Po mom mišljenju, gornji upiti pokazuju značajno pojednostavljenje dizajna baze podataka. Više primjera kako pisati upite za JSONB također može se naći u postu.
Sada je došlo vrijeme da razgovaramo o performansama.
Performanse
Kako bismo usporedili performanse, koristio sam u upitima, za mjerenje vremena izvršavanja. Svaki upit izvršen je najmanje tri puta, jer planneru upita treba više vremena prvi put. Prvo sam izvršio upite bez ikakvih indeksa. Očigledno, to je bilo korisno za JSONB, jer se join potrebni za EAV nisu mogli koristiti indekse (polja stranih ključeva nisu bila indeksirana). Nakon toga sam stvorio indeks za 2 kolone stranih ključeva u EAV tablici vrijednosti, kao i indeks za kolonu JSONB.
Ažuriranja podataka pokazala su sljedeće rezultate prema vremenu (u ms). Obavite pažnju da je skala logaritamska:
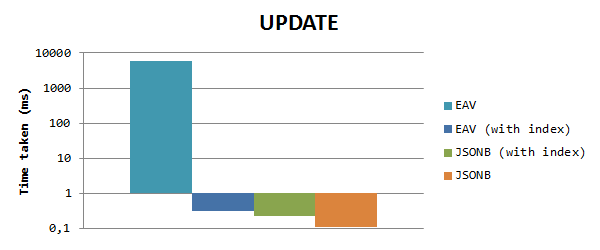
Vidimo da je JSONB mnogo (> 50000-x) brži od EAV, ako ne koristimo indekse, iz razloga navedenog iznad. Kada indeksiramo kolone s primarnim ključevima, razlika gotovo nestaje, ali JSONB je još uvijek 1,3 puta brži od EAV. Obavite pažnju da indeks u koloni JSONB ovdje nema nikakvog utjecaja, jer ne koristimo kolonu svojstava u kriterijima ocjene.
Za odabir podataka na temelju vrijednosti svojstva dobivamo sljedeće rezultate (normalna skala):
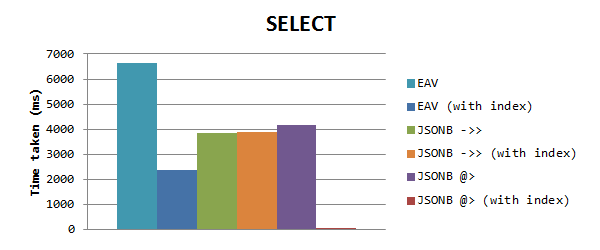
Može se primijetiti da JSONB ponovno radi brže od EAV bez indeksa, ali kada je EAV s indeksima – on ipak radi brže od JSONB. No, kasnije sam primijetio da su vremena za JSONB upite bila jednaka, što me navelo na pomisao da GIN-indeks ne funkcionira. Očigledno, kada koristite GIN indeks za kolonu sa ispunjenim svojstvima, on djeluje samo kada koristite operator uključivanja @>. Koristio sam to u novom testu, što je imalo ogroman utjecaj na vrijeme: samo 0,153 ms! To je 15000 puta brže od EAV, i 25000 puta brže od operatora ->>.
Mislim da je to bilo dovoljno brzo!
Veličina BD tablica
Usporedimo veličine tablica kod oba pristupa. U psql-u možemo prikazati veličinu svih tablica i indeksa pomoću naredbe dti+
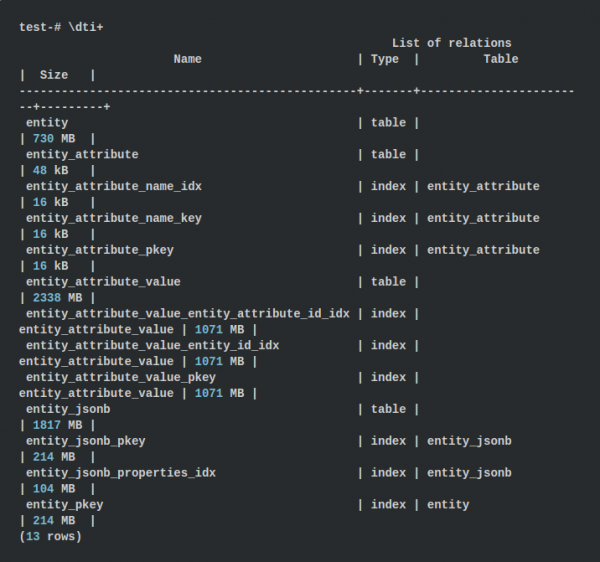
Za pristup EAV veličine tablica iznose približno 3068 MB, a indeksi do 3427 MB, što ukupno iznosi 6,43 GB. Kada koristimo pristup s JSONB-om koristi se 1817 MB za tablicu i 318 MB za indekse, što iznosi 2,08 GB. Dakle, tri puta manje! Ova činjenica me malo iznenadila, jer pohranjujemo imena svojstava u svakom JSONB objektu.
Međutim, brojke same govore: u EAV čuvamo 2 cijela vanjska ključa za vrijednost atributa, što rezultira dodatnih 8 bajtova podataka. Osim toga, u EAV svi vrijednosti svojstava pohranjuju se u obliku teksta, dok JSONB koristi numeričke i logičke vrijednosti kada je to moguće, što rezultira manjim volumenom.
Zaključci
Općenito, mislim da očuvanje svojstava entiteta u JSONB formatu može značajno pojednostaviti dizajn i održavanje vaše baze podataka. Ako izvršavate mnogo upita, sve što je pohranjeno u jednoj tablici s entitetom zapravo će raditi učinkovitije. A činjenica da to olakšava interakciju između podataka već je plus, ali također rezultantna Baza podataka je 3 puta manja po volumenu.
Također, na temelju provedenih testova, može se zaključiti da su gubici u performansama vrlo neznatni. U nekim slučajevima, JSONB čak radi brže od EAV, što ga čini još boljim. Međutim, ovaj referentni test, naravno, ne pokriva sve aspekte (npr. entiteti s vrlo velikim brojem svojstava, značajnim povećanjem broja svojstava postojećih podataka,…), stoga, ako imate bilo kakve prijedloge o tome kako ih poboljšati, slobodno ostavite u komentarima!
Izvor: habr.com
