

Mint a , felmerült egy probléma az Elvin nevű elosztott szolgáltatással. Ezúttal nem én fedeztem fel a problémát, a kliensoldali srácok értesítettek.
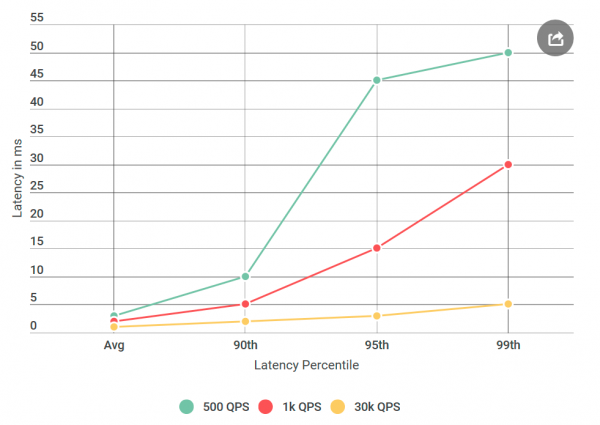
Egyszer felébredtem egy elégedetlen levélre, amely az Elvin tapasztalt nagy késleltetések miatt készült, amelyet a közeljövőben szeretnénk indítani. Különösen, a kliens a 99. percentilis késleltetés 50 ms körüli értékével szembesült, ami jóval meghaladta a késleltetési keretünket. Ez meglepő volt, mivel alaposan teszteltem a szolgáltatást, különös figyelmet fordítva a késleltetésekre, mivel ez gyakori panaszok tárgya.
Mielőtt átkonfigurálnám az Elvint a teszteléshez, sok kísérletet végeztem 40 ezer kérés másodpercenként (QPS) terheléssel, mindegyik 10 ms alatti késleltetést mutatott. Készen álltam arra, hogy kijelentsem, nem értek egyet az eredményeikkel. De újra megnézve a levelet, észrevettem valami újat: pontosan nem teszteltem azokat a körülményeket, amiket említettek, az ő QPS-ük messze alacsonyabb volt, mint az enyém. Én 40k QPS-en teszteltem, ők pedig csak 1k-n. Újabb kísérletet indítottam, ezúttal alacsonyabb QPS-el, csak hogy megfeleljek nekik.
Mivel erről írok a blogomban - valószínűleg már rájöttél: az adataik helyesnek bizonyultak. Újra és újra ellenőriztem a virtuális ügyfelemet, mindig ugyanazt az eredményt kaptam: az alacsony kérésszám nemcsak a késleltetést növeli, hanem a 10 ms-ot meghaladó késleltetéssel rendelkező kérések számát is. Más szóval, míg 40k QPS esetén körülbelül 50 kérelem másodpercenként meghaladta az 50 ms-ot, addig 1k QPS esetén másodpercenként 100 kérelem volt, amely 50 ms feletti késleltetéssel rendelkezett. Paradoxon!
Szűkítsük le a keresést
A késleltetési problémával szembenézve egy elosztott rendszerben, amely számos komponensből áll, először is össze kell állítani egy rövid gyanúsítottak listáját. Nézzük meg Elvin architektúráját kicsit mélyebben:
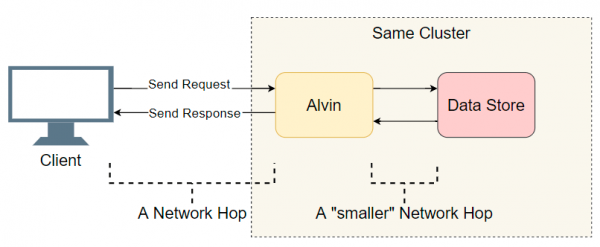
Jó kiindulási pont a végrehajtott be-/kimeneti tranzakciók listája (hálózati hívások/disk keresés stb.). Próbáljuk kideríteni, hol van a késleltetés. Az egyértelmű kliens-szintű be-/kimenet mellett Elvin egy plusz lépést is tesz: hozzáfér a tárolási adatokhoz. Azonban ez a tárolás egy klaszterben működik Elvinnel, így ott a késleltetésnek alacsonyabbnak kell lennie, mint a kliens esetében. Tehát a gyanúsítottak listája:
- Hálózati hívás a kliens és Elvin között.
- Elvin hálózati hívása az adatbázishoz.
- Keresés az adatbázison.
- Hálózati hívás az adatbázisból Elvinhez.
- Hálózati hívás Elvintől az ügyfélhez.
Próbáljunk meg néhány elemet kihúzni.
Az adatbázis nem játszik szerepet.
Először is átalakítottam Elvint ping-ping szerverré, amely nem dolgozza fel a kéréseket. A kérés megérkezésekor üres választ ad. Ha a késleltetés csökken, akkor a hiba Elvin vagy az adatbázis megvalósításában van - semmi szokatlan. Az első kísérlet során ezt az ábrát kapjuk:
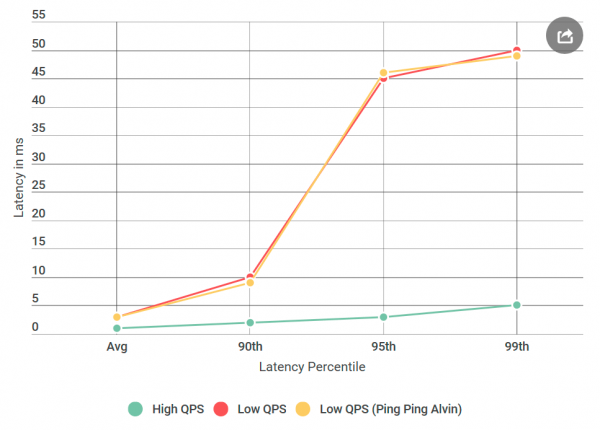
Ahogy látjuk, a ping-ping szerver használatakor nincs észlelhető javulás. Ez azt jelenti, hogy az adatbázis nem növeli a késleltetést, és a gyanúsítottak köre a felére csökken:
- Hálózati hívás a kliens és Elvin között.
- Hálózati hívás Elvintől az ügyfélhez.
Remek! A lista gyorsan csökken. Azt hittem, hogy szinte rájöttem az okára.
gRPC
Itt az ideje bemutatni egy új szereplőt: . Ez egy nyílt forráskódú könyvtár a Google-tól az intra-processz kommunikációhoz. . Bár gRPC jól optimalizált és széles körben használt, én először használom egy ilyen méretű rendszeren, és azt vártam, hogy a megvalósításom nem lesz optimális - finoman szólva.
A gRPC stack megléte új kérdést vet fel: talán a megvalósításom vagy maga gRPC okozza a késleltetési problémát? Új gyanúsítottat adunk a listához:
- Az ügyfél a könyvtárat hívja.
gRPC - Könyvtár
gRPCaz ügyfélnél végrehajtja a könyvtár hálózati hívásátgRPCa szerveren - Könyvtár
gRPCElvinhez fordul (művelet nincs a ping-pong szerver esetén).
Hogy megértsd, hogyan néz ki a kód, az én Elvin/ügyfél megvalósításom nem nagyon különbözik a kliens-szerver .
Megjegyzés: A fent említett lista kicsit leegyszerűsített, mivel
gRPClehetővé teszi a testreszabott (sablon?) párhuzamos modell használatát, amelyben összefonódik a végrehajtási stackgRPCés a felhasználói megvalósítás. Az egyszerűség kedvéért ragaszkodjunk ehhez a modellhez.
A profiliozás mindent megold.
Az adatbázisok kihúzása után azt hittem, hogy majdnem kész vagyok: "Most már könnyű! Alkalmazzunk profilt és nézzük meg, hol adódik a késleltetés." Én , mert a CPU nagyon gyors és általában nem szoktak a szűk keresztmetszetet jelenteni. A legtöbb késleltetés akkor jelentkezik, amikor a processzornak le kell állítania a feldolgozást, hogy mást csináljon. A pontos CPU profiliozás éppen ezért készült: pontosan rögzíti az összes. és jelzi, hol jelentkeznek a késések.
Négy profilt vettem: egy magas QPS-hez (kicsi késleltetés) és egy ping-pong szerverhez alacsony QPS-sel (nagy késleltetés), mind a kliens, mind a szerver oldaláról. És csak a biztonság kedvéért hoztam egy processzorprofil mintát is. A profilok összehasonlításakor általában az anomális hívási verem keresem. Például a késleltetett oldalon sokkal több kontextusváltás történik (10-szerese vagy annál is több). De az én esetemben a kontextusváltások száma gyakorlatilag megegyezett. A rémületemre, ott nem volt semmi lényeges.
További hibakeresés
Kétségbe voltam esve. Nem tudtam, milyen más eszközöket használhatnék, és a következő tervem lényegében a kísérleteim megismétlése különböző variációkkal volt, nem pedig a probléma pontos diagnosztizálása.
Mi lenne, ha
Az elejétől kezdve aggasztott a konkrét 50 ms-os késleltetési idő. Ez egy nagyon nagy idő. Úgy döntöttem, hogy ki fogok vágni darabokat a kódból, amíg meg nem tudom állapítani, hogy pontosan melyik rész okozza a hibát. Ezután következett a kísérlet, amely működött.
Mint általában, most utólag úgy tűnik, hogy minden nyilvánvaló volt. A klienst egy gépre helyeztem Elvinnel - és küldtem egy kérést a localhost-nak. És a késleltetés növekedése eltűnt!
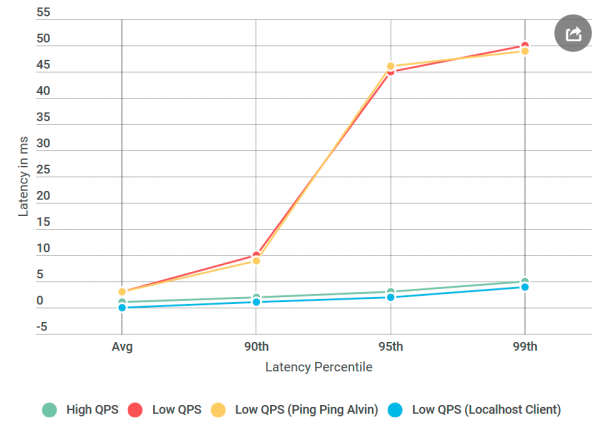
Valami nem stimmelt a hálózattal.
Hálózati mérnöki készségek elsajátítása
Be kell vallanom: a hálózati technológiák ismereteim borzalmasak, különösen figyelembe véve, hogy naponta dolgozom velük. De a hálózat volt a fő gyanúsított, és meg kellett tanulnom, hogyan debuggáljam.
Szerencsére az internet kedveli azokat, akik tanulni akarnak. A ping és a tracert kombinációja elég jó kezdésnek tűnt a hálózati szállítási problémák hibakereséséhez.
Először is, futtattam a -t Elvin TCP-portján. Az alapértelmezett paramétereket használtam - semmi különös. Több mint ezer pingből egy sem haladta meg a 10 ms-t, kivéve az elsőt a bemelegítés érdekében. Ez ellentmond a 99. percentilisben megfigyelt 50 ms-os késleltetés növekedésének: ott minden 100 kérdésért úgy kellett volna látnunk, hogy körülbelül egy kérelem 50 ms késéssel rendelkezik.
Ezután kipróbáltam a -et: talán a probléma az Elvin és a kliens közötti útvonal egyik csomópontjában van. De a tracer is üres kézzel tért vissza.
Így tehát a késlekedés oka nem az én kódom, nem a gRPC implementációja és nem a hálózat volt. Már kezdtem aggódni, hogy sosem fogom ezt megérteni.
Most pedig, melyik operációs rendszeren vagyunk
gRPC széles körben használják Linuxon, de Windows alatt ez különlegesség. Eldöntöttem, hogy végrehajtok egy kísérletet, ami működött: létrehoztam egy Linux virtuális gépet, lefordítottam Alvinot Linuxra és telepítettem.
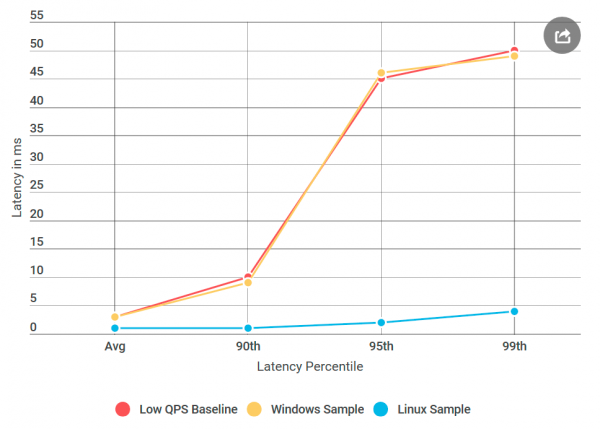
És ez lett az eredmény: a Linux ping-pong szerverén nem voltak olyan késlekedések, mint a hasonló Windows csomóponton, bár az adatforrás nem változott. Kiderült, hogy a probléma a Windowsra szóló gRPC implementációjában van.
Nagle algoritmus
Mindig azt hittem, hogy hiányzik egy flag gRPC. Most már értem, hogy valójában ez a gRPC Windows flag hiányzik. Megtaláltam egy belső RPC könyvtárat, amelyről biztos voltam, hogy jól működik az összes telepített flaghez . Aztán hozzáadtam ezeket a flagokat a gRPC-hez és telepítettem Alvinot Windowsra, a javított ping-pong szerveren Windows alatt!
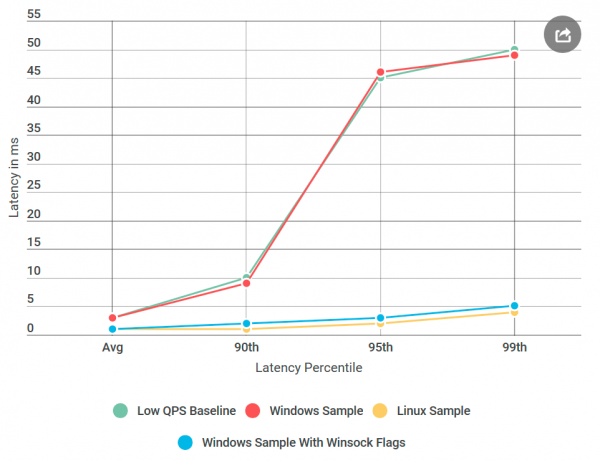
Majdnem kész: elkezdtem egyesével eltávolítani a hozzáadott flagokat, amíg vissza nem tért a regresszió, így pontosan meghatározhattam az okát. Ez a hírhedt , Nagle algoritmus kapcsolója.
Megpróbálja csökkenteni a hálózaton küldött csomagok számát az üzenetek küldésének késleltetésével, amíg a csomag mérete el nem éri a meghatározott bájtok számát. Bár ez kellemes lehet az átlagos felhasználónak, de romboló lehet az éles szerverek számára, mivel az OS késleltethet bizonyos üzeneteket, ami alacsony QPS mellett késlekedéseket okoz. Az gRPC Linux implementációban volt beállítva ez a flag a TCP socketekhez, de nem Windows alatt. Én ezt .
Zárás
Az alacsony QPS melletti nagy késlekedést az OS optimalizációja okozta. Visszatekintve, a profilozás nem észlelte a késlekedést, mert kernel módban történt, nem pedig Nem tudom, hogy az ETW felvételek segítségével látható-e a Nagle algoritmus, de érdekes lenne.
Ami a localhost kísérletet illeti, az valószínűleg nem érintette a tényleges hálózati kódot, és a Nagle algoritmus nem indult el, így a késleltetési problémák eltűntek, amikor a kliens localhoston keresztül hívta meg Alvinot.
Legközelebb, amikor a másodpercenkénti kérdések számának csökkenése mellett növekvő késlekedést tapasztalsz, a Nagle algoritmusnak a gyanúsítottak listáján kell lennie!
Forrás: habr.com
