

Ebben a cikkben arról fogok mesélni, hogyan alakult át az általam kezelt projekt egy nagy monolitból mikroszolgáltatások rendszerévé.
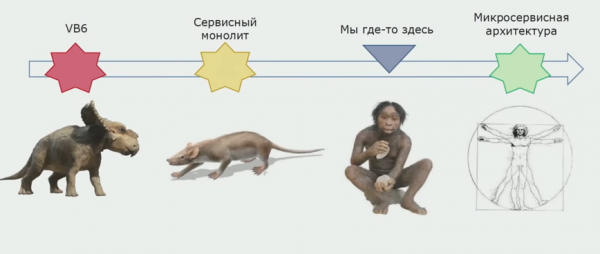
A projekt története már elég régre nyúlik vissza, a 2000-es évek elejére. Az első verziókat Visual Basic 6 nyelven írták. Az idő múlásával világossá vált, hogy a jövőben nehezen lesz fenntartható a fejlesztés ezen a nyelven, mivel az IDE és maga a nyelv lassan fejlődik. A 2000-es évek végén úgy döntöttek, hogy áttérnek egy ígéretesebb C# nyelvre. Az új verzió párhuzamosan készült a régi finomításával, egyre több kód íródott .NET környezetben. A C# backend eredetileg szolgáltatásorientált architektúrára épült, azonban a fejlesztés során közös könyvtárakat használtak a logika számára, és a szolgáltatások egyetlen folyamatban futottak. Olyan alkalmazás jött létre, amelyet „szolgáltatásmonolitnak” neveztünk.
Az ilyen architektúra egyik kevés előnye volt, hogy a szolgáltatások képesek voltak egymást hívni egy külső API-n keresztül. Egyértelmű jelek mutattak arra, hogy érdemes lenne áttérni a helyesebb szolgáltatásorientált, később pedig mikroszolgáltatás alapú architektúrára.
A dekompozíciós munkánkat körülbelül 2015 körül kezdtük. Még mindig nem értük el az ideális állapotot - maradtak a nagy projekt részei, amelyeket már nehezen lehet monolitnak nevezni, de mikroszolgáltatásoknak sem néznek ki. Ennek ellenére a fejlődés jelentős.
Erről fogok beszélni a cikkben.
Tartalom
A meglévő megoldás architektúrája és problémái
Az architektúra kezdetben a következőképpen nézett ki: a UI egy külön alkalmazás, a monolitikus rész Visual Basic 6 nyelven íródott, a .NET alkalmazás összekapcsolt szolgáltatások halmazát alkotta, amely egy meglehetősen nagy adatbázissal dolgozott.
A korábbi megoldás hátrányai
Egységes hibapont
Egyetlen hibaüzeneti pontunk volt: a .NET alkalmazás egy folyamatban futott. Ha bármelyik modulban hiba történt, az egész alkalmazás leállt, és újra kellett indítani. Mivel sok folyamat automatizálódik különböző felhasználók számára, egy hiba miatt egy időre az összes felhasználó nem tudta használni az alkalmazást. A programhibáknál a redundancia sem segített.
Fejlesztések sora
Ez a hiányosság inkább szervezeti jellegű. Az alkalmazásunkban sok ügyfél van, és mindannyian minél hamarabb szeretnék a módosításokat elvégezni. Korábban ezt párhuzamosan nem lehetett megtenni, ezért az összes ügyfél egy sorba állt. Ez a folyamat negatívan érintette az üzletet, hiszen be kellett bizonyítaniuk, hogy a feladatuk értékes. A fejlesztői csapat pedig időt töltött a sor megszervezésével, ami sok időt és energiát emésztett fel, a termék pedig nem tudott olyan gyorsan változni, ahogyan azt elvárták.
Nem optimális erőforrás-használat
Amikor a szolgáltatásokat egyetlen folyamatban helyeztük el, mindig teljesen átmásoltuk a konfigurációt szerverről szerverre. Szerettük volna a legjobban megterhelt szolgáltatásokat különállóan kezelni, hogy ne pazaroljunk el erőforrásokat, és hogy rugalmasabb irányítást nyerjünk a telepítési sémánkon.
Nehéz modern technológiákat bevezetni
A fejlesztők számára ismert probléma: szeretnénk modern technológiákat bevezetni a projektbe, de nincs rá lehetőség. Egy nagy monolitikus megoldásnál bármilyen frissítés a jelenlegi könyvtárra, nem is beszélve az újra való áttérésről, meglehetősen bonyolult feladattá válik. Hosszasan kell bizonyítanunk a csapatvezetőnek, hogy ez több előnyt hoz, mint amennyi idegeskedést okoz.
A változtatások kiadási nehézsége
Ez volt a legsúlyosabb probléma - minden két hónapban új verziót adtunk ki.
Minden kiadás valódi katasztrófává vált a bank számára, a tesztelés és a fejlesztők erőfeszítései ellenére. Az üzlet tudta, hogy a hét elején az funkcionalitás egy része nem fog működni. A fejlesztők pedig tudták, hogy komoly incidensek várnak rájuk egy hétre.
Mindenkinek voltak vágyai a helyzet megváltoztatására.
Elvárások a mikroszolgáltatásokkal szemben
A komponensek kiadása érettség szerint. A komponensek kiadása a készültség függvényében a megoldás dekomponálásának és különböző folyamatok leválasztásának köszönhetően.
Kis termékcsapatok. Ez fontos, mert egy nagy csapat az öreg monoliton nehezen kezelhető. Az ilyen csapatnak szigorú folyamatok mentén kellett dolgoznia, pedig a kreativitásra és függetlenségre vágytunk. Ezt csak a kis csapatok engedhették meg maguknak.
A szolgáltatások izolálása külön folyamatokban. Ideálisan konténerekben szeretnénk izolálni, de a .NET Framework alatt írt sok szolgáltatás csak Windows alatt fut. Most kezdik feltűnni a .NET Core alapú szolgáltatások, de ezek még nem elterjedtek.
A telepítés rugalmassága. Szeretnénk a szolgáltatásokat úgy kombinálni, ahogyan nekünk szükséges, nem pedig ahogyan a kód megköveteli.
Új technológiák használata. Ez minden programozó számára érdekes.
Az áttérés problémái
Természetesen, ha a monolitot mikroszolgáltatásokra bontani egyszerű lenne, erről nem beszélnénk konferenciákon és nem írnánk cikkeket. A folyamatban sok buktató van, a főbb akadályokat írom le, amik megnehezítették számunkra.
Az első probléma tipikus a legtöbb monolit számára: az üzleti logika összekapcsoltsága. Amikor monolitot írunk, akkor szeretnénk újrahasználni a osztályainkat, hogy ne kelljen felesleges kódot írni. Azonban mikroszolgáltatásokra való átálláskor ez problémává válik: az egész kód elég szoros kapcsolatban áll, és nehéz a szolgáltatások szétválasztása.
A munka megkezdésekor a repozitóriumban több mint 500 projekt és 700 ezer sor kód volt. Ez elég nagy megoldás és a második probléma. Egyszerűen nem volt lehetséges, hogy csak úgy szétválasszuk mikroszolgáltatásokra.
A harmadik probléma — a szükséges infrastruktúra hiánya. Gyakorlatilag a forráskód manuális másolásával foglalkoztunk a szerverekre.
Hogyan lépjünk a monolitból mikroszolgáltatásokra
Mikroszolgáltatások kiemelése
Először is, azonnal meghatároztuk, hogy a mikroszolgáltatásokra való szétválasztás iteratív folyamat. Mindig elvárták tőlünk, hogy párhuzamosan végezzük az üzleti feladatok fejlesztését. Hogyan végezzük ezt technikailag — ez már a mi problémánk. Ezért felkészültünk az iteratív folyamatra. Másképp nem működik, ha nagy alkalmazásod van, és az eredetileg nincs felkészülve arra, hogy átírják.
Milyen módszereket használunk a mikroszolgáltatások kiemelésére?
Első mód — a meglévő modulokat szolgáltatásként kiemelni. Ebben a tekintetben szerencsénk volt: már voltak kialakított szolgáltatások, amelyek WCF protokollt használtak. Ezek különálló összesítésekbe voltak szétszórva. Én külön-külön vittük át őket, minden egyes összesítéshez egy kis indítómodult hozzáadva. Ezt a csodálatos Topshelf könyvtárral írtuk, amely lehetővé teszi, hogy az alkalmazást szolgáltatásként és konzolként is futtassuk. Ez kényelmes a hibakereséshez, mivel nem szükséges további projektek a megoldásban.
A szolgáltatások üzleti logikához kapcsolódtak, mivel közös összesítéseket használtak és közös adatbázissal dolgoztak. Nehéz volt őket tiszta értelemben mikroszolgáltatásoknak nevezni. Mindazonáltal ezek a szolgáltatások külön-külön megjeleníthetők voltak, különböző folyamatokban. Már ez lehetővé tette a kölcsönös hatásuk csökkentését, ami csökkentette a párhuzamos fejlesztés és az egyetlen meghibásodási pont problémáit.
A hosttal való összesítés mindössze egy sor kód a Program osztályban. A Topshelf kezelése egy segédosztályba van elrejtve.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
A mikroszolgáltatások kiemelésének második módja: új feladatok megoldására létrehozni őket. Ha eközben a monolit nem nő, már ez is nagyszerű, azt jelenti, hogy jó irányba haladunk. Új feladatok megoldásához próbáltunk különálló szolgáltatásokat létrehozni. Ha lehetőség volt rá, akkor a lehető leg"kanonikusabb" szolgáltatásokat készítettük, amelyek teljes mértékben kezelik a saját adatmodelljüket, külön adatbázissal.
Mi, akárcsak sokan mások, az autentikációs és engedélyezési szolgáltatásokkal kezdtük. Ezek ideálisan megfelelnek erre. Függetlenek, jellemzően elkülönített adatmodellt használnak. Ők maguk nem lépnek kapcsolatba a monolittal, csak ő fordul hozzájuk különböző feladatok megoldására. Ezeken a szolgáltatásokon lehet elkezdeni az új architektúrára való áttérést, rajtuk ki lehet próbálni az infrastruktúrát, valamint különböző hálózati könyvtárakkal kapcsolatos megközelítéseket, stb. Szervezetünknél nincs olyan csapat, amely ne tudná megvalósítani az autentikációs szolgáltatást.
A mikroszolgáltatások kiemelésének harmadik módja, amelyet használunk, kissé specifikus számunkra. Ez a vállalati logika kiemelése a UI rétegből. Az alapvető UI alkalmazásunk asztali, amely, akárcsak a backend, C#-on íródott. A fejlesztők időnként hibáztak, és a UI-ra helyezték a logika egyes részeit, amelyeknek a backendben kellett volna létezniük és újrahasználhatóak kellett volna legyenek.
Ha megnézünk egy valós példát a UI részének kódjából, látható, hogy a döntés nagy része valódi vállalati logikát tartalmaz, amely más folyamatokban is hasznos, nem csupán a UI űrlap fejlesztéséhez.
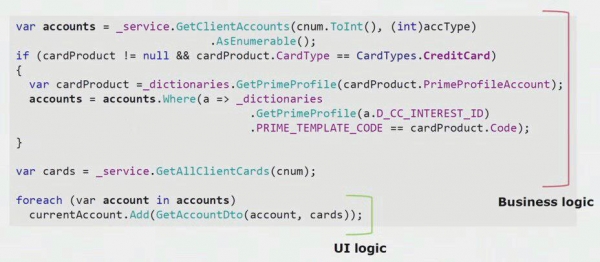
A UI valódi logikájának csak az utolsó pár sora van ott. Ezt áthelyeztük a szerverre, hogy újrahasználható legyen, ezzel csökkentve a UI-t és biztosítva a helyes architektúrát.
A negyedik, legfontosabb módszer a mikroszolgáltatások kiemelésére, amely lehetővé teszi a monolit csökkentését — ez a meglévő szolgáltatások átalakítással való kiemelése. Amikor a meglévő modulokat úgy helyezzük át, ahogy vannak, az eredmény nem mindig tetszik a fejlesztőknek, és az üzleti folyamat a funkció létrehozása óta elavulhatott. A refaktorizálás révén fenntarthatjuk az új üzleti folyamatot, mivel az üzlet követelményei folyamatosan változnak. Javíthatjuk a forrást, eltávolíthatjuk a jól ismert hibákat, és jobb minőségű adatmodellt hozhatunk létre. Sok előny halmozódik fel.
A szolgáltatások átalakítással való elkülönítése elválaszthatatlan a korlátozott kontextus fogalmától. Ez a fogalom az objektum-orientált tervezésből származik. Arra utal, hogy a domain modell egy szakasza, ahol minden kifejezés egyértelműen meghatározott egy egységes nyelven. Nézzük meg a biztosítások és számlák kontextusának példáját. Van egy monolitikus alkalmazásunk, és a biztosításokkal dolgoznunk kell a számlával. Azt várjuk, hogy a fejlesztő a másik összegyűjtésben talál egy meglévő „Számla” osztályt, hivatkozik rá a „Biztosítás” osztályból, és működő kódot kapunk. A DRY elv érvényesülni fog, a feladat a meglévő kód felhasználásával gyorsabban elvégezhető lesz.
Végül kiderül, hogy a számlák és a biztosítások kontextusai összefonódnak. Amikor új követelmények merülnek fel, ez a kapcsolat megnehezíti a fejlesztést, növelve a már így is bonyolult üzleti logika komplexitását. Ennek a problémának a megoldásához a kódban meg kell találni a határokat a kontextusok között, és el kell távolítani a megsértésüket. Például a biztosítások kontextusának valószínűleg elegendő lesz a 20 számjegyből álló Központi Bank számlaszám és a számla megnyitásának dátuma.
Az ezen korlátozott kontextusokat egymástól elkülönítve és a mikroszolgáltatások kiemelésének folyamatát elkezdve olyan megközelítést alkalmaztunk, mint a külső API-k létrehozása az alkalmazáson belül. Ha tudtuk, hogy egy modulnak mikroszolgáltatássá kell válnia, és valamilyen módon meg kell változnia a folyamat során, akkor azonnal meghívtuk a logikát, amely egy másik korlátozott kontextushoz tartozik, külső hívásokon keresztül. Például REST-en vagy WCF-en keresztül.
Határozottan elhatároztuk, hogy nem fogunk elkerülni olyan kódot, amely megköveteli a megosztott tranzakciók végrehajtását. A mi esetünkben meglehetősen könnyű volt betartani ezt a szabályt. Eddig nem merült fel olyan helyzet, amikor valóban szükség lett volna szigorú megosztott tranzakciókra - a modulok közötti végső konzisztencia elegendő volt.
Vizsgáljunk meg egy konkrét példát. Van egy fogalom, az orchestrátor - egy csővezeték, amely a 'kérelem' entitást dolgozza fel. Lépésről lépésre létrehozza az ügyfelet, a számlát és a bankkártyát. Ha az ügyfél és a számla sikeresen létrejön, de a kártya létrehozása meghiúsul, a kérelem nem vált 'sikeres' státuszúvá, és a 'kártya nem létrehozva' státuszban marad. A jövőbeli háttértevékenység fel fogja venni és befejezi azt. A rendszer egy ideig inkonzisztens állapotban marad, de ez számunkra összességében elfogadható.
Ha mégis felmerül a helyzet, amikor egy részadatokat konzisztensen kell menteni, akkor valószínűleg a szolgáltatás összesűrítésére megyünk, hogy ezt egyetlen folyamatban dolgozhassuk fel.
Nézzük meg a mikroszolgáltatás kiemelésének példáját. Hogyan lehet viszonylag biztonságosan a termelési környezetbe juttatni? Ebben a példában van egy külön rész a rendszerből - a bérszámfejtési modul, amelynek egyik kódrésze mikroszolgáltatásként szeretnénk működtetni.
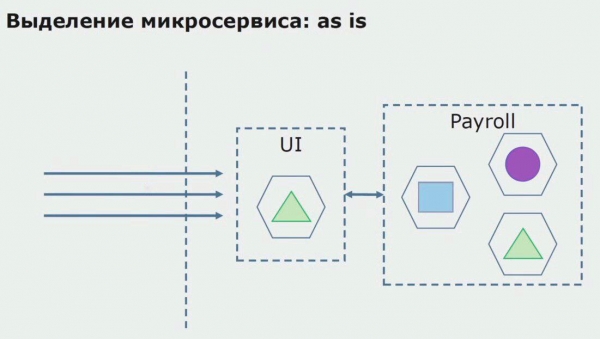
Először létrehozzuk a mikroszolgáltatást, átírva a kódot. Fejlesztjük azokat a részeket, amelyek nem feleltek meg az elvárásainknak. Megvalósítjuk az ügyfél új üzleti igényeit. Hozzáadunk egy API Gateway-t az UI és a háttér között, amely biztosítja a hívások továbbítását.
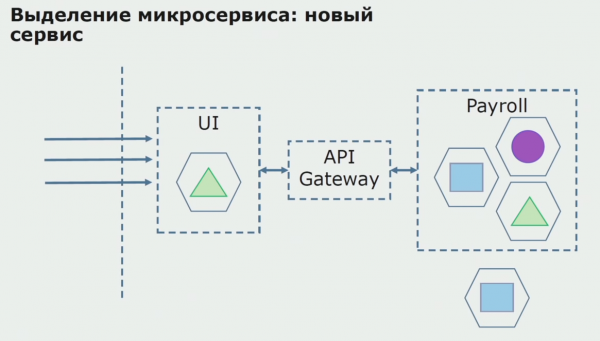
Ezután bevezetjük ezt a konfigurációt próbaüzemre. A felhasználóink többsége továbbra is a régi üzleti folyamatokkal dolgozik. Az új felhasználók számára kifejlesztjük a monolitikus alkalmazás új verzióját, amely már nem tartalmazza ezt a folyamatot. Lényegében a monolit és a mikroszolgáltatás egyaránt próbaüzemben működik.
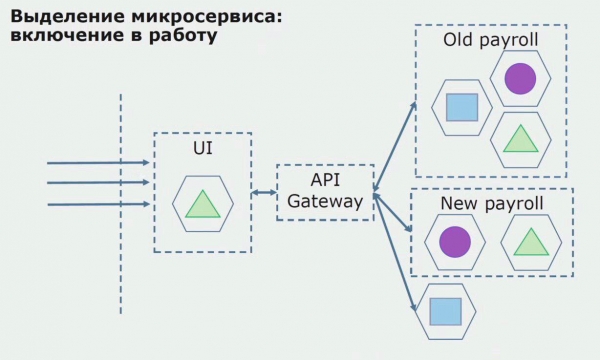
A sikeres próbaüzem során megértjük, hogy az új konfiguráció valóban működőképes, eltávolíthatjuk a régi monolitot, és az új konfigurációt a régi megoldás helyére állíthatjuk.
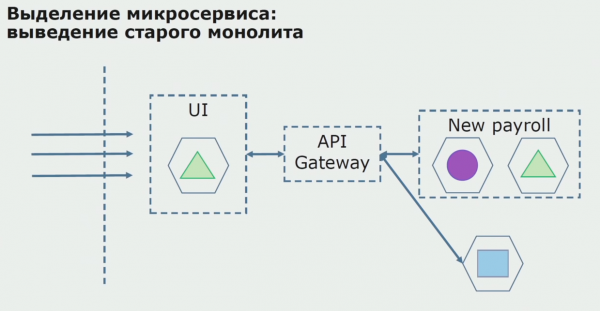
Összességében szinte minden meglévő módszert alkalmazunk a monolit forráskódjának elválasztására. Ezek mind csökkentik az alkalmazás részeinek méretét, és új könyvtárakra váltanak, javítva a forráskód minőségét.
Munka az adatbázissal
Az adatbázisunk nehezebben osztható szét, mint a forráskód, mivel nemcsak a jelenlegi sémát tartalmazza, hanem a felhalmozott történeti adatokat is.
Az adatbázisunknak, mint sok másnak, volt egy fontos hátránya is - hatalmas mérete. Ezt az adatbázist a monolit bonyolult üzleti logikájának megfelelően tervezték, és a különböző korlátozott kontextusok között összekapcsolódások halmozódtak fel a táblák között.
A mi esetünkben, a sok probléma (nagy adatbázis, számos kapcsolódás, néha érthetetlen határok a táblák között) mellett egy olyan probléma merült fel, amely sok nagy projektben előfordul: a megosztott adatbázis mintázat alkalmazása. Az adatok táblákból vettek át nézeten keresztül, replikációval, és más rendszerekbe kerültek, ahol szükség volt erre a replikációra. Ennek következtében nem tudtuk a táblákat külön sémába helyezni, mert aktívan használták őket.
A felosztásban segít nekünk a kódban alkalmazott korlátozott kontextusokra való bontás. Ez általában elegendően jó elképzelést ad arról, hogyan bontjuk le az adatokat az adatbázis szintjén. Megértjük, hogy mely táblák tartoznak egy korlátozott kontextushoz, és melyek tartoznak egy másikhoz.
Két globális adatbázis-sebességi módszert alkalmaztunk: a meglévő táblák elválasztása és a kidolgozással való elválasztás.
A meglévő táblák elválasztása olyan módszer, amelyet jól alkalmazhatunk, ha az adatszerkezet kiváló minőségű, megfelel az üzleti követelményeknek, és mindenki elégedett vele. Ebben az esetben külön séma alá helyezhetjük a meglévő táblákat.
A kidolgozással való elválasztás akkor szükséges, amikor az üzleti modell erősen megváltozott, és a táblák már egyáltalán nem felelnek meg az igényeinknek.
A meglévő táblák elválasztása. Meg kell határoznunk, hogy mit fogunk elválasztani. Enélkül a tudás nélkül semmi nem működik, és itt segíthet a kódban a korlátozott kontextusok elválasztása. Általánosságban elmondható, ha sikerül megérteni az eredeti kód kontextusainak határait, világossá válik, hogy mely táblák tartoznak az elválasztandók listájába.
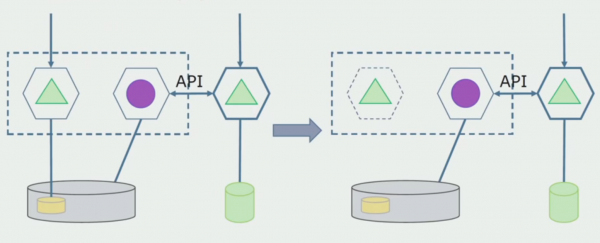
Képzeljük el, hogy van egy megoldásunk, ahol a monolit két modulja egy közös adatbázison dolgozik. Azt szeretnénk, hogy az elválasztott táblák egy részét csak egy modul érje el, míg a másik modul az API-n keresztül lépjen vele kapcsolatba. Kezdetben elegendő, ha csak írás történik az API-n keresztül. Ez szükséges feltétel ahhoz, hogy a mikroszolgáltatások függetlenségéről beszélhessünk. Az olvasási kapcsolatokat fenntarthatjuk, amíg ez nem jelent nagy problémát.
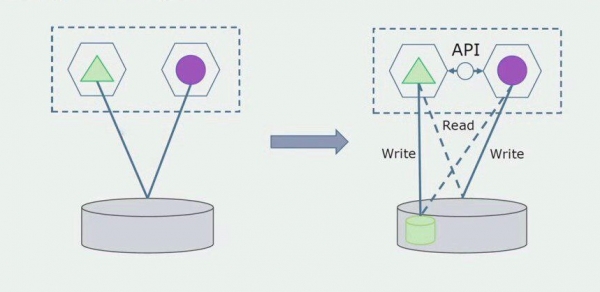
Következő lépésként az elválasztott táblákkal foglalkozó kódrészletet, akár kidolgozással, akár anélkül, külön mikroszolgáltatásként kiemelhetjük, és külön folyamatban, konténerben futtathatjuk. Ez egy külön szolgáltatás lesz, amely kapcsolatban áll a monolit adatbázisával és azokkal a táblákkal, amelyek közvetlenül nem tartoznak hozzá. A monolit továbbra is olvasási kapcsolaton van az elválasztott részleggel.
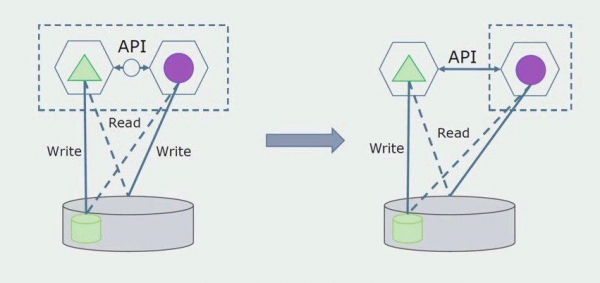
Később eltávolítjuk ezt a kapcsolatot, tehát a monolit alkalmazásból az elválasztott táblák adatait is átállítjuk API-ra.
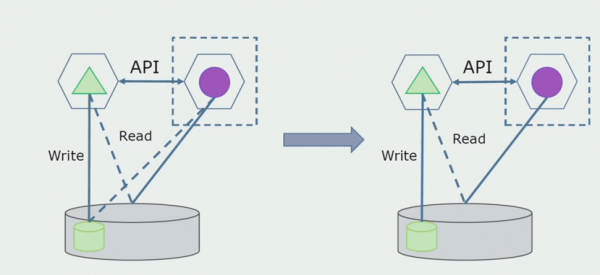
Ezután válasszuk el a közös adatbázisból azokat a táblákat, amelyekkel csak az új mikroszolgáltatás dolgozik. A táblákat kiemelhetjük egy külön sémába vagy akár egy külön fizikai adatbázisba is. Az olvasási kapcsolat továbbra is megmarad a mikroszolgáltatás és a monolit adatbázisa között, de ez nem nagy probléma, ebben a konfigurációban eléggé sokáig életképes maradhat.
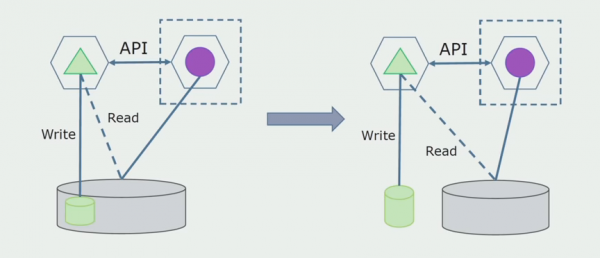
Az utolsó lépés a kapcsolatok teljes eltávolítása. Ebben az esetben lehet, hogy szükségünk lesz az adatbázis fő migrálására. Néha újra fel szeretnénk használni néhány, külső rendszerekből másolt adatot vagy referenciaértéket több adatbázisban. Ez időnként előfordul nálunk.
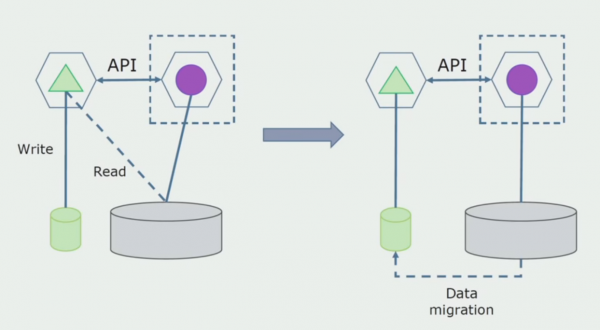
Átalakító osztály. Ez a módszer nagyon hasonló az elsőhöz, csak fordított sorrendben történik. Azonnal létrejön egy új adatbázis és egy új mikroservice, amely az API-n keresztül lép kapcsolatba a monolitikus rendszerrel. De közben megmarad egy adatbázis-táblák halmaza, amelyeket a jövőben szeretnénk eltávolítani. Erre már nincs szükség, az új modellben helyettesítettük.
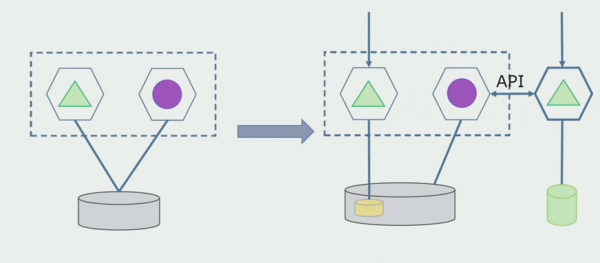
Ahhoz, hogy ez a séma működjön, valószínűleg szükség lesz egy átmeneti időszakra.
Ezután két lehetséges megközelítés áll rendelkezésre.
Az első: duplikáljuk az összes adatot az új és a régi adatbázisokban. Ebben az esetben adatduplicitás jön létre, szinkronizálási problémák léphetnek fel. De cserébe két különböző ügyfelet kezelhetünk. Az egyik az új verzióval dolgozik, a másik a régivel.
Második: az adatokat valamilyen üzleti jellemző alapján osztjuk szét. Például a rendszerünkben volt 5 termék, amely a régi adatbázisban tárolódott. A hatodikot egy új üzleti feladat keretében új adatbázisba helyezzük. De szükségünk lesz egy API Gateway-re, amely szinkronizálja ezeket az adatokat és megmutatja az ügyfélnek, honnan és mit kell venni.
Mindkét megközelítés működőképes, válasszon a helyzet függvényében.
Miután megbizonyosodtunk arról, hogy minden működik, a monolit egy részét, amely a régi adatbázis-struktúrákkal dolgozik, le lehet kapcsolni.
Az utolsó lépés a régi adattagok eltávolítása lesz.
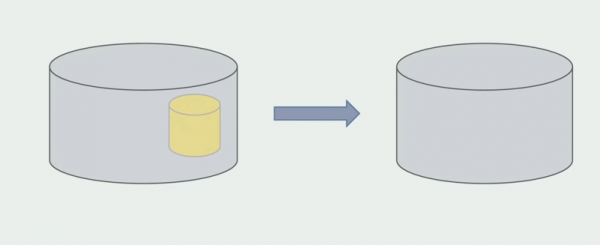
Összefoglalva elmondható, hogy adatbázissal kapcsolatos problémáink vannak: nehezebb vele dolgozni a forráskóddal összehasonlítva, nehezebb a szétválasztás, de megoldható és szükséges is. Találtunk néhány módszert, amelyek lehetővé teszik a biztonságos végrehajtást, végül is az adatokkal hibázni könnyebb, mint a forráskóddal.
Munka a forráskóddal
Így nézett ki a forráskód sémája, amikor elkezdtük elemezni a monolitikus projektet.
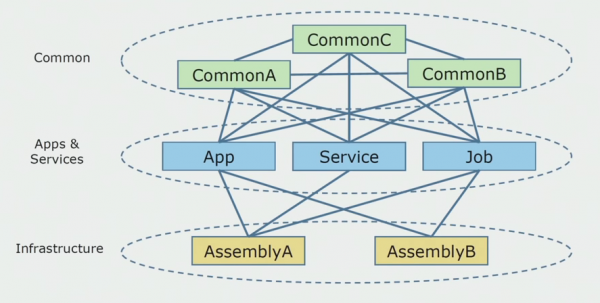
A rétegeket három részre lehet osztani. Az induló modulok, bővítmények, szolgáltatások és különböző tevékenységek rétegéről van szó. Valójában ezek voltak a bejutási pontok egy monolitikus megoldáson belül. Mindannyian szorosan kapcsolódtak a Common réteghez. Ebben volt a vállalati logika, amelyet a szolgáltatások közösen használtak, és számos kapcsolat. Minden szolgáltatás és bővítmény akár 10 vagy annál több közös komponenst használt, a méretüktől és a fejlesztők lelkiismeretétől függően.
Szerencsénk volt, mert voltak infrastrukturális könyvtáraink, amelyeket külön is lehetett használni.
Néha előfordult, hogy egyes Common objektumok valójában nem tartoztak ehhez a réteghez, hanem infrastrukturális könyvtárak voltak. Ezt átnevezéssel oldották meg.
A legnagyobb aggodalmat a korlátozott kontextusok okozták. Előfordult, hogy 3-4 kontextus keveredett egyetlen Common csomagban, és egymást használták egyes üzleti funkciók keretein belül. Meg kellett értenünk, hol lehet ezt szétválasztani és milyen határok mentén, valamint mit tegyünk a szétválasztás térképezésével a forráskód csomagokra.
Több szabályt fogalmaztunk meg a kód szétválasztásának folyamatára.
Első: már nem akartuk a vállalati logika közös használatát a szolgáltatások, tevékenységek és bővítmények között. Szerettük volna, ha a vállalati logika független legyen a mikroszolgáltatások keretein belül. Másrészről, a mikroszolgáltatások, elvileg, teljesen független szolgáltatásokként léteznek. Úgy érzem, hogy ez a megközelítés némileg pazarló, és nehezen elérhető, hiszen például a C#-on íródott szolgáltatások így is összekapcsolódnak a standard könyvtárral. A rendszerünk C#-ban készült, más technológiákat eddig még nem használtunk. Ezért úgy döntöttünk, hogy megengedhetjük magunknak a közös technikai csomagok használatát. A legfontosabb, hogy ne legyenek benne vállalati logika részletek. Ha van egy kényelmes burkoló az ORM-en, amit használsz, akkor nagyon költséges átmásolni azt szolgáltatásról szolgáltatásra.
Csapatunk a tárgyorientált tervezés híve, ezért a „hagymaarchitektúra” tökéletesen illeszkedik hozzánk. Szolgáltatásaink alapját nem az adatelérési réteg képezi, hanem egy domain logikából álló összesítés, amely csak az üzleti logikát tartalmazza, és mentes az infrastruktúrával való kapcsolatoktól. Ennek köszönhetően függetlenül tudjuk fejleszteni a domain összesítést a keretrendszerekkel kapcsolatos problémák megoldása érdekében.
Ebben a fázisban találkoztunk az első komoly problémával. A szolgáltatásnak egy domain összesítésre kellett hivatkoznia, a logikát függetlenként szerettük volna megvalósítani, és itt a DRY elv jelentősen akadályozott minket. A fejlesztők el akarták kerülni a duplikációt, ezért a szomszédos összesítésekből szerették volna újra felhasználni az osztályokat, és ennek következtében a domainek ismét összekapcsolódtak. Elemeztük az eredményeket, és úgy döntöttünk, hogy talán a probléma a forráskód tárolásának területén is rejlik. Volt egy nagy tárolónk, ahol minden forráskód megtalálható volt. Nagyon nehéz volt az egész projekthez megoldást létrehozni helyi gépen. Ezért a projekt egyes részeihez külön kicsi megoldásokat hoztunk létre, és senki sem tiltotta, hogy bármilyen közös vagy domain összesítést hozzáadjunk, és újra felhasználjuk. Az egyetlen eszköz, amely megakadályozta ezt, a kódellenőrzés volt. De néha ez is hibázott.
Ekkor elkezdtük átállni a külön tárolok modelljére. Az üzleti logika többé nem szivárgott át a szolgáltatások között, a domainek valóban függetlenné váltak. A korlátozott kontextusok sokkal világosabbak lettek. Hogyan használjuk fel ekkor az infrastruktúra könyvtárakat? Külön tárolóba helyeztük őket, majd Nuget-csomagokba zártuk, amelyeket az Artifactoryba helyeztünk. Bármilyen módosítás esetén a build és publikálás automatikusan történik.
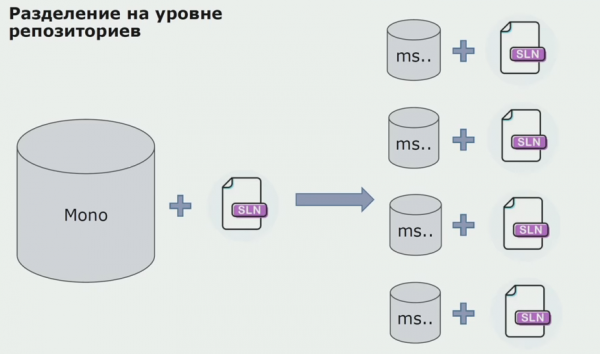
Szolgáltatásaink pontosan úgy hivatkoznak a belső infrastruktúra csomagokra, mint a külsőkre. A külső könyvtárakat a Nuget-ből töltjük le. Az Artifactoryval, ahová ezeket a csomagokat elhelyeztük, két csomagkezelőt alkalmaztunk. A kis tárolókban szintén Nugetet használtunk. A több szolgáltatást tartalmazó tárolókban a Paketet használtuk, amely nagyobb verzióegységességet biztosít a modulok között.
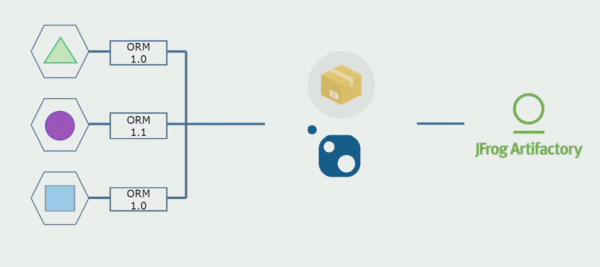
Ezért az alap kódon dolgozva, némi architektúra módosítással és a tárolók szétválasztásával a szolgáltatásaink függetlenebbé válnak.
Infrastruktúra problémák
A mikroszolgáltatásokra való áttérés során fellépő problémák többsége az infrastruktúrával kapcsolatos. Automatikus telepítésre lesz szükség, új könyvtárakra az infrastruktúra működéséhez.
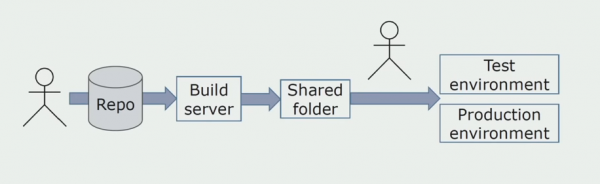
Kézi telepítés a környezetekbe
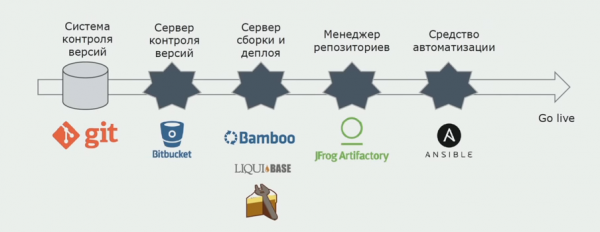
A környezetek telepítését kezdetben kézzel végeztük. Ennek a folyamatnak az automatizálásához CI/CD csővezetéket hoztunk létre. A folyamatos szállítást választottuk, mert a folyamatos telepítés jelenleg nem elfogadható számunkra az üzleti folyamatok szempontjából. Így a telepítés gombnyomásra történik, a tesztelés viszont automatikusan zajlik.
Az Atlassian, a Bitbucket adja a forráskódok tárolását, míg a Bamboo a buildeléshez szükséges. Szeretjük a Cake nyelvű build script-eket írni, mert az ugyanaz, mint a C#. Az Artifactory-ba már készen érkeznek a csomagok, és az Ansible automatikusan a tesztkiszolgálókra kerül, ahonnan azokat azonnal tesztelhetjük.
Külön loggolás
Egyszer, a monolit egyik ötlete a közös naplózás biztosítása volt. A különböző naplókkal is foglalkoznunk kellett, amelyek a lemezeken vannak. A naplóink text fájlokba íródnak. A standard ELK stack használatát döntöttük el. Nem akartunk közvetlenül az ELK-be írni a szolgáltatók révén, úgy döntöttünk, hogy kiegészítjük a szöveges naplókat, és a naplókba beírjuk a nyomozási azonosítót az azonosító formájában, hozzáadva a szolgáltatás nevét, hogy ezeket a naplókat később elemezni lehessen.
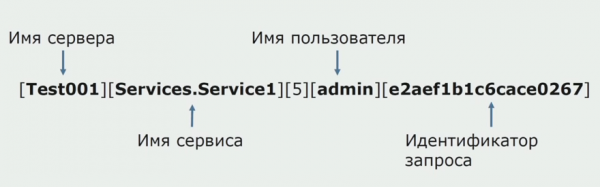
A Filebeat segítségével lehetőségünk nyílik a naplóink gyűjtésére, szerverek, majd azok átalakítására, a Kibana segítségével kérdéseket generálni a felhasználói felületen, és megfigyelni, hogyan zajlott a hívás a szolgáltatások között. Ezen nagyban segít a nyomozási azonosító.
Kapcsolódó szolgáltatások tesztelése és hibakeresése
Kezdetben nem teljesen értettük, hogyan kellene debug-olnunk a fejlesztett szolgáltatásokat. A monoliták esetében minden egyszerű volt, elindítottuk a helyi gépünkön. Eleinte hasonlóan próbálkoztunk a mikroszolgáltatásokkal is, de néha egy mikroszolgáltatás teljes indításához több másik indítása is szükséges, ami kényelmetlen. Rá kellett döbbennünk, hogy szükséges áttérni arra a modellre, amikor csak azokat a szolgáltatásokat tartjuk a helyi gépen, amelyeket debug-olni szeretnénk. A többi szolgáltatás a prod-konfigurációval megegyező szerverekről érhető el. A debugálás után, a tesztelés során, minden feladathoz a tesztkörnyezetre csak a módosított szolgáltatásokat telepítjük. Így a megoldás olyan formában kerül tesztelésre, ahogyan a jövőben a prodban is meg fog jelenni.
Vannak olyan szerverek, amelyeken csak a production verziók futnak. Ezek a szerverek szükségesek incidenst esetén, a telepítés előtti ellenőrzéshez és belső képzésekhez.
Hozzáadódott egy automatikus tesztelési folyamat a népszerű Specflow könyvtár segítségével. A teszteket automatikusan indítják az NUnit segítségével, közvetlenül az Ansible-ból való telepítés után. Ha a feladat teljesen automatizálva van, nincs szükség manuális tesztelésre. Bár időnként mégis szükséges a további manuális tesztelés. Azoknak a teszteknek a meghatározására, amelyeket egy adott feladathoz kell végrehajtani, a Jirában címkéket használunk.
Továbbá megnőtt az igény a terheléses tesztelés iránt, ami korábban csak ritkán történt. A tesztek futtatásához a JMeter-t használjuk, a tárolásukhoz az InfluxDB-t, és a folyamat grafikonjainak elkészítéséhez a Grafana-t.
Mit értünk el?
Először is megszabadultunk a 'kiadások' fogalmától. Megszűntek a két hónapos monstrum kiadások, amikor ez a nagy gépezet telepítve volt a production környezetbe, ideiglenesen tönkre téve az üzleti folyamatokat. Jelenleg átlagosan 1,5 naponta telepítünk szolgáltatásokat, csoportosítva őket, mivel csak azután indulnak be, hogy azokat jóváhagyták.
Rendszerünkben nincsenek fatális hibák. Ha egy mikroszolgáltatást hibával adunk ki, akkor az ehhez kapcsolódó funkcionalitás megsérül, de a többi funkcionalitás nem szenved károsodást. Ez jelentősen javítja a felhasználói élményt.
Keletkezett lehetőség van a telepítési séma kezelésére. Szükség esetén a szolgáltatáscsoportokat külön kezelhetjük a többi megoldástól.
Ezenkívül jelentősen csökkentettük a hosszú várólisták problémáját. Külön termékcsapatok jöttek létre, amelyek függetlenül dolgoznak egyes szolgáltatásokkal. A Scrum folyamat ebben az esetben jól alkalmazható. Egy konkrét csapatnak lehet külön termékfelelőse, aki feladatokat ad neki.
Összefoglaló
- A mikroszolgáltatások jól alkalmazhatók bonyolult rendszerek dekompozíciójára. A folyamat során kezdetben megértjük, mi van a rendszerünkben, milyen korlátozott kontextusok léteznek, hol vannak a határaik. Ez lehetővé teszi, hogy helyesen osszuk el a fejlesztéseket a modulok között, és elkerüljük a kód összezavarodását.
- A mikroszolgáltatások szervezeti előnyöket nyújtanak. Gyakran csak mint architektúráról beszélnek, de bármilyen architektúra a vállalkozás igényeinek kielégítésére szolgál, és nem önmagáért van. Ezért elmondhatjuk, hogy a mikroszolgáltatások jól alkalmasak kisebb csapatok feladatainak megoldására, figyelembe véve, hogy a Scrum nagyon népszerű jelenleg.
- A felosztás egy iteratív folyamat. Nem lehet csak úgy elvenni egy alkalmazást, és egyszerűen mikroszolgáltatásokra osztani. Az így kapott termék valószínűleg nem lesz működőképes. A mikroszolgáltatások kiemelése során érdemes átírni a meglévő örökséget, azaz olyan kódot létrehozni, amely tetszik nekünk, és jobban kielégíti az üzleti igényeket a funkcionalitás és a sebesség szempontjából.
Egy kis figyelmeztetés: a mikroszolgáltatásokra való átállás költségei meglehetősen jelentősek. Csak az infrastruktúra problémáinak megoldására is sok időt fordítottunk. Ezért ha van egy kis alkalmazása, amely nem igényel speciális méretezést, és nincs sok ügyfele, akik harcolnak a csapata figyelméért és idejéért, akkor lehet, hogy a mikroszolgáltatások nem szükségesek Önnek ma. Ez elég drága. Ha a mikroszolgáltatásokkal kezdi el a folyamatot, akkor a költségek kezdetben magasabbak lesznek, mint ha ugyanazt a projektet monolit fejlesztéssel indítaná.
P.S. Egy érzelmibb elmondás (mintha személyesen Önnek szólnék) – itt .
Itt van a beszámoló teljes verziója.
Forrás: habr.com
