

KDB+, uzņēmuma produkts ir šaurās aprindās plaši pazīstama, īpaši ātra, kolonnu datubāze, kas paredzēta laika rindu un uz tām balstītu analītisko aprēķinu glabāšanai. Sākotnēji tas bija (un ir) ļoti populārs finanšu nozarē – to izmanto visas top 10 investīciju bankas un daudzi pazīstami riska ieguldījumu fondi, biržas un citas organizācijas. Nesen KX nolēma paplašināt savu klientu loku un tagad piedāvā risinājumus citās jomās, kur ir liels datu apjoms, kas sakārtots pēc laika vai kā citādi – telekomunikācijā, bioinformātikā, ražošanā u.c. Viņi arī kļuva par Aston Martin Red Bull Racing komandas partneri Formulā 1, kur viņi palīdz vākt un apstrādāt datus no automašīnu sensoriem un analizēt vēja tuneļa testus. Šajā rakstā es vēlos jums pastāstīt, kādas KDB+ funkcijas padara to par izcilu veiktspēju, kāpēc uzņēmumi ir gatavi par to tērēt daudz naudas un visbeidzot, kāpēc tā īsti nav datubāze.
Šajā rakstā mēģināšu vispārīgi pastāstīt, kas ir KDB+, kādas tam ir iespējas un ierobežojumi un kādi ir tā ieguvumi uzņēmumiem, kuri vēlas apstrādāt lielu datu apjomu. Neiedziļināšos ne KDB+ ieviešanas detaļās, ne tās Q programmēšanas valodas detaļās.Abas šīs tēmas ir ļoti plašas un ir pelnījušas atsevišķus rakstus. Daudz informācijas par šīm tēmām var atrast vietnē code.kx.com, tostarp grāmatu par mirstīgajiem jautājumiem (skatiet saiti zemāk).
Daži termini
- Atmiņas datu bāze. Datu bāze, kas glabā datus RAM ātrākai piekļuvei. Priekšrocības šādai datubāzei ir nepārprotamas, bet trūkumi ir datu zuduma iespēja un nepieciešamība serverī būt daudz atmiņas.
- Kolonnu datubāze. Datu bāze, kurā dati tiek glabāti pēc kolonnas, nevis ieraksti pēc ieraksta. Šādas datu bāzes galvenā priekšrocība ir tā, ka dati no vienas kolonnas tiek glabāti kopā diskā un atmiņā, kas ievērojami paātrina piekļuvi tai. Nav nepieciešams ielādēt kolonnas, kuras vaicājumā netiek izmantotas. Galvenais trūkums ir tas, ka ir grūti modificēt un dzēst ierakstus.
- Laika rindas. Dati ar datuma vai laika kolonnu. Parasti šādiem datiem ir svarīga laika secība, lai jūs varētu viegli noteikt, kurš ieraksts ir pirms vai pēc pašreizējā, vai arī izmantot funkcijas, kuru rezultāti ir atkarīgi no ierakstu secības. Klasiskās datu bāzes ir veidotas pēc pavisam cita principa – ierakstu kolekcijas attēlošana kā kopa, kur ierakstu secība principā nav noteikta.
- Vektors. KDB+ kontekstā tas ir viena un tā paša atomu tipa elementu saraksts, piemēram, skaitļi. Citiem vārdiem sakot, elementu masīvs. Masīvus, atšķirībā no sarakstiem, var kompakti glabāt un apstrādāt, izmantojot vektoru procesora instrukcijas.
Vēsturiskā informācija
KX 1993. gadā nodibināja Arturs Vitnijs, kurš iepriekš strādāja Morgan Stanley Bank pie A+ valodas, kas ir APL pēctece – ļoti oriģināla un savulaik populāra valoda finanšu pasaulē. Protams, KX Artūrs turpināja tādā pašā garā un radīja vektorfunkcionālo valodu K, vadoties pēc radikālā minimālisma idejām. K programmas izskatās kā pieturzīmju un speciālo rakstzīmju juceklis, zīmju un funkciju nozīme ir atkarīga no konteksta, un katrai darbībai ir daudz lielāka nozīme nekā parastajās programmēšanas valodās. Šī iemesla dēļ K programma aizņem minimālu vietu — dažas rindiņas var aizstāt teksta lappuses tādā izteiksmīgā valodā kā Java — un tā ir īpaši koncentrēta algoritma ieviešana.
Funkcija K, kas īsteno lielāko daļu LL1 parsētāja ģeneratora saskaņā ar doto gramatiku:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/:1_r),"]";""]]}
Artūrs iemiesoja šo ārkārtējas efektivitātes filozofiju ar minimālām ķermeņa kustībām KDB+, kas parādījās 2003. gadā (manuprāt, tagad ir skaidrs, no kurienes nosaukumā nāk burts K) un ir nekas vairāk kā K ceturtās versijas tulks. K K ir pievienota lietotājam draudzīgāka versija ar nosaukumu Q. Q ir pievienots arī atbalsts noteiktam SQL dialektam - QSQL, bet tulks - atbalsts tabulām kā sistēmas datu tipam, rīki darbam ar tabulām atmiņā un diskā utt.
Tātad no lietotāja viedokļa KDB+ ir vienkārši Q valodas tulks, kas atbalsta tabulas un SQL līdzīgas LINQ stila izteiksmes no C#. Šī ir vissvarīgākā atšķirība starp KDB+ un citām datu bāzēm un tās galvenā konkurences priekšrocība, kas bieži tiek ignorēta. Šī nav datu bāze + atspējota palīgvaloda, bet gan pilnvērtīga jaudīga programmēšanas valoda + iebūvēts datu bāzes funkciju atbalsts. Šai atšķirībai būs izšķiroša nozīme visu KDB+ priekšrocību uzskaitīšanā. Piemēram…
Izmērs
Pēc mūsdienu standartiem KDB+ ir vienkārši mikroskopiska izmēra. Tas ir burtiski viens apakšmegabaitu izpildāmais fails un viens neliels teksta fails ar dažām sistēmas funkcijām. Reāli – mazāk par vienu megabaitu, un par šo programmu kompānijas maksā desmitiem tūkstošu dolāru gadā par vienu procesoru serverī.
- Šis izmērs ļauj KDB+ lieliski justies uz jebkuras aparatūras — no Pi mikrodatora līdz serveriem ar terabaitiem atmiņu. Tas nekādā veidā neietekmē funkcionalitāti, turklāt Q tiek startēts uzreiz, kas ļauj to cita starpā izmantot kā skriptu valodu.
- Šādā izmērā Q tulks pilnībā iekļaujas procesora kešatmiņā, kas paātrina programmas izpildi.
- Ar šādu izpildāmā faila lielumu Q process aizņem nenozīmīgu vietu atmiņā; jūs varat palaist simtiem to. Turklāt, ja nepieciešams, Q var darboties ar desmitiem vai simtiem gigabaitu atmiņas vienā procesā.
daudzpusība
Q ir lieliski piemērots plašam lietojumu klāstam. Process Q var darboties kā vēsturiska datubāze un nodrošināt ātru piekļuvi terabaitiem informācijas. Piemēram, mums ir desmitiem vēsturisku datu bāzu, no kurām dažās vienas nesaspiestas dienas datu apjoms aizņem vairāk nekā 100 gigabaitus. Tomēr, ievērojot saprātīgus ierobežojumus, vaicājums datu bāzei tiks pabeigts desmitiem līdz simtiem milisekundēs. Kopumā mums ir universāls taimauts lietotāju pieprasījumiem - 30 sekundes - un tas darbojas ļoti reti.
Q tikpat viegli varētu būt atmiņā esoša datu bāze. Jauni dati tiek pievienoti atmiņā esošajām tabulām tik ātri, ka lietotāju pieprasījumi ir ierobežojošais faktors. Dati tabulās tiek glabāti kolonnās, kas nozīmē, ka jebkura darbība kolonnā izmantos procesora kešatmiņu ar pilnu jaudu. Papildus tam KX mēģināja ieviest visas pamata darbības, piemēram, aritmētiku, izmantojot procesora vektora instrukcijas, maksimāli palielinot to ātrumu. Q var veikt arī uzdevumus, kas nav raksturīgi datu bāzēm - piemēram, apstrādāt straumēšanas datus un aprēķināt “reālā laikā” (ar aizkavi no desmitiem milisekundēm līdz vairākām sekundēm atkarībā no uzdevuma) dažādas finanšu instrumentu apkopošanas funkcijas dažādam laikam. intervālos vai izveidot modeli perfektu darījumu ietekmei uz tirgu un veikt tā profilēšanu gandrīz uzreiz pēc tā pabeigšanas. Šādos uzdevumos visbiežāk galvenā laika aizkave nav Q, bet gan nepieciešamība sinhronizēt datus no dažādiem avotiem. Liels ātrums tiek panākts, pateicoties tam, ka dati un funkcijas, kas tos apstrādā, atrodas vienā procesā, un apstrāde tiek reducēta līdz vairāku QSQL izteiksmju un savienojumu izpildei, kuras netiek interpretētas, bet tiek izpildītas ar bināro kodu.
Visbeidzot, Q varat ierakstīt jebkurus pakalpojumu procesus. Piemēram, Gateway apstrādā, kas automātiski izplata lietotāju pieprasījumus nepieciešamajām datu bāzēm un serveriem. Programmētājam ir pilnīga brīvība ieviest jebkuru balansēšanas, prioritāšu noteikšanas, kļūdu tolerances, piekļuves tiesību, kvotu un būtībā jebko citu algoritmu, ko viņa sirds vēlas. Galvenā problēma šeit ir tā, ka jums tas viss būs jāīsteno pašam.
Kā piemēru es uzskaitīšu, kādi procesi mums ir. Tās visas tiek aktīvi izmantotas un darbojas kopā, apvienojot desmitiem dažādu datu bāzu vienā, apstrādājot datus no vairākiem avotiem un apkalpojot simtiem lietotāju un lietojumprogrammu.
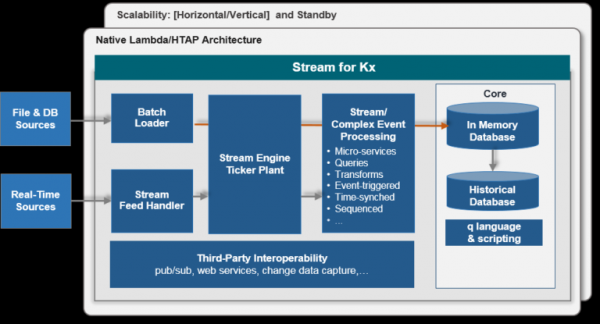
- Savienotāji (padeves apstrādātājs) ar datu avotiem. Šajos procesos parasti tiek izmantotas ārējās bibliotēkas, kas tiek ielādētas Q. C interfeiss programmā Q ir ļoti vienkāršs un ļauj viegli izveidot starpniekservera funkcijas jebkurai C/C++ bibliotēkai. Q ir pietiekami ātrs, lai apstrādātu, piemēram, FIX ziņojumu plūdus no visām Eiropas biržām vienlaicīgi.
- Datu izplatītāji (tickerplant), kas kalpo kā starpposms starp savienotājiem un patērētājiem. Tajā pašā laikā viņi ieraksta ienākošos datus īpašā binārā žurnālā, nodrošinot patērētājiem izturību pret savienojuma zudumiem vai restartēšanu.
- Atmiņā esošā datu bāze (rdb). Šīs datu bāzes nodrošina ātrāko iespējamo piekļuvi neapstrādātiem, svaigiem datiem, saglabājot tos atmiņā. Parasti tie uzkrāj datus tabulās dienas laikā un atiestata tos naktī.
- Pastāvīga datu bāze (pdb). Šīs datu bāzes nodrošina, ka šodienas dati tiek glabāti vēsturiskā datu bāzē. Parasti, atšķirībā no rdb, tie neuzglabā datus atmiņā, bet izmanto īpašu kešatmiņu diskā dienas laikā un kopē datus pusnaktī uz vēsturisko datu bāzi.
- Vēsturiskās datu bāzes (hdb). Šīs datu bāzes nodrošina piekļuvi datiem par iepriekšējām dienām, mēnešiem un gadiem. To lielumu (dienās) ierobežo tikai cieto disku izmērs. Datus var atrast jebkur, jo īpaši dažādos diskos, lai paātrinātu piekļuvi. Ir iespējams saspiest datus, izmantojot vairākus algoritmus, no kuriem izvēlēties. Datu bāzes struktūra ir labi dokumentēta un vienkārša, dati tiek glabāti pa kolonnai parastajos failos, lai tos varētu apstrādāt, tostarp ar operētājsistēmas palīdzību.
- Datu bāzes ar apkopotu informāciju. Tie glabā dažādus apkopojumus, parasti ar, sagrupēti pēc instrumenta nosaukuma un laika intervāla. Atmiņā esošās datu bāzes atjaunina savu stāvokli ar katru ienākošo ziņojumu, un vēsturiskās datu bāzes saglabā iepriekš aprēķinātus datus, lai paātrinātu piekļuvi vēsturiskajiem datiem.
- Visbeidzot, vārtejas procesilietojumprogrammu un lietotāju apkalpošana. Q ļauj ieviest pilnīgi asinhronu ienākošo ziņojumu apstrādi, to sadali pa datu bāzēm, piekļuves tiesību pārbaudi utt. Ņemiet vērā, ka ziņojumi nav ierobežoti un visbiežāk tie nav SQL izteiksmes, kā tas ir citās datu bāzēs. Visbiežāk SQL izteiksme tiek paslēpta īpašā funkcijā un tiek konstruēta, balstoties uz lietotāja pieprasītajiem parametriem - laiks tiek konvertēts, filtrēts, dati tiek normalizēti (piemēram, akciju cena tiek izlīdzināta, ja tika izmaksātas dividendes) utt.
Tipiska arhitektūra vienam datu tipam:
Ātrums
Lai gan Q ir interpretēta valoda, tā ir arī vektorvaloda. Tas nozīmē, ka daudzas iebūvētās funkcijas, īpaši aritmētiskās, ņem jebkuras formas argumentus - skaitļus, vektorus, matricas, sarakstus - un programmētājam ir jāīsteno programma kā masīva darbības. Šādā valodā, ja pievienojat divus vektorus no miljona elementiem, vairs nav nozīmes, vai valoda tiek interpretēta, pievienošanu veiks superoptimizēta binārā funkcija. Tā kā Q programmās lielākā daļa laika tiek pavadīta darbībām ar tabulām, kurās tiek izmantotas šīs vektorizētās pamatfunkcijas, izvade ir ļoti pieklājīgs darbības ātrums, kas ļauj apstrādāt milzīgu datu apjomu pat vienā procesā. Tas ir līdzīgi Python matemātiskajām bibliotēkām — lai gan Python pati par sevi ir ļoti lēna valoda, tajā ir daudz izcilu bibliotēku, piemēram, numpy, kas ļauj apstrādāt skaitliskos datus kompilētas valodas ātrumā (starp citu, numpy ir ideoloģiski tuvu Q. ).
Turklāt KX ļoti rūpīgi pievērsās tabulu izstrādei un darba ar tām optimizēšanai. Pirmkārt, tiek atbalstīti vairāki indeksu veidi, kurus atbalsta iebūvētās funkcijas un kurus var pielietot ne tikai tabulas kolonnām, bet arī jebkuriem vektoriem - grupēšanai, šķirošanai, unikalitātes atribūtam un īpašai grupēšanai vēsturiskām datu bāzēm. Indekss tiek lietots vienkārši un tiek automātiski pielāgots, pievienojot elementus kolonnai/vektoram. Indeksus var vienlīdz veiksmīgi piemērot tabulas kolonnām gan atmiņā, gan diskā. Izpildot QSQL vaicājumu, indeksi tiek izmantoti automātiski, ja iespējams. Otrkārt, darbs ar vēsturiskajiem datiem tiek veikts, izmantojot OS failu parādīšanas mehānismu (atmiņas karti). Lielas tabulas nekad netiek ielādētas atmiņā, tā vietā vajadzīgās kolonnas tiek kartētas tieši atmiņā un reāli tiek ielādēta tikai tā daļa (šeit palīdz arī indeksi), kas ir nepieciešama. Programmētājam nav nozīmes, vai dati ir atmiņā vai nav, mehānisms darbam ar mmap ir pilnībā paslēpts Q dziļumos.
KDB+ nav relāciju datu bāze; tabulās var būt patvaļīgi dati, savukārt rindu secība tabulā nemainās, pievienojot jaunus elementus, un to var un vajadzētu izmantot, rakstot vaicājumus. Šī funkcija ir steidzami nepieciešama darbam ar laika rindām (dati no apmaiņām, telemetrija, notikumu žurnāli), jo, ja dati ir sakārtoti pēc laika, tad lietotājam nav jāizmanto nekādi SQL triki, lai atrastu pirmo vai pēdējo rindu vai N tabulas rindas , nosakiet, kura rinda seko N. rindai utt. Tabulu savienošana ir vēl vairāk vienkāršota, piemēram, pēdējā citāta atrašana 16000 500 VOD.L (Vodafone) transakcijām XNUMX miljonu elementu tabulā aizņem apmēram sekundi diskā un desmitiem milisekundes atmiņā.
Laika savienojuma piemērs - citātu tabula tiek kartēta uz atmiņu, tāpēc nav nepieciešams norādīt VOD.L kur, tiek netieši izmantots simbols kolonnā esošais indekss un fakts, ka dati ir sakārtoti pēc laika. Gandrīz visi savienojumi Q ir regulāras funkcijas, nevis atlasītās izteiksmes daļa:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Visbeidzot, ir vērts atzīmēt, ka KX inženieri, sākot ar pašu Arturu Vitniju, ir patiesi apsēsti ar efektivitāti un dara visu iespējamo, lai maksimāli izmantotu Q standarta funkcijas un optimizētu visizplatītākos lietošanas modeļus.
Kopsavilkums
KDB+ ir populārs uzņēmumu vidū galvenokārt tās izcilās daudzpusības dēļ – tā vienlīdz labi kalpo gan kā atmiņas datubāze, gan kā datubāze terabaitu vēsturisko datu glabāšanai, gan kā datu analīzes platforma. Pateicoties tam, ka datu apstrāde notiek tieši datu bāzē, tiek panākts liels darba ātrums un resursu ietaupījums. Pilnvērtīga programmēšanas valoda, kas integrēta ar datu bāzes funkcijām, ļauj vienā platformā realizēt visu nepieciešamo procesu kaudzi – no datu saņemšanas līdz lietotāju pieprasījumu apstrādei.
Lai iegūtu vairāk informācijas,
Ierobežojumi
Būtisks KDB+/Q trūkums ir augstais ienākšanas slieksnis. Valodai ir dīvaina sintakse, dažas funkcijas ir stipri pārslogotas (vērtībai, piemēram, ir aptuveni 11 lietošanas gadījumi). Pats galvenais, tas prasa radikāli atšķirīgu pieeju programmu rakstīšanai. Vektoru valodā vienmēr jādomā par masīvu pārveidojumiem, jārealizē visas cilpas, izmantojot vairākus kartēšanas/samazināšanas funkciju variantus (ko Q sauc par apstākļa vārdiem), un nekad nemēģiniet ietaupīt naudu, aizstājot vektora darbības ar atomu operācijām. Piemēram, lai atrastu masīvā elementa N-tās parādības indeksu, jums jāraksta:
1. (where element=vector)[N]
lai gan tas šķiet šausmīgi neefektīvi pēc C/Java standartiem (= izveido Būla vektoru, kur atgriež tajā esošo elementu patiesos indeksus). Bet šis apzīmējums padara izteiksmes nozīmi skaidrāku, un jūs izmantojat ātras vektora darbības, nevis lēnas atomu darbības. Konceptuālā atšķirība starp vektoru valodu un citām ir salīdzināma ar atšķirību starp obligātajām un funkcionālajām programmēšanas pieejām, un jums ir jābūt tam gatavam.
Daži lietotāji arī nav apmierināti ar QSQL. Lieta ir tāda, ka tas tikai izskatās pēc īsta SQL. Patiesībā tas ir tikai SQL līdzīgu izteiksmju tulks, kas neatbalsta vaicājumu optimizāciju. Lietotājam pašam jāraksta optimālie vaicājumi, turklāt Q, kam daudzi nav gatavi. No otras puses, protams, jūs vienmēr varat uzrakstīt optimālo vaicājumu pats, nevis paļauties uz melnās kastes optimizētāju.
Kā pluss ir tas, ka grāmata par Q - Q For Martals ir pieejama bez maksas vietnē , tur ir savākts arī daudz citu noderīgu materiālu.
Vēl viens liels trūkums ir licences izmaksas. Tas ir desmitiem tūkstošu dolāru gadā uz vienu centrālo procesoru. Šādus izdevumus var atļauties tikai lielie uzņēmumi. Pēdējā laikā KX ir padarījis savu licencēšanas politiku elastīgāku un sniedz iespēju maksāt tikai par lietošanas laiku vai nomāt KDB+ Google un Amazon mākoņos. KX piedāvā arī lejupielādi (32 bitu versija vai 64 bitu pēc pieprasījuma).
konkurenti
Ir diezgan daudz specializētu datu bāzu, kas veidotas pēc līdzīgiem principiem – kolonnveida, iebūvētas atmiņā, fokusētas uz ļoti lielu datu apjomu. Problēma ir tā, ka tās ir specializētas datu bāzes. Spilgts piemērs ir Clickhouse. Šai datubāzei ir ļoti līdzīgs princips KDB+ datu glabāšanai diskā un indeksa veidošanai; tā veic dažus vaicājumus ātrāk nekā KDB+, lai gan ne ievērojami. Bet pat kā datu bāze Clickhouse ir vairāk specializēta nekā KDB+ - tīmekļa analītika pret patvaļīgām laikrindām (šī atšķirība ir ļoti svarīga - tās dēļ, piemēram, Clickhouse nav iespējams izmantot ierakstu secību). Bet, pats galvenais, Clickhouse nepiemīt KDB+ daudzpusība, valoda, kas ļautu apstrādāt datus tieši datu bāzē, nevis vispirms ielādēt tos atsevišķā lietojumprogrammā, veidot patvaļīgas SQL izteiksmes, lietot patvaļīgas funkcijas vaicājumā, veidot procesus. nav saistīts ar vēsturisko datu bāzes funkciju izpildi . Tāpēc ir grūti salīdzināt KDB+ ar citām datu bāzēm, tās var būt labākas atsevišķos lietošanas gadījumos vai vienkārši labākas, ja runa ir par klasiskajiem datu bāzes uzdevumiem, bet es nezinu citu tikpat efektīvu un daudzpusīgu rīku pagaidu datu apstrādei.
Python integrācija
Lai padarītu KDB+ vieglāk lietojamu cilvēkiem, kas nav pazīstami ar šo tehnoloģiju, KX izveidoja bibliotēkas, lai cieši integrētos ar Python vienā procesā. Varat izsaukt jebkuru Python funkciju no Q vai otrādi - izsaukt jebkuru Q funkciju no Python (jo īpaši QSQL izteiksmes). Bibliotēkas vajadzības gadījumā (ne vienmēr efektivitātes nolūkos) konvertē datus no vienas valodas formāta uz citas valodas formātu. Rezultātā Q un Python dzīvo tik ciešā simbiozē, ka robežas starp tiem ir izplūdušas. Rezultātā programmētājam, no vienas puses, ir pilna piekļuve daudzām noderīgām Python bibliotēkām, no otras puses, viņš saņem ātru bāzi darbam ar lielajiem datiem, kas integrēti Python, kas ir īpaši noderīgi tiem, kas iesaistīti mašīnmācībā. vai modelēšana.
Darbs ar Q Python:
1. >>> q()
2.q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
atsauces
Uzņēmuma vietne -
Vietne izstrādātājiem -
Q grāmata mirstīgajiem (angļu valodā) -
Raksti par KDB+/Q pieteikumiem no kx darbiniekiem -
Avots: www.habr.com
