

Filozofisks ievads
Kā zināms, problēmu risināšanai ir tikai divas metodes:
- Analīzes metode vai atskaitīšanas metode, vai no vispārīgas uz konkrētu.
- Sintēzes metode vai indukcijas metode, vai no īpaša uz vispārīgu.
Lai atrisinātu problēmu “uzlabot datu bāzes veiktspēju”, tas varētu izskatīties šādi.
Analīze — mēs analizējam problēmu atsevišķās daļās un, tās risinot, cenšamies uzlabot datubāzes darbību kopumā.
Praksē analīze izskatās apmēram šādi:
- Rodas problēma (veiktspējas incidents)
- Statistikas informācijas vākšana par datu bāzes stāvokli
- Meklē vājās vietas
- Mēs risinām problēmas no vājajām vietām
Datu bāzes vājās vietas — infrastruktūra (CPU, atmiņa, diski, tīkls, OS), iestatījumi (postgresql.conf), vaicājumi:
Infrastruktūra: Ietekmes un pārmaiņu iespējas inženierim ir gandrīz nulle.
Datu bāzes iestatījumi: izmaiņu iespējas ir nedaudz lielākas nekā iepriekšējā gadījumā, taču parasti tās joprojām ir diezgan sarežģītas, it īpaši mākoņos.
pieprasījumi uz datu bāzi: tikai manevra telpa.
Sintēze — uzlabojam atsevišķu daļu veiktspēju, sagaidot, ka rezultātā uzlabosies datu bāzes veiktspēja.
Lirisks ievads jeb kāpēc tas viss vajadzīgs
Kāds ir veiktspējas incidentu atrisināšanas process, ja netiek pārraudzīta datu bāzes veiktspēja:
Klients - "pie mums viss ir slikti, tas aizņem pārāk ilgu laiku, izdariet kaut ko labu mūsu labā"
Inženieris - "cik tas ir slikti?"
Klients – “tā ir tagad (pirms stundas, vakar, pēdējo reizi), lēnām”
Inženieris - "kad bija labi?"
Klients – “Pirms nedēļas (divām nedēļām) nebija slikti. "(Tā ir paveicies)
Klients - “Es neatceros, kad bija labi, bet tagad ir slikti” (parastā atbilde)
Rezultāts ir klasisks attēls:
Kas ir vainīgs un ko darīt?
Uz pirmo jautājuma daļu ir visvieglāk atbildēt – DBA inženieris vienmēr ir vainīgs.
Arī uz otro daļu nav pārāk grūti atbildēt – jāievieš datu bāzes veiktspējas uzraudzības sistēma.
Rodas pirmais jautājums - ko uzraudzīt?
Ceļš 1. Mēs uzraudzīsim VISU
CPU slodze, diska lasīšanas/rakstīšanas operāciju skaits, piešķirtās atmiņas lielums un vēl viena megatonna dažādu skaitītāju, ko var nodrošināt jebkura vairāk vai mazāk strādājoša uzraudzības sistēma.
Rezultāts ir virkne grafiku, kopsavilkuma tabulu un nepārtrauktu e-pasta paziņojumu un 100% aizņemts inženieris, kas atrisina virkni identisku biļešu, taču parasti ar standarta formulējumu - “Pagaidu problēma. Nav nepieciešama nekāda darbība. ” Bet visi ir aizņemti, un vienmēr ir ko parādīt klientam – darbs rit pilnā sparā.
2. veids. Uzraudzīt tikai to, kas ir nepieciešams, un tas, kas nav vajadzīgs, nav jāuzrauga
Nedaudz savādāk varat pārraudzīt tikai entītijas un notikumus:
- Kuru DBA inženieris var ietekmēt
- Kam ir darbību algoritms, kad notiek notikums vai mainās entītija.
Pamatojoties uz šo pieņēmumu un atceroties "Filozofisks ievads"lai izvairītos no regulāras atkārtošanās"Lirisks ievads jeb kāpēc tas viss vajadzīgs“Būtu ieteicams uzraudzīt atsevišķu vaicājumu veiktspēju optimizēšanai un analīzei, kam galu galā vajadzētu uzlabot visas datu bāzes veiktspēju.
Bet, lai uzlabotu smago vaicājumu, kas ietekmē kopējo datu bāzes veiktspēju, vispirms tas ir jāatrod.
Tātad rodas divi savstarpēji saistīti jautājumi:
- kurš pieprasījums tiek uzskatīts par grūtu
- kā meklēt sarežģītus vaicājumus.
Acīmredzot smags vaicājums ir vaicājums, kas izmanto daudz OS resursu, lai iegūtu rezultātu.
Pāriesim pie otrā jautājuma — kā meklēt un pēc tam pārraudzīt smagus vaicājumus?
Kādas vaicājumu uzraudzības iespējas ir PostgreSQL?
Salīdzinot ar Oracle, ir maz iespēju, bet tomēr kaut ko var izdarīt.
PG_STAT_STATEMENTS
Lai meklētu un pārraudzītu smagus vaicājumus programmā PostgreSQL, ir paredzēts standarta paplašinājums pg_stat_statements.
Pēc paplašinājuma instalēšanas mērķa datu bāzē tiek parādīts skats ar tādu pašu nosaukumu, kas jāizmanto uzraudzības nolūkos.
Uzraudzības sistēmas izveidei atlasiet pg_stat_statements kolonnas:
- queryid Iekšējais jaucējkods, kas aprēķināts no operatora parsēšanas koka
- max_time Maksimālais laiks, kas pavadīts paziņojumam, milisekundēs
Uzkrājot un izmantojot statistiku par šīm divām kolonnām, varat izveidot uzraudzības sistēmu.
Kā pg_stat_statements tiek izmantots, lai uzraudzītu PostgreSQL veiktspēju
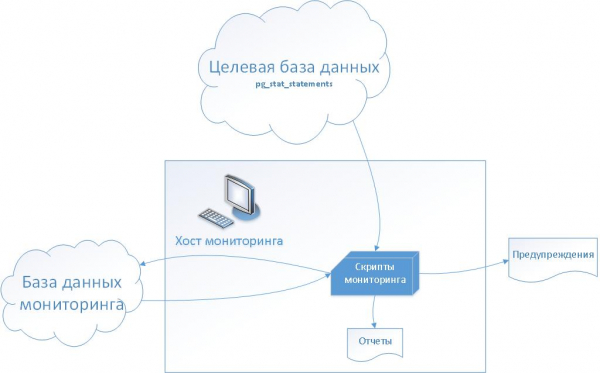
Lai pārraudzītu vaicājuma veiktspēju, izmantojiet:
Mērķa datu bāzes pusē - pg_stat_statements skats
No malas serveris un uzraudzības datubāzes — bash skriptu un pakalpojumu tabulu kopums.
1. posms - statistikas datu vākšana
Uzraudzības resursdatorā cron regulāri tiek palaista skripts, kas kopē pg_stat_statements skata saturu no mērķa datu bāzes uz pg_stat_history tabulu uzraudzības datu bāzē.
Tādējādi tiek izveidota atsevišķu vaicājumu izpildes vēsture, ko var izmantot veiktspējas pārskatu ģenerēšanai un metrikas konfigurēšanai.
2. posms — veiktspējas rādītāju iestatīšana
Pamatojoties uz savāktajiem datiem, mēs atlasām vaicājumus, kuru izpilde klientam (lietojumprogrammai) ir viskritiskākā/svarīgākā. Vienojoties ar klientu, mēs iestatām veiktspējas rādītāju vērtības, izmantojot laukus queryid un max_time.
Rezultāts - darbības pārraudzības sākums
- Pārraudzības skripts, kad tas tiek izpildīts, pārbauda konfigurētās veiktspējas metriku, salīdzinot metrikas vērtību max_time ar vērtību no pg_stat_statements skata mērķa datubāzē.
- Ja vērtība mērķa datu bāzē pārsniedz metrikas vērtību, tiek ģenerēts brīdinājums (negadījums biļešu sistēmā).
1. papildu iespēja
Vaicājumu plāna vēsture
Lai vēlāk palīdzētu atrisināt veiktspējas incidentus, ieteicams iepriekš mainīt vaicājumu izpildes plānus.
Pakalpojuma tabula log_query tiek izmantota vēstures glabāšanai. Tabula tiek aizpildīta, analizējot ielādēto PostgreSQL žurnālfailu. Tā kā žurnālfailā, atšķirībā no pg_stat_statements skata, ir pilns teksts ar izpildes parametru vērtībām, nevis normalizēts teksts, ir iespējams reģistrēt ne tikai pieprasījumu laiku un ilgumu, bet arī saglabāt izpildes plānus pašreizējā stāvoklī. laiks.
2. papildu iespēja
Nepārtraukts darbības uzlabošanas process
Atsevišķu vaicājumu uzraudzība kopumā nav paredzēta, lai atrisinātu problēmas, kas saistītas ar nepārtrauktu datu bāzes veiktspējas uzlabošanu kopumā, jo tā uzrauga un atrisina veiktspējas problēmas tikai atsevišķiem vaicājumiem. Tomēr jūs varat paplašināt metodi un konfigurēt uzraudzības vaicājumus visām datu bāzēm.
Lai to izdarītu, jums jāievada papildu veiktspējas metrika:
- Pēdējās dienās
- Bāzes periodam
Skripts atlasa vaicājumus no mērķa datubāzes skata pg_stat_statements un salīdzina max_time vērtību ar vidējo max_time vērtību, pirmajā gadījumā pēdējām dienām vai atlasītajam laika periodam (bāzes līnija), otrajā gadījumā.
Tādējādi jebkura pieprasījuma veiktspējas pasliktināšanās gadījumā brīdinājums tiks ģenerēts automātiski, bez manuālas pārskatu analīzes.
Kāds ar to sakars sintēzei?
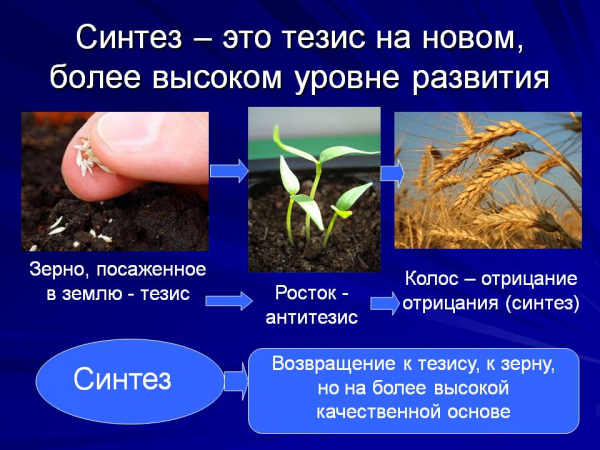
Aprakstītajā pieejā, kā liecina sintēzes metode, uzlabojot atsevišķas sistēmas daļas, mēs uzlabojam sistēmu kopumā.
- Vaicājums, ko izpilda datu bāze – abstrakts
- Modificēts pieprasījums - antitēze
- Sistēmas stāvokļa maiņa - sintēze
Sistēmas izstrāde
- Apkopotās statistikas paplašinājumi, pievienojot vēsturi sistēmas skatam pg_stat_activity
- Apkopotās statistikas paplašināšana, pievienojot vēsturi atsevišķu tabulu statistikai, kas piedalās vaicājumos
- Integrācija ar AWS mākoņu uzraudzības sistēmu
- Un tomēr jūs varat kaut ko izdomāt...
Avots: www.habr.com
