

Sveiki, Habr!
Pagājušajā gada rudenī Kaggle norisinājās zīmēto attēlu klasifikācijas konkurss Quick Draw Doodle Recognition, kurā piedalījās arī R komandas dalībnieki, , un . Neplānojam detalizēti aprakstīt sacensību, tas jau tika izdarīts .
Šoreiz medaļu laimēšana nesanāca, bet tika iegūta liela vērtīga pieredze, tāpēc vēlamies dalīties ar dažu no interesantākajām un noderīgākajām tēmām Kaggle un ikdienas darbā. Apskatītās tēmas ietver: grūto dzīvi bez OpenCV, JSON parsēšanu (šajos piemēros tiek apsvērta C++ koda integrācija R skriptos vai paketēs, izmantojot Rcpp), skriptu parametrizāciju un gala risinājuma dockerizāciju. Visi kodu piemēri ir pieejami izpildei .
Saturs:
1. Efektīva datu ielāde no CSV uz MonetDB datu bāzi
Dati šajā sacensībā tiek nodrošināti nevis kā gatavi attēli, bet kā 340 CSV faili (pa vienam failam uz katru klasi), kas satur JSON ar punktu koordinātēm. Savienojot šos punktus ar līnijām, mēs iegūstam gala attēlu izmērā 256x256 pikseļi. Arī katram ierakstam ir norādīta birka, vai attēls tika pareizi atpazīts ar tobrīd izmantoto klasifikatoru, divu burtu kods valsts, kurā dzīvo zīmētāja autors, unikāls identifikators, laikspiedols un klases nosaukums, kas atbilst faila nosaukumam. Vienkāršotā versija sver 7.4 GB arhivētā formātā un apmēram 20 GB pēc atpakotšanas, pilni dati pēc atpakotšanas aizņem 240 GB. Organizatori garantēja, ka abas versijas reproducē tos pašus zīmējumus, tātad pilna versija ir lieka. Jebkurā gadījumā ir atzīts, ka 50 miljons zīmējumu glabāšana grafiskajos failos vai masīvos nav rentabla, un mēs izlemām apvienot visus CSV failus no arhīva train_simplified.zip datu bāzē ar sekojošu attēlu ģenerēšanu vajadzīgajos izmēros „uz vietas” katrai partijai.
Kā DBMS tika izvēlēta labi sevi pierādījusi MonetDB, proti tam ir realizācija R kā pakotne . Pakotne ietver iebūvēto datu bāzes servera versiju un ļauj palaist serveri tieši no R sesijas un strādāt ar to. Datu bāzes izveidošana un pieslēgšanās notiek ar vienu komandu:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Mums būs nepieciešams izveidot divas tabulas: vienu visiem datiem, otru - pakalpojuma informācijai par ielādētajiem failiem (tas noderēs, ja kaut kas noies greizi un procesa turpināšana būs nepieciešama pēc vairāku failu ielādes):
Tabulu izveide
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Ātrākais veids, kā ielādēt datus datu bāzē, izrādījās CSV failu tieša kopēšana, izmantojot SQL komandu COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',', 'n', '"' NULL AS '' BEST EFFORT, kur tablename — tabulas nosaukums un ceļš — ceļš uz failu. Strādājot ar arhīvu, tika atklāts, ka iebūvētā realizācija unzip R nepareizi strādā ar vairākiem arhīva failiem, tāpēc mēs izmantojām sistēmas unzip (izmantojot parametru getOption("unzip")).
Funkcija datu ierakstīšanai bāzē
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Ja ir nepieciešams pārvērst tabulu pirms ierakstīšanas datu bāzē, pietiek nodot argumentā preprocess funkciju, kas pārvērš datus.
Kods sekvenču datu ielādei bāzē:
Datu ierakstīšana bāzē
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Datu ielādes laiks var atšķirties atkarībā no izmantotā krātuves ātruma raksturlielumiem. Mūsu gadījumā lasīšana un rakstīšana no viena SSD vai no zibatmiņas (sākotnējais fails) uz SSD (datu bāzi) aizņem mazāk par 10 minūtēm.
Vēl dažas sekundes ir nepieciešamas, lai izveidotu kolonnu ar veselu skaitļu klases marķi un indeksa kolonnu (ORDERED INDEX) ar rindu numuriem, pēc kuriem tiks veikta novērojumu izvēle, veidojot partijas:
Papildu kolonnu un indeksa izveide
message("Generate labels")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Lai izpildītu uzdevumu izveidot partiju "uz vietas", mums bija jāsasniedz maksimāla ātruma nejaušo rindu izgūšanai no tabulas. doodles. Tādēļ mēs izmantojām 3 trikus. Pirmais bija samazināt datu tipa izmēru, kurā tiek glabāts novērojumu ID. Sākotnējā datu kopā ID glabāšanai nepieciešams tips bigint, bet novērojumu skaits ļauj ietilpināt to identifikatorus, kas ir vienādi ar secības numuru, tipā int. Šajā gadījumā meklēšana notiek ievērojami ātrāk. Otrais triks bija izmantot ORDERED INDEX — šo risinājumu mēs atradām empīriski, izmēģinot visus pieejamos . Trešais sastāvēja no parametrizētiem pieprasījumiem. Metodes būtība ir vienreizēji izpildīt komandu PREPARE , sekojoši izmantojot sagatavoto izteiksmi, veidojot virkni viendabīgu pieprasījumu, taču praksē ieguvums salīdzinājumā ar vienkāršu SELECT izrādījās statistiski nenozīmīgs.
Datu ievadīšanas process patērē ne vairāk kā 450 MB RAM. Tātad, aprakstītais pieejas ļauj apstrādāt datu kopas, kuru svars ir desmitiem gigabaitu, praktiski uz jebkura budžeta dzelžiem, ieskaitot dažus viensaldus, kas ir diezgan forši.
Paliek veikt ātruma mērījumus (nejaušo) datu izgūšanai un novērtēt mērogojamību, izvēloties partijas dažāda lieluma:
Datu bāzes tests
library(ggplot2)

set.seed(0)
# Pieslēgšanās pie datu bāzes
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funkcija, lai sagatavotu vaicājumu servera pusē
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funkcija datu iegūšanai
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Mēģinājumu veikšana
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Benchmarks parametri
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("vidējais laiks, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 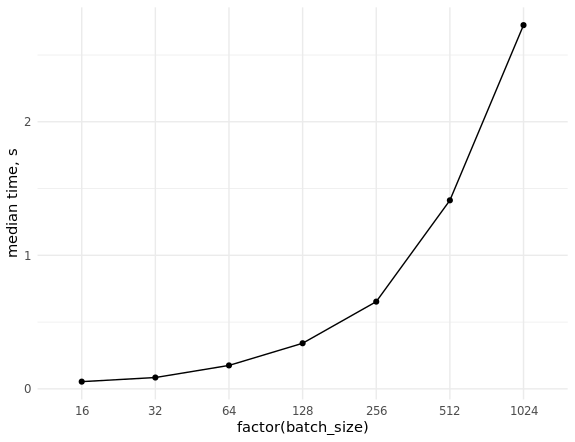
2. Batču sagatavošana
Visu batču sagatavošanas process sastāv no šādiem posmiem:
- Vairāku JSON parsēšana, kas satur virknes vektorus ar punktu koordinātēm.
- Krāsainu līniju uzzīmēšana pēc punktu koordinātēm attēlā ar nepieciešamo izmēru (piemēram, 256×256 vai 128×128).
- Iegūto attēlu pārvēršana tensorā.
Sacensību ietvaros starp Python kernel-iem uzdevums galvenokārt tika risināts ar līdzekļiem OpenCV. Viens no acīmredzamākajiem līdzīgiem risinājumiem R būtu šāds:
JSON pārvēršanas īstenošana tensorā R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # JSON parsēšana
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Dzēšam pagaidu failu funkcijas beigās
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Tukša diagramma
  plot.new()
  # Diagrammas loga izmērs
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Līniju krāsas
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Attēla pārvēršana 3D masīvā
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Apvienojam 3D attēlu masīvus 4D tenzorā
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Zīmēšana tiek veikta, izmantojot standarta R rīkus, saglabājot pagaidu PNG failā, kas tiek glabāts RAM (Linux pagaidu direktorijas R atrodas katalogā /tmp, kas piesprausts RAM). Pēc tam šis fails tiek nolasīts kā trīsdimensionāls masīvs ar skaitļiem diapazonā no 0 līdz 1. Tas ir svarīgi, jo vispārpieņemtais BMP tiktu nolasīts kā raw-masīvs ar hex krāsu kodiem.
Pārbaudīsim rezultātu:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 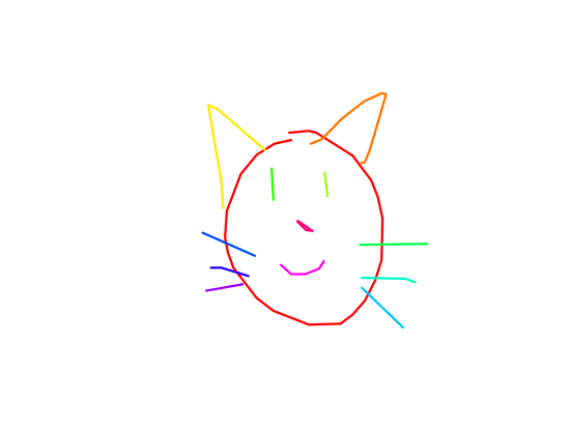
Pašnīkt vēlas veidot partiju šādi:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Šī īstenošana mums šķita neefektīva, jo liela partiju veidošana prasa nenormāli daudz laika, un mēs nolēmām izmantot kolēģu pieredzi, izmantojot jaudīgu bibliotēku OpenCV. Tajā laikā gatava pakete R nebija (nav arī tagad), tāpēc tika uzrakstīta minimāla nepieciešamā funkcionalitāte C++ ar integrāciju R kodā, izmantojot Rcpp.
Lai atrisinātu uzdevumu, tika izmantotas šādas paketes un bibliotēkas:
OpenCV attēlu apstrādei un līniju zīmēšanai. Tika izmantotas iepriekš instalētas sistēmas bibliotēkas un galvenes, kā arī dinamisā saistīšana.
xtensor darbam ar daudzdimensiju masīviem un tenzoriem. Mēs izmantojām galvenes failus, kas iekļauti attiecīgajā R paketē. Bibliotēka ļauj strādāt ar daudzdimensiju masīviem, gan row major, gan column major secībā.
ndjson JSON parsēšanai. Šī bibliotēka tiek izmantota xtensor automātiski, ja tā ir pieejama projektā.
RcppThread daudzvīdu apstrādei JSON vektoriem. Mēs izmantojām galvenes failus, ko nodrošina šī pakete. Salīdzinoši ar populārāko RcppParallel paketi, starp citu, ir iebūvēts cikla pārtraukšanas mehānisms (interrupt).
Jāatzīmē, ka xtensor izrādījās kā īsts atklājums: ne tikai tam ir plašs funkcionalitātes klāsts un augsta veiktspēja, bet arī tā izstrādātāji izrādījās diezgan atsaucīgi un operatīvi un detalizēti atbildēja uz radušām jautājumiem. Ar viņu palīdzību izdevās realizēt OpenCV matricas pārvēršanu xtensor tenzoros, kā arī trīs dimensiju attēlu tenzoru apvienošanu četru dimensiju tenzorā ar pareizu dimensiju (proti, partiju).
Materiāli Rcpp, xtensor un RcppThread apguvei
Lai kompilētu failus, kas izmanto sistēmas failus un dinamiski saistītās bibliotēkas, kas instalētas sistēmā, mēs izmantojām spraudņa mehānisma, kas īstenots paketē, Rcpp. Automātiskai ceļu un karogu atrašanai izmantojām populāro linux rīku pkg-config.
Rcpp spraudņa īstenošana, lai izmantotu OpenCV bibliotēku
Rcpp::registerPlugin("opencv", function() {
  # Iespējamie paketes nosaukumi
  pkg_config_name <- c("opencv", "opencv4")
  # pkg-config rīka binārais fails
  pkg_config_bin <- Sys.which("pkg-config")
  # Pārbaude, vai rīks ir pieejams sistēmā
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Pārbaude, vai OpenCV konfigurācijas fails ir pieejams pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Kompilācijas procesā spraudņa darbības rezultātā tiks aizvietoti šādi vērtības:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
JSON parsēšanas un partijas veidošanas kods modelim ir sniegts zem spoileris. Iepriekš pievienojam lokālo projekta direktoriju galvene failu meklēšanai (nepiecieša ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))JSON pārveidošanas implementācija uz C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Šis kods jāievieto failā src/cv_xt.cpp un jākompilē ar komandu Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); turklāt darbosies arī nlohmann/json.hpp no . Kods sadalīts vairākās funkcijās:
to_xt— pielāgojuma funkcija, lai attēla matricas (cv::Mat) pārveidotu tensorāxt::xtensor;parse_json— funkcija analizē JSON virkni, iegūst koordinātas un iepako tās vektorā;ocv_draw_lines— no iegūtā punktu vektora zīmē daudzkrāsainas līnijas;process— apvieno iepriekš aprakstītās funkcijas un pievieno iespēju iegūtā attēla mērogošanai;cpp_process_json_str— apvalks pār funkcijuprocess, kas eksportē rezultātu R objektā (daudzdimensiju masīvā);cpp_process_json_vector— apvalks pār funkcijucpp_process_json_str, kas ļauj apstrādāt virkņu vektoru daudzprotokolā.
Daudzkrāsaino līniju zīmēšanai tika izmantots HSV krāsu modelis ar sekojošu pārvēršanu RGB. Pārbaudīsim rezultātu:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 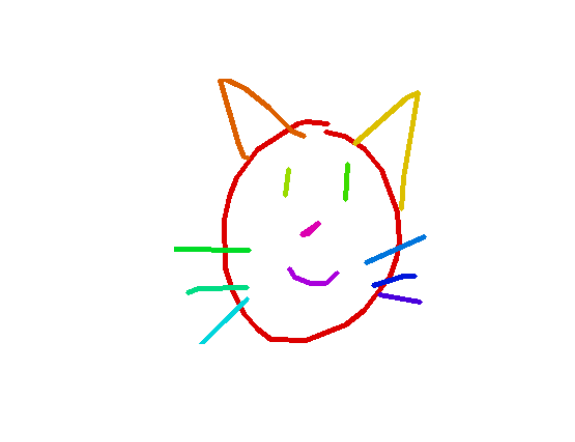
Salīdzinošā ātruma izpilde uz R un C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmark parameters
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Measurement execution
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>         <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 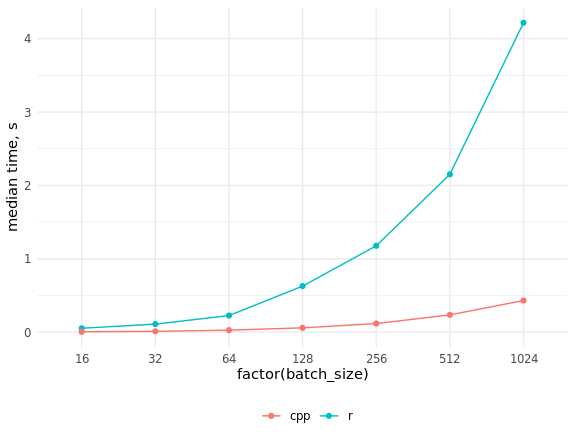
Kā redzam, ātruma pieaugums ir patiešām ievērojams, un nav iespējams panākt C++ kodu, izmantojot R koda paralelizāciju.
3. Iteratori partiju izsaukšanai no datubāzēm
R ir pelnījusi cieņu kā valoda datu apstrādei, kas ietilpst RAM, bet Python ir raksturīgāka iteratīvā datu apstrāde, kas ļauj viegli un dabiski īstenot out-of-core aprēķinus (aprēķinus, kas izmanto ārējo atmiņu). Klasisks un mums aktuāls piemērs šādiem aprēķiniem ir dziļās neironu tīklu apmācība, izmantojot gradienta nolaišanās metodi, apejot gradienta tuvinājumu katrā solī uz nelielām novērojumu porcijām jeb mini-batch.
Dziļā mācīšanās ietvari, kas uzrakstīti Python, satur īpašas klases, kas realizē datu iterātus: tabulas, attēlus mapēs, bināros formātos utt. Var izmantot gatavas variants vai arī rakstīt savus specifiskām uzdevumiem. R mēs varam izmantot visas Python bibliotēkas iespējas keras ar tās dažādajiem backend, izmantojot vienādas nosaukuma pakotni, kas darbojas virs pakotnes reticulate. Pēdējais pelnījis atsevišķu lielu rakstu; tas ne tikai ļauj izpildīt Python kodu no R, bet arī nodrošina objektu pārsūtīšanu starp R un Python sesijām, automātiski veicot visus nepieciešamos tipa pārveidojumus.
Mums vairs nav jāglabā visi dati RAM, pateicoties MonetDBLite izmantošanai, visa "neironu tīkla" darbība tiks veikta ar oriģinālo Python kodu, mums atliek tikai uzrakstīt datu iterātoru, jo gatavu variantu šādai situācijai nav ne R, ne Python. Prasības tam faktiski ir divas: tam jāatgriež batch bezgalīgā ciklā un jāsaglabā savs stāvoklis starp iterācijām (pēdējā R tiek vienkārši realizēta, izmantojot closures). Agrāk bija nepieciešams iekšējā iterātorā skaidri pārvērst R masīvus numpy masīvos, bet aktuālā pakotnes versija keras to dara pati.
Mēs iegūstam šādu iterātoru mācību un validācijas datiem:
Mācību un validācijas datu iterātors
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funkcija pieņem mainīgo ar savienojumu ar DB, izmantoto rindu numurus, klašu skaitu, batch izmēru, mērogu (scale = 1 atbilst attēlu zīmēšanai ar izmēru 256x256 pikseļi, scale = 0.5 - 128x128 pikseļi), krāsu indikators (color = FALSE nosaka zīmēšanu pelēkajos toņos, izmantojot krāsa = TRUE katrs vilciena posms tiek uzzīmēts ar jaunu krāsu) un priekšapstrādes indikators tīklam, kas iepriekš apmācīts ar imagenet. Pēdējais nepieciešams, lai pārskalotu pikseļu vērtības no intervāla [0, 1] uz intervālu [-1, 1], kas tika izmantots apmācībā. keras modeļiem.
Ārējā funkcija satur argumentu tipu pārbaudi, tabulu data.table ar nejauši sajauktiem rindu numuriem no samples_index un partiju numuriem, skaitītāju un maksimālo partiju skaitu, kā arī SQL izteiksmi datu izgūšanai no DB. Papildus mēs definējām ātru analogu funkcijai keras::to_categorical(). Mēs izmantojām gandrīz visus datus apmācībai, atstājot pusprocentu validācijai, tāpēc epohas lielums tika ierobežots ar parametru steps_per_epoch aicinājuma laikā, tādēļ visi keras::fit_generator(), un nosacījums if (i > max_i) tika aktivizēts tikai validācijas iteratoram.
Iekšējā funkcijā notiek rindu indeksu atlasīšana nākamajai partijai, ierakstu izgūšana no DB ar partiju skaitītāja palielināšanu, JSON parsēšana (funkcija cpp_process_json_vector(), uzrakstīta C++) un attēlu atbilstošu masīvu izveide. Tad tiek izveidoti one-hot vektori ar klases atzīmēm, masīvi ar pikseļu vērtībām un atzīmes tiek apvienotas sarakstā, kas ir atgriezamā vērtība. Lai paātrinātu darbu, tika izmantota indeksu izveide tabulās data.table un atsauces modificēšana — bez šīm "fīškām" pakete data.table uz vietas diezgan grūti iedomāties efektīvu darbu ar ievērojamiem datu apjomiem R.
Veiktspējas mērījumu rezultāti uz klēpjdatora ar Core i5 izskatās šādi:
Iteratora salīdzinošais tests
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indeksi mācību paraugam
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indeksi pārbaudes paraugam
val_ind <- ind[-train_ind]
rm(ind)
# Mērogošanas koeficients
scale <- 0.5

# Mērīšanas veikšana
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmarks parametri
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("mediana laiks, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 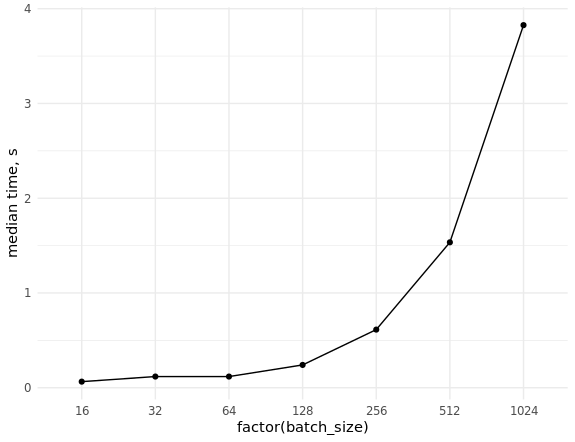
Ja ir pietiekami daudz RAM, datubāzes darbu var ievērojami paātrināt, pārvietojot to uz šo pašu RAM (mūsu uzdevumam pietiek ar 32 GB). Linuxā pēc noklusējuma tiek montēts nodalījums /dev/shm, kas aizņem līdz puscieto disku apjoma. Var norādīt arī vairāk, rediģējot /etc/fstab, lai iegūtu ierakstu formātā tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Obligāti restartējiet un pārbaudiet rezultātu, izpildot komandu df -h.
Iterators testēšanas datiem izskatās daudz vienkāršāk, jo testēšanas datu kopums pilnībā ietilpst RAM:
Iterators testēšanas datiem
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Modeļa arhitektūras izvēle
Pirmā no izmantotajām arhitektūrām bija , kuras īpatnības ir izskatītas ziņojumā. Tā klātesošie standarta komplektā keras un, attiecīgi, pieejams vienā un tajā pašā paketē R. Taču, mēģinot to izmantot ar vienkanālu attēliem, izrādījās dīvaini: ieejas tenzora izmēram vienmēr jābūt formātā (batch, height, width, 3), tas nozīmē, ka kanālu skaitu nevar mainīt. Python šādu ierobežojumu neuzliek, tāpēc mēs steigā uzrakstījām savu šīs arhitektūras realizāciju, sekojot oriģinālajam rakstam (bez izslēgšanas, kas ir keras versijā):
Mobilenet v1 arhitektūra
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Šī pieeja acīmredzami ir nepilnīga. Gribas pārbaudīt daudz modeļu, bet negribas katru arhitektūru pārrakstīt manuāli. Mēs arī bijām izslēgti no iespējas izmantot modeļu svarus, kas jau iepriekš apmācīti uz imagenet. Parasti palīdz dokumentācijas izpēte. Funkcija get_config() ļauj iegūt modeļa aprakstu rediģējamā formātā (base_model_conf$layers — parasts saraksts), bet funkcija from_config() veic atpakaļ pārveidošanu modelējamā objektā:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Tagad nav grūti uzrakstīt universālu funkciju jebkuras no piegādātajām keras modeļiem ar apmācītiem imagenet svaru vai bez tiem:
Funkcija gatavo arhitektūru ielādei
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Argumentu pārbaude
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Iegūstam objektu no keras paketes
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Pārbaudām objekta esamību paketē
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " netika atrasts.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Ja attēls nav krāsains, mainām ieejas dimensiju
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Izmantojot vienkanāla attēlus, iepriekš apmācītie svari netiek izmantoti. To varētu labot: izmantojot funkciju get_weights() saņemt modeļa svarus saraksta veidā no R masīviem, mainīt pirmā elementa dimensiju (ņemot kādu vienu krāsu kanālu vai vidējot visus trīs), un pēc tam ielādēt svarus atpakaļ modelī ar funkciju set_weights(). Mēs šo funkcionalitāti tā arī neieviesām, jo šajā posmā bija skaidrs, ka produktīvāk ir strādāt ar krāsainiem attēliem.
Lielāko daļu eksperimentu mēs veicām, izmantojot mobilenet versijas 1 un 2, kā arī resnet34. Šajā sacensībā labi parādījās modernākas arhitektūras, piemēram, SE-ResNeXt. Diemžēl mūsu rīcībā nebija gatavu realizāciju, bet mēs pašreizējo izstrādāsim (bet noteikti izstrādāsim).
5. Skriptu parametru iestatīšana
Lai atvieglotu darbu, viss kods apmācības uzsākšanai tika sakārtots vienā skriptā, ko parametrizē ar šeit:
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Rādīt šo ziņojumu.
  -l --list-models            Saraksts ar pieejamajiem modeļiem.
  -m --model=          Neironu tīkla modeļa nosaukums [noklusējums: mobilenet_v2].
  -b --batch-size=      Partijas izmērs [noklusējums: 32].
  -s --scale-factor=   Mērogošanas faktors [noklusējums: 0.5].
  -c --color                  Izmantot krāsainas līnijas [noklusējums: FALSE].
  -d --db-dir=          Ceļš uz datu bāzes katalogu [noklusējums: Sys.getenv("db_dir")].
  -r --validate-ratio= Apstiprināšanas paraugu attiecība [noklusējums: 0.995].
  -n --n-gpu=         GPU skaits [noklusējums: 1].
'
args <- docopt::docopt(doc)
Pakete docopt ir realizācija R valodā. Tā palīdz palaist skriptus ar vienkāršām komandām, piemēram, Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db vai ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, ja fails train_nn.R ir izpildāms (šī komanda uzsāks modeļa apmācību resnet50 trīs kanālu attēlos ar izmēriem 128x128 pikseļu, datu bāze jānovieto mapē /home/andrey/doodle_db). Sarakstā var pievienot mācīšanās ātrumu, optimizatora veidu un jebkurus citus konfigurējamos parametrus. Sagatavošanās publikācijai noskaidrojās, ka arhitektūra mobilenet_v2 no aktuālās versijas keras R izmantošana ir saistīta ar R pakotnē neiekļautām izmaiņām — gaidām, kamēr tās novērsīs.
Šī pieeja ļāva būtiski paātrināt eksperimentus ar dažādiem modeļiem salīdzinājumā ar tradicionālo skriptu palaišanu RStudio (kā iespējamu alternatīvu var minēt pakotni ). Bet galvenā priekšrocība ir iespēja viegli pārvaldīt skriptu izpildi Docker vai vienkārši uz servera, neinstalējot RStudio.
6. Skriptu Dockerizācija
Mēs izmantojām Docker, lai nodrošinātu vides pārnesamību modeļu apmācībai starp komandas locekļiem un ātru izvietošanu mākoņos. Sākt iepazīšanos ar šo relativi neierasto instrumentu R programmētājam var ar publikāciju sēriju vai ar .
Docker ļauj gan izveidot savus attēlus "no nulles", gan izmantot citus attēlus kā pamatu saviem. Analizējot pieejamos variantus, mēs secinājām, ka NVIDIA, CUDA+cuDNN un Python bibliotēku instalēšana ir diezgan apjomīga daļa no attēla, tāpēc nolēmām izmantot oficiālo attēlu tensorflow/tensorflow:1.12.0-gpu, pievienojot nepieciešamos R paketus.
Galīgais Docker fails izskatījās šādi:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Lai atvieglotu lietoto pakotņu pārvaldību, tās tika izdalītas mainīgajos; galvenā daļa uzrakstītās skriptu tiek kopēta konteineru iekšienē to izveides laikā. Mēs arī mainījām komandrindas vidi uz /bin/bash lai atvieglotu satura izmantošanu /etc/os-release. Tas novērsa nepieciešamību norādīt operētājsistēmas versiju kodā.
Papildu tika uzrakstīts neliels bash skripts, kas ļauj palaist konteineru ar dažādām komandām. Piemēram, tas varētu būt skripti neironu tīklu apmācībai, kas iepriekš tika ievietoti konteinerā, vai komandrindas vide, lai debugotu un uzraudzītu konteineru darbu:
Skripts konteineram palaišanai
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Ja, ja palaidzot šo bash skriptu bez parametriem, tiks izsaukts skripts ar noklusējuma vērtībām iekš konteitera; ja pirmais pozicionālais arguments ir "bash", tad konteineris tiks palaists interaktīvajā režīmā ar komandu apstrādātāju. Visos citos gadījumos notiek pozicionālo argumentu vērtību aizvietošana: train_nn.R CMD="Rscript /app/train_nn.R $@" Ir vērts pievērst uzmanību, ka direktorijas ar izejas datiem un datu bāzi, kā arī direktorija, kurā tiek glabātas apmācītās modeļi, tiek montētas iekš konteitera no viesmašīnas, kas ļauj piekļūt skriptu darba rezultātiem bez liekām manipulācijām..
7. Daudzu GPU izmantošana Google Cloud
Viena no konkursa īpašībām bija diezgan trokšņainie dati (skat. virsrakstu attēlu, ko aizguvusi no @Leigh.plt no ODS Slack). Ar lielu partiju palīdzību mēs izdevīgi risinājām šo problēmu, un pēc eksperimentiem uz datora ar 1 GPU, nolēmām apgūt modeļu apmācību uz vairākiem GPU mākonī. Izmantojām Google Cloud (
labs ceļvedis par pamatiemdev/shm Vislielāko interesi rada koda fragments, kas atbild par vairāku GPU izmantošanu. Vispirms modelis tiek izveidots CPU uz CPU, izmantojot konteksta menedžeri, tāpat kā Pythonā:.
with(tensorflow::tf$device("/cpu:0"), { model_cpu <- get_model( name = model_name, input_shape = input_shape, weights = weights, metrics =(top_3_categorical_accuracy, compile = FALSE ) })
Tad nekompilētais (tas ir svarīgi) modelis tiek kopēts uz norādīto pieejamo GPU skaitu, un tikai pēc tam tiek kompilēts:model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu) keras::compile( object = model, optimizer = keras::optimizer_adam(lr = 0.0004), loss = "categorical_crossentropy", metrics = c(top_3_categorical_accuracy) )
Klasisko pieeju ar visu slāņu sasaldēšanu, izņemot pēdējo, pēdējā slāņa apmācību, atsaldēšanu un modeļa apmācīšanu kopumā vairākiem GPU, realizēt neizdevās.Apmācības procesu uzraudzījām bez
tensorboard tensorboard, ierobežojoties ar žurnālu ierakstiem un modeļu saglabāšanu ar informatīvām nosaukumiem pēc katras epochas:
Atgriezeniskās saites
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Aizvērums
Vairāku problēmu, ar kurām saskārāmies, risināšana vēl nav izdevusies:
- par keras nav gatavas funkcijas automātiskai optimālās mācību ātruma meklēšanai (analogs
lr_finderbibliotēkā fast.ai); nedaudz piepūloties, var pārvietot uz R trešo pušu realizācijas, piemēram, ; - kā iepriekš minētā punkta sekas, neizdevās atrast pareizo mācību ātrumu, izmantojot vairākus GPU;
- trūkst mūsdienu neironu tīklu arhitektūru, it īpaši priekšapmācītas uz imagenet;
- nav one cycle policy un diskriminatīvie mācību ātrumi (cosine annealing pēc mūsu lūguma bija , paldies ).
Ko noderīgu izdevās gūt no šī konkursa:
- Uz salīdzinoši vājām iekārtām var bez grūtībām strādāt ar pietiekami ievērojamām (daudz lielākām par RAM izmēru) datu apjomiem. Pakete data.table ietaupa atmiņu, veicot in-place modifikāciju tabulām, kas ļauj izvairīties no to kopēšanas, un, pareizi izmantojot tās iespējas, gandrīz vienmēr demonstrē visaugstāko ātrumu starp visiem zināmajiem rīkiem skriptu valodām. Datu saglabāšana datu bāzē ļauj daudzās situācijās vispār nedomāt par nepieciešamību iekļaut visu datu kopu RAM.
- Lēnas funkcijas R var aizstāt ar ātrām C++ izmantojot paketi Rcpp. Ja papildus izmantosim RcppThread vai RcppParallel, iegūstam multiplatformiskas daudzplūsmu realizācijas, tāpēc R līmeņa kods nav jāparalē.
- Paketē Rcpp var lietot bez nopietnām zināšanām par C++, nepieciešamais minimums ir izklāstīts . Virsrakstu faili vairākiem kruta C bibliotēkām, piemēram, xtensor ir pieejami CRAN, tas nozīmē, ka tiek veidota infrastruktūra projektu īstenošanai, kas integrē R gatavo augstas veiktspējas C++ kodu. Papildu ērtība — sintakse krāsošana un statiskais koda analizators C++ RStudio.
- docopt ļauj izpildīt patstāvīgus skriptus ar parametriem. Tas ir ērti izmantot attālinātajos serveros, tostarp Docker. RStudio veikt daudzu stundu eksperimentus ar neironu tīklu apmācību nav ērti, un pati IDE uzstādīšana serverī ne vienmēr ir pamatota.
- Docker nodrošina koda pārnesamību un rezultātu reproducējamību starp izstrādātājiem ar dažādām OS un bibliotēru versijām, kā arī vienkāršību palaišanai uz serveriem. Visa mācīšanās procesa palaišana iespējama ar vienu komandu.
- Google Cloud ir budžeta veids, kā eksperimentēt ar dārgu aparatūru, bet ir jāizvēlas konfigurācijas pārdomāti.
- Ļoti noderīgi ir izmērīt atsevišķu koda fragmentu veiktspēju, īpaši apvienojot R un C++, bet ar pakotni bench — vēl jo vairāk, tas ir ļoti viegli.
Kopumā šī pieredze bija ļoti noderīga, un mēs turpinām strādāt pie dažām no izteiktajām problēmām.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish