

Mijn hoofdtaak bestaat grotendeels uit het implementeren van software systemen, wat betekent dat ik veel tijd besteed aan het proberen te antwoorden op vragen als deze:
- De software werkt bij de ontwikkelaar, maar bij mij niet. Waarom?
- Gisteren werkte de software bij mij, maar vandaag niet. Waarom?
Dit is een soort debugging die iets verschilt van de gebruikelijke software debugging. Gewone debugging gaat over de logica van de code, terwijl implementatie debugging gaat over de interactie tussen de code en de omgeving. Zelfs als de kern van het probleem een logische fout is, betekent het feit dat het op de ene machine werkt en op de andere niet, dat het op de een of andere manier in de omgeving ligt.
Daarom heb ik in plaats van de gebruikelijke debuggingtools zoals gdb een andere set tools voor implementatie debugging. Mijn favoriete hulpmiddel voor het probleem 'Waarom werkt deze software bij mij niet?' heet strace.
Wat is strace?
— dat is een hulpmiddel voor 'systeemaanroep tracing'. Oorspronkelijk ontwikkeld voor Linux, maar dezelfde functies voor debugging kunnen ook met tools voor andere systemen worden uitgevoerd ( of ).
De belangrijkste toepassing is heel eenvoudig. Je hoeft alleen strace met een willekeurige opdracht te starten en het zal een dump sturen van alle systeemaanroepen (waarschijnlijk moet je eerst strace zelf installeren) strace):
$ strace echo Hello
...Snip lots of stuff...
write(1, "Hellon", 6)                  = 6
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ exited with 0 +++
Wat zijn dat voor systeemaanroepen? Het is iets als een API voor de kernel van het besturingssysteem. Lang geleden hadden softwaretoepassingen directe toegang tot de 'hardware' waarop ze liepen. Als ze bijvoorbeeld iets op het scherm wilden weergeven, werkten ze met poorten of registers in het geheugen voor videoinstallaties. Met de opkomst van multitasking computersystemen ontstond er chaos, omdat verschillende toepassingen vochten om toegang tot de 'hardware'. Fouten in één toepassing konden de werking van andere toepassingen verstoren, of zelfs het hele systeem. Toen kwamen er privilege-niveaus (of 'ringbescherming') in de CPU. Het meest bevoorrechte niveau werd de kernel: deze had volledige toegang tot de 'hardware' en genereerde minder bevoorrechte toepassingen die toestemming moesten vragen aan de kernel om met de 'hardware' te communiceren — via systeemaanroepen.
Op binair niveau verschilt de systeemaanroep iets van een gewone functieaanroep, maar de meeste programma's gebruiken een wrapper in de standaardbibliotheek. Dat wil zeggen, de standaard POSIX C-bibliotheek bevat de functieaanroep write(), die alle architectuurafhankelijke code voor de systeemaanroep bevat write.
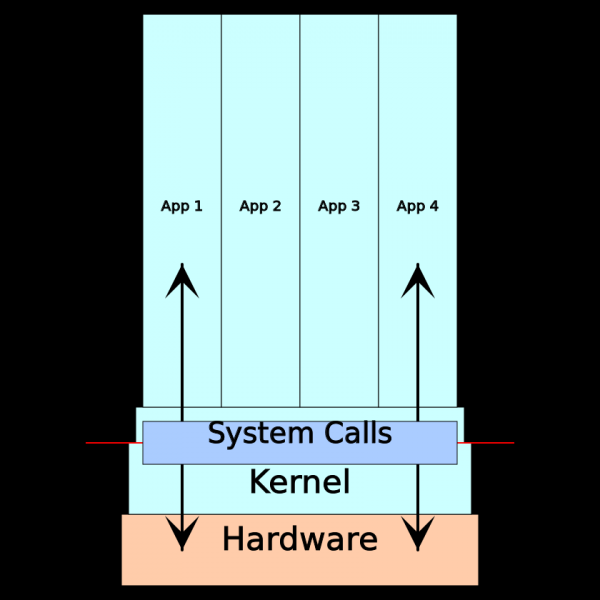
Kort gezegd, elke interactie van een applicatie met zijn omgeving (computersystemen) verloopt via systeemaanroepen. Dus wanneer software op de ene machine werkt, maar niet op de andere, is het goed om de resultaten van systeemaanroep tracing te bekijken. En als we concreter zijn, hier is een lijst met typische punten die geanalyseerd kunnen worden met behulp van systeemaanroep tracing:
- Console in- en uitvoer
- Netwerk in- en uitvoer
- Toegang tot het bestandssysteem en bestandsin- en uitvoer
- Beheer van de levensduur van proces- of thread
- Laag-niveau geheugenbeheer
- Toegang tot speciale apparaatsdrivers
Wanneer gebruik je strace?
In theorie, strace wordt het gebruikt met elke programma in de gebruikersruimte, aangezien elk programma in de gebruikersruimte systeemaanroepen moet doen. Het werkt effectiever met compileerbare, laag-niveau programma's, maar het werkt ook met hoog-niveau talen zoals Python, als je door de extra ruis van de runtime-omgeving en de interpreter heen kunt komen.
In volle glorie strace blinkt het uit tijdens het debuggen van software die goed werkt op de ene machine, maar op de andere ineens niet meer werkt, met onduidelijke foutmeldingen over bestanden, rechten of mislukte pogingen om bepaalde commando's uit te voeren of iets dergelijks… Jammer genoeg is het niet zo goed te combineren met hoog-niveau problemen zoals certificaatverificatiefouten. Hier is meestal een combinatie vereist strace, soms en tools van een hoger niveau (zoals de opdrachtregeltool openssl voor certificaatdebugging).
Neem bijvoorbeeld het werken op een geïsoleerde server, maar systeemaanroep tracing kan vaak ook op meer complexe implementatieplatforms worden uitgevoerd. Je hoeft alleen maar de juiste tools te vinden.
Voorbeeld van eenvoudige debugging
Stel, je wilt een geweldig serverapplicatie foo uitvoeren, en het resultaat is dit:
$ foo
Error opening configuration file: No such file or directory
Het is duidelijk dat hij niet het configuratiebestand kon vinden dat je hebt geschreven. Dit gebeurt soms omdat pakketbeheerders bij het compileren van de applicatie de verwachte bestandslocaties overschrijven. En als je de installatierichtlijnen voor de ene distributie volgt, vind je de bestanden in een andere distributie op totaal andere plekken dan verwacht. Het probleem zou in een paar seconden opgelost kunnen zijn als de foutmelding aangaf waar je het configuratiebestand zou moeten zoeken, maar dat doet het niet. Dus waar moet je zoeken?
Als je toegang hebt tot de broncode, kun je het lezen en alles uitzoeken. Een goed back-upplan, maar niet de snelste oplossing. Je kunt een stapsgewijze debugger gebruiken zoals gdb en bekijken wat het programma doet, maar het is veel effectiever om een tool te gebruiken die speciaal is ontworpen om interacties met de omgeving weer te geven: strace.
Uitslag strace het kan overbodig lijken, maar het goede nieuws is dat je het grootste deel ervan gerust kunt negeren. Het is vaak nuttig om de -o optie te gebruiken om de traceresultaten in een apart bestand op te slaan:
$ strace -o /tmp/trace foo
Fout bij het openen van configuratiebestand: Geen dergelijk bestand of directory
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 vars */) = 0
brk(NULL)                               = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK)      = -1 ENOENT (Geen dergelijk bestand of directory)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3)                                = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3)                                = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186)           = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (Geen dergelijk bestand of directory)
dup(2)                                  = 3
fcntl(3, F_GETFL)                       = 0x2 (flags O_RDWR)
brk(NULL)                               = 0x56363b3fb000
brk(0x56363b41c000)                     = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Fout bij het openen van configuratiebestand"..., 60) = 60
close(3)                                = 0
exit_group(1)                           = ?
+++ beëindigd met 1 +++
Bijna de hele eerste pagina van de uitvoer strace — dit is meestal een laag-niveau voorbereiding voor de uitvoer. (Veel aanroepen mmap, mprotect, brk voor dingen zoals het ontdekken van laag-niveau geheugen en het koppelen van dynamische bibliotheken.) Over het algemeen, tijdens het debuggen, is de uitvoer strace beter leesbaar van onderaf. Onder aan staat de aanroep write, die een foutmelding geeft. Laten we naar boven kijken en zien de eerste mislukte systeemaanroep — de aanroep openat, die een fout geeft ENOENT ('bestand of directory niet gevonden'), geprobeerd om te openen /etc/foo/config.json. Hier zou het configuratiebestand moeten liggen.
Dit was gewoon een voorbeeld, maar ik zou zeggen dat 90% van de tijd dat ik gebruik maak van strace, er niets veel ingewikkelder is dan dit dat ik hoef te doen. Hieronder is een complete stap-voor-stap gids voor het debuggen:
- Geregeld worden door een onduidelijke system-y foutmelding van het programma
- Herstart het programma met strace
- Zoek in de trace-uitvoer naar een foutmelding
- Ga omhoog totdat je de eerste mislukte systeemaanroep tegenkomt
Het is heel waarschijnlijk dat de systeemaanroep in de 4e stap zal laten zien wat er fout ging.
Hints
Voordat ik een voorbeeld van meer geavanceerde debugging laat zien, geef ik je een paar tips voor effectief gebruik. strace:
man — is jouw vriend
Op veel *nix-systemen kun je de volledige lijst van systeemaanroepen naar de kernel krijgen door man syscalls. Je zult dingen zien zoals brk(2), wat betekent dat je meer informatie kunt krijgen door man 2 brk.
Kleine valkuilen: man 2 fork toont mij de pagina voor de shell fork() in GNU libc, die blijkbaar is geïmplementeerd met behulp van de aanroep clone(). De semantiek van de aanroep fork blijft hetzelfde, of je nu een programma schrijft dat fork()gebruikt, en de tracing uitvoert — ik zal de aanroepen niet vinden, forkin plaats daarvan zullen er clone(). Zulke valkuilen verwarren alleen, als je begint de broncode met de uitvoer te vergelijken. strace.
Gebruik -o om de uitvoer naar een bestand op te slaan
strace kan uitgebreide uitvoer genereren, dus het is vaak nuttig om de trace-resultaten in aparte bestanden op te slaan (zoals in het bovenstaande voorbeeld). Dit helpt ook om de programmatuuruitvoer niet te verwarren met de uitvoer strace in de console.
Gebruik -s om meer gegevens van het argument te bekijken
Je hebt ongetwijfeld opgemerkt dat de tweede helft van de foutmelding niet is weergegeven in het bovenstaande trace-voorbeeld. Dit komt omdat strace standaard slechts de eerste 32 bytes van de argumentstring laat zien. Als je meer wilt zien, voeg dan iets toe als -s 128 aan de aanroep strace.
-u vergemakkelijkt het traceren van bestanden, sockets, en meer.
"Alles is een bestand" betekent dat *nix-systemen al het I/O doen met behulp van bestanden, of het nu om een bestand, netwerk, of inter-process kanalen gaat. Dit is handig voor programmering, maar bemoeilijkt het volgen van wat er werkelijk aan de hand is, wanneer je de algemene resultaten ziet read en write in de uitvoer van de systeemaanroep tracing.
Door de optie -u, dwing je strace om elke bestandsdescriptor in de uitvoer te annoteren met een opmerking waar deze naar verwijst.
Koppel aan een al draaiend proces met -p**
Zoals uit het onderstaande voorbeeld blijkt, moet je soms een programma traceren dat al draait. Als je weet dat het draait als proces 1337 (bijvoorbeeld, uit de uitvoer van ps), dan kun je het zo traceren:
$ strace -p 1337
...systeemaanroep trace-uitvoer...
Misschien heb je root-rechten nodig.
Gebruik -f om de kindprocessen te volgen.
strace Standaard traceert het slechts één proces. Als dit proces echter kindprocessen genereert, kunt u de systeemaanroep voor het genereren van een kindproces zien, maar de systeemaanroepen van het kindproces worden niet weergegeven.
Als u denkt dat de fout in het kindproces ligt, gebruik dan de operator -f, dit zal de trace van het kindproces inschakelen. Het nadeel hiervan is dat de uitvoer nog verwarrender zal zijn. Wanneer strace één proces of één tak traceert, toont het een enkele stroom van oproepgebeurtenissen. Wanneer het meerdere processen tegelijkertijd traceert, kunt u mogelijk het begin van een oproep zien, onderbroken door het bericht <unfinished …>, gevolgd door een reeks oproepen voor andere uitvoeringstakken, en pas dan het einde van de eerste met <… foocall resumed>. Of verdeel alle trace-resultaten over verschillende bestanden, ook met behulp van de operator -ff (details zie voor strace).
Filter de trace met behulp van -e
Zoals u ziet, is het trace-resultaat een echte hoop van alle mogelijke systeemaanroepen. Met de vlag -e kunt u de trace filteren (zie voor strace). Het belangrijkste voordeel is dat het sneller is om de trace met filtering uit te voeren dan een volledige trace te maken en dan grep`en. Om eerlijk te zijn, het interesseert me eigenlijk nauwelijks.
Niet alle fouten zijn slecht
Een eenvoudig en veelvoorkomend voorbeeld is een programma dat een bestand in verschillende locaties zoekt, zoals een shell die zoekt waar de uitvoerbare bestanden zich bevinden:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (Bestand of map bestaat niet)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (Bestand of map bestaat niet)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
Heuristiek zoals 'de laatste mislukte aanvraag voor de foutmelding' is goed voor het vinden van relevante fouten. Hoe dan ook, het is logisch om aan het einde te beginnen.
Handleidingen voor programmeren in C helpen goed om systeemaanroepen te begrijpen.
Standaardaanroepen naar C-bibliotheken zijn geen systeemaanroepen, maar slechts een dunne oppervlaktelaag. Dus als je een beetje begrijpt hoe je in C moet werken, zul je gemakkelijker de resultaten van systeemaanroeptraceringen begrijpen. Bijvoorbeeld, als je problemen hebt met het debuggen van netwerk systeemaanroepen, kijk naar die klassieke .
Een ingewikkelder debugvoorbeeld
Ik heb al gezegd dat een eenvoudig debugvoorbeeld is wat ik meestal tegenkom in mijn werk met strace. Soms is echter een echte research nodig, dus hier is een echt voorbeeld van een complexere debugging.
— een taakverwerkingsplanner, een andere implementatie van de *nix daemon cron. Het is geïnstalleerd op de server, maar wanneer iemand probeert om het schema te bewerken, gebeurt het volgende:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Oké, dus bcron probeerde hij een bestand te schrijven, maar hij slaagde daar niet in en hij geeft geen reden op. Laten we strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
Ongeveer aan het einde is er een foutmelding write, maar deze keer is er iets anders. Ten eerste is er geen relevante fout van een systeemaanroep die meestal daarvoor plaatsvindt. Ten tweede is te zien dat al iemand ergens de foutmelding heeft gelezen. Het lijkt erop dat het echte probleem ergens anders ligt, en bcrontab gewoon de melding weergeeft.
Als je kijkt naar man 2 read, dan zie je dat het eerste argument (3) een bestandsdescriptor is die *nix gebruikt voor alle invoer- en uitvoerbewerkingen. Hoe kun je erachter komen wat de bestandsdescriptor 3 voorstelt? In dit specifieke geval kun je starten strace met de operator -u (zie hierboven), en die vertelt automatisch wat, maar om dergelijke dingen te berekenen, is het nuttig om te weten hoe je de traceringresultaten kunt lezen en analyseren.
De bron van de bestandsdescriptor kan een van de vele systeemaanroepen zijn (afhankelijk van waarvoor de descriptor is — voor de console, een netwerksocket, een bestand, of iets anders), maar hoe dan ook, we zoeken de aanroepen op door 3 terug te geven (d.w.z. we zoeken ‘= 3’ in de traceringresultaten). In dit resultaat zijn er 2: openat aan de bovenkant en socket in het midden. openat open het bestand, maar sluiten(3) laat vervolgens zien dat het opnieuw wordt gesloten. (Valstrik: bestandsdescriptoren kunnen opnieuw worden gebruikt wanneer ze worden geopend en gesloten). De aanroep socket() is geschikt, aangezien dit de laatste is vóór read(), en het blijkt dat bcrontab werkt met iets via de socket. De volgende regel laat zien dat de bestandsdescriptor verbonden is met unix domein socket aan het pad /var/run/bcron-spool.
Dus, we moeten het proces vinden dat gebonden is aan de unix socket aan de andere kant. Hiervoor zijn er een paar elegante trucs, en beide zullen nuttig zijn voor het debuggen van serverimplementaties. De eerste is om netstat of een nieuwere ss (socket status). Beide commando's tonen actieve netwerken van de systemen en nemen de operator -l voor het beschrijven van de luisterende sockets, alsook de operator -p voor het weergeven van programma's die als cliënt met de socket zijn verbonden. (Er zijn veel meer nuttige opties, maar voor deze taak zijn deze twee voldoende.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
Dit geeft aan dat de luisterende — dat is het commando inixserver, werkend met proces-ID 20629. (En toevallig gebruikt het bestandshandler 3 als socket.)
Een tweede echt nuttige tool voor het vinden van dezelfde informatie heet lsof. Het somt alle geopende bestanden (of bestandshandlers) in het systeem op. Of je kunt informatie over één specifiek bestand krijgen:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
Proces 20629 is een langlevende server, dus je kunt eraan vastbinden strace met iets als strace -o /tmp/trace -p 20629. Als je de cron-taak in een ander terminal venster bewerkt, krijg je de output van de traceerresultaten met de optredende fout. En hier is het resultaat:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Wordt herstart als SA_RESTART is ingesteld)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Geen kindprocessen)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Wordt herstart als SA_RESTART is ingesteld)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Geen kindprocessen)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(De laatste accept() zal niet worden afgerond tijdens de tracing.) En wederom, zo jammer, maar dit resultaat bevat niet de fout die we zoeken. We zien geen berichten die bcrontag naar de socket heeft gestuurd of ervan heeft ontvangen. In plaats daarvan alleen procesbeheer (clone, wait4, SIGCHLD en dit proces genereert een subproces dat, zoals je zou kunnen raden, het echte werk uitvoert. En als je de spoor hiervan wilt vangen, voeg dan toe aan de oproep strace -f. Dit is wat we zullen vinden als we naar het foutbericht zoeken in de nieuwe strace-uitvoer -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Toegang geweigerd)
21470 write(1, "32:ZKon tijdelijk bestand niet aanmaken f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatale: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Geen dergelijk bestand of directory)
21470 exit_group(111)                   = ?
21470 +++ vertrokken met 111 +++
Kijk, dat is al iets. Proces 21470 krijgt een 'toegang geweigerd' foutmelding bij het proberen aanmaken van een bestand op het pad tmp/spool.21470.1573692319.854640 (betreffende de huidige werkdirectory). Als we gewoon wisten wat de huidige werkdirectory was, zouden we ook het volledige pad kennen en konden we uitvinden waarom het proces daar zijn tijdelijke bestand niet kan aanmaken. Helaas is het proces al beëindigd, dus we kunnen gewoon niet gebruiken lsof -p 21470 om de huidige directory te vinden, maar we kunnen in omgekeerde volgorde werken - op zoek naar systeemaanroepen PID 21470 die de directory veranderen. (Als die er niet zijn, heeft PID 21470 ze waarschijnlijk van de ouder geërfd, en dat is al via lsof -p niet te achterhalen.) Deze systeemaanroep is chdir (wat niet moeilijk te achterhalen is met de moderne zoekmachines). En hier is het resultaat van de reverse zoekopdrachten op basis van de output, tot de server PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 vars */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Toegang geweigerd)
21470 write(1, "32:ZKon tijdelijk bestand niet aanmaken f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatale: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Geen dergelijk bestand of directory)
21470 exit_group(111)                   = ?
21470 +++ vertrokken met 111 +++
(Als je verdwaald bent, is het misschien een goed idee om mijn vorige post te lezen .) Dus, server PID 20629 heeft geen toestemming gekregen om een bestand aan te maken op het pad /var/spool/cron/tmp/spool.21470.1573692319.854640. Hoogstwaarschijnlijk is de oorzaak hiervan de klassieke bestandssysteemmachtigingen. Laten we dat controleren:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
Hier is waar het probleem zit! De server draait als een gebruikerscron, maar alleen root heeft toestemming om naar de directory te schrijven /var/spool/cron/tmp/. Een eenvoudige opdracht chown cron /var/spool/cron/tmp/ zal het mogelijk maken bcron correct werken. (Als het probleem hier niet ligt, dan is de volgende meest waarschijnlijke verdachte een beveiligingsmodule van het kerneltype zoals SELinux of AppArmor, dus zou ik het kernellogboek controleren met behulp van dmesg.)
Total
Voor een beginner kan het moeilijk zijn om door de resultaten van systeemaanroep-tracering heen te komen, maar ik hoop dat ik heb laten zien dat ze een snelle manier zijn om een breed scala aan veel voorkomende implementatieproblemen te beheren. Stel je voor dat je probeert de debugging van een multi-process bcron, met een stap-voor-stap debugger.
Het analyseren van de traceresultaten terug langs de keten van systeemaanroepen vereist vaardigheid, maar zoals ik al zei, gebruik ik bijna altijd strace, krijg ik gewoon de trace-uitvoer en zoek ik naar fouten, beginnend vanaf het einde. Hoe dan ook, strace helpt me enorm veel tijd te besparen bij debugging. Hopelijk is het ook nuttig voor jou.
Bron: habr.com
