

Olá a todos. Neste artigo, vou explicar por que escolhemos o Kafka na Avito há nove meses e o que ele realmente é. Vou compartilhar um dos casos de uso — um corretor de mensagens. E, por último, falaremos sobre os benefícios que obtivemos com a abordagem Kafka as a Service.
O problema
Para começar, um pouco de contexto. Há algum tempo, começamos a nos distanciar da arquitetura monolítica, e agora na Avito já temos várias centenas de serviços diferentes. Cada um possui seu próprio armazenamento, sua própria stack de tecnologias e é responsável por uma parte da lógica de negócios.
Um dos problemas com um grande número de serviços é a comunicação. O serviço A frequentemente deseja saber informações que o serviço B possui. Nesse caso, o serviço A se comunica com o serviço B através de uma API síncrona. O serviço C quer saber o que acontece com os serviços D e E, enquanto E e D, por sua vez, estão interessados nos serviços A e B. Quando há muitos serviços 'curiosos', as conexões entre eles se tornam um emaranhado complexo.
Além disso, a qualquer momento, o serviço A pode ficar indisponível. E o que fazer nesse caso com o serviço B e todos os outros serviços que dependem dele? E se para executar uma operação comercial for necessário realizar uma cadeia de chamadas síncronas consecutivas, a probabilidade de falha de toda a operação aumenta ainda mais (e maior é essa probabilidade quanto mais longa for a cadeia).
Escolha da tecnologia
Ok, os problemas estão claros. Podemos resolvê-los criando um sistema centralizado de troca de mensagens entre os serviços. Agora, cada um dos serviços só precisa saber sobre esse sistema de troca de mensagens. Além disso, o próprio sistema deve ser tolerante a falhas e escalável horizontalmente, e, em caso de falha, deve acumular um buffer de chamadas para tratamento posterior.
Agora vamos escolher a tecnologia na qual a entrega de mensagens será implementada. Para isso, primeiro vamos entender o que esperamos dela:
- as mensagens entre os serviços não devem ser perdidas;
- as mensagens podem ser duplicadas;
- as mensagens podem ser armazenadas e lidas com uma profundidade de vários dias (buffer persistente);
- os serviços podem se inscrever em dados que lhes interessam;
- vários serviços podem ler os mesmos dados;
- as mensagens podem conter um payload detalhado e volumoso (transferência de estado carregada por evento);
- às vezes é necessária a garantia da ordem das mensagens.
Além disso, era crucial para nós escolher um sistema o mais escalável e confiável possível, com alta capacidade de processamento (pelo menos 100 mil mensagens de vários kilobytes por segundo).
Nesta fase, nos despediu do RabbitMQ (difícil de manter estável em altas taxas de RPS), PGQ do SkyTools (não rápido o suficiente e mal escalável) e NSQ (não persistente). Todas essas tecnologias são utilizadas em nossa empresa, mas não se adequavam à tarefa em questão.
Em seguida, começamos a olhar para novas tecnologias para nós — Apache Kafka, Apache Pulsar e NATS Streaming.
Resolvemos descartar o Pulsar primeiro. Decidimos que Kafka e Pulsar são soluções bastante semelhantes. E embora o Pulsar tenha sido testado por grandes empresas, seja mais novo e ofereça menor latência (em teoria), optamos por manter o Kafka como padrão de fato para essas tarefas. É provável que voltemos ao Apache Pulsar no futuro.
E assim restaram dois candidatos: NATS Streaming e Apache Kafka. Estudamos ambos os sistemas detalhadamente, e ambos se adequavam à tarefa. Mas, no final, tememos a relativa juventude do NATS Streaming (e o fato de que um dos principais desenvolvedores, Tyler Treat, decidiu deixar o projeto e iniciar o seu próprio — Liftbridge). Ao mesmo tempo, o modo de Cluster do NATS Streaming não oferecia grande escalabilidade horizontal (provavelmente, isso já não é um problema após a adição do modo de particionamento em 2017).
No entanto, o NATS Streaming é uma tecnologia incrível, escrita em Go e com suporte da Cloud Native Computing Foundation. Ao contrário do Apache Kafka, ele não precisa do Zookeeper para funcionar (possivelmente, ), uma vez que implementa RAFT internamente. Além disso, o NATS Streaming é mais fácil de administrar. Não descartamos que, no futuro, possamos voltar a essa tecnologia.
Ainda assim, até hoje, nosso vencedor foi o Apache Kafka. Em nossos testes, ele se mostrou bastante rápido (mais de um milhão de mensagens por segundo tanto para leitura quanto para escrita com mensagens de 1 kilobyte), bastante confiável, bem escalável e testado na prática por grandes empresas. Além disso, o Kafka é suportado por pelo menos várias grandes empresas comerciais (nós, por exemplo, usamos a versão da Confluent), e também possui um ecossistema robusto.
Visão geral do Kafka
Antes de começar, recomendo imediatamente um excelente livro — «Kafka: The Definitive Guide» (existe também na tradução em russo, mas os termos podem ser um pouco confusos). Nele, você pode encontrar informações necessárias para uma compreensão básica do Kafka e até um pouco mais. A própria documentação da Apache e o blog da Confluent também são bem escritos e fáceis de ler.
Então, vamos dar uma olhada em como o Kafka é estruturado de uma perspectiva geral. A topologia básica do Kafka consiste em produtor, consumidor, corretor e zookeeper.
Corretor
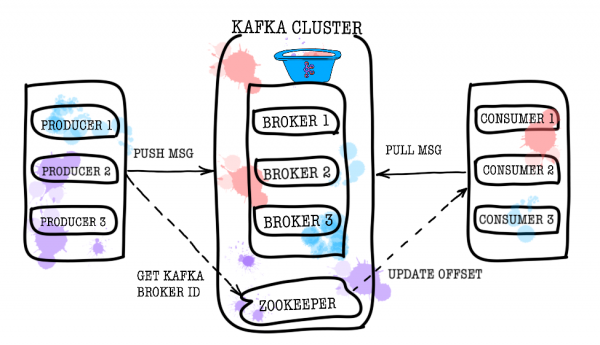
O corretor (broker) é responsável pelo armazenamento dos seus dados. Todos os dados são armazenados em formato binário, e o corretor pouco sabe sobre o que eles representam e qual é sua estrutura.
Cada tipo lógico de evento geralmente está em seu próprio tópico (topic). Por exemplo, um evento de criação de anúncio pode ir para o tópico item.created, enquanto um evento de alteração vai para item.changed. Os tópicos podem ser vistos como classificadores de eventos. No nível do tópico, é possível definir parâmetros de configuração como:
- volume de dados armazenados e/ou sua idade (retention.bytes, retention.ms);
- fator de redundância de dados (replication factor);
- tamanho máximo de uma mensagem (max.message.bytes);
- número mínimo de réplicas em sincronia necessárias para que dados possam ser escritos no tópico (min.insync.replicas);
- possibilidade de fazer failover para uma réplica desatualizada, com potencial perda de dados (unclean.leader.election.enable);
- e muitos outros ().
Por sua vez, cada tópico é dividido em uma ou mais partições (partition). É nas partições que os eventos acabam sendo armazenados. Se houver mais de um corretor no cluster, as partições serão distribuídas uniformemente entre todos os corretores (na medida do possível), o que permite escalonar a carga de gravação e leitura de um único tópico em vários corretores ao mesmo tempo.
No disco, os dados de cada partição são armazenados como arquivos de segmentos, que por padrão têm um gigabyte (controlado através de log.segment.bytes). Uma característica importante é que a remoção de dados das partições (quando a retenção é acionada) acontece em segmentos (não é possível remover um único evento de uma partição, apenas um segmento inteiro, e somente se estiver inativo).
Zookeeper
O Zookeeper atua como um repositório de metadados e coordenador. Ele é capaz de dizer se os corretores estão ativos (isso pode ser visto através do Zookeeper com o comando ls /brokers/ids), qual dos corretores é o controlador (get /controller), estão as partições em estado de sincronia com suas réplicas (get /brokers/topics/topic_name/partitions/partition_number/state). Também, até mesmo o zookeeper inicialmente receberá o produtor e o consumidor, para descobrir em qual corretora estão armazenados quais tópicos e partições. Nos casos em que o fator de replicação para o tópico é maior que 1, o zookeeper indicará quais partições são líderes (nelas ocorrerá a gravação e delas a leitura). Caso uma corretora falhe, as informações sobre novos líderes de partições serão registradas no zookeeper (a partir da versão 1.1.0 de forma assíncrona, ).
Em versões mais antigas do Kafka, o zookeeper também era responsável pelo armazenamento de offsets, mas agora eles são armazenados em um tópico especial __consumer_offsets na corretora (embora você ainda possa usar o zookeeper para esses fins).
A maneira mais simples de transformar seus dados em abóbora é exatamente a perda de informações com o zookeeper. Nesse cenário, entender o que e de onde precisa ser lido será muito difícil.
Producer
O produtor — geralmente é um serviço que grava diretamente dados no Apache Kafka. O produtor escolhe o tópico onde suas mensagens temáticas serão armazenadas e começa a gravar informações nele. Por exemplo, o produtor pode ser um serviço de anúncios. Nesse caso, ele enviará para os tópicos temáticos eventos como "anúncio criado", "anúncio atualizado", "anúncio removido", etc. Cada evento, portanto, representa um par chave-valor.
Por padrão, todos os eventos são distribuídos entre as partições do tópico em round-robin, se a chave não for especificada (perdendo a ordenação), e através do MurmurHash (chave), se a chave estiver presente (manutenção da ordenação dentro de uma partição).
Aqui é importante observar que o Kafka garante a ordem dos eventos apenas dentro de uma partição. Mas, na verdade, isso muitas vezes não é um problema. Por exemplo, pode-se garantir que todas as alterações de um mesmo anúncio sejam adicionadas a uma partição (mantendo assim a ordem dessas alterações dentro do anúncio). Também é possível transmitir um número sequencial em um dos campos do evento.
Consumer
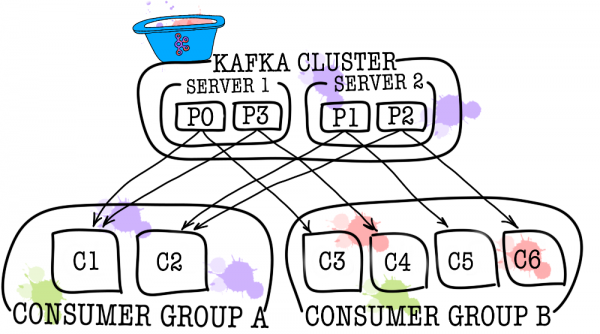
O consumidor é responsável por receber dados do Apache Kafka. Se voltarmos ao exemplo acima, o consumidor pode ser um serviço de moderação. Este serviço ficará inscrito no tópico do serviço de anúncios e, quando um novo anúncio aparecer, receberá e analisará em conformidade com algumas políticas definidas.
O Apache Kafka lembra quais são os últimos eventos recebidos pelo consumidor (para isso, utiliza-se um tópico de serviço __consumer__offsets), garantindo assim que, após uma leitura bem-sucedida, o consumidor não receba a mesma mensagem duas vezes. No entanto, se você usar a opção enable.auto.commit = true e deixar completamente a responsabilidade do rastreamento da posição do consumidor no tópico para o Kafka, pode-se . No código de produção, geralmente, a posição do consumidor é controlada manualmente (o desenvolvedor gerencia o momento em que o commit do evento lido deve necessariamente ocorrer).
Nos casos em que um único consumidor não é suficiente (por exemplo, quando o fluxo de novos eventos é muito grande), é possível adicionar mais consumidores, vinculando-os em um grupo de consumidores. O grupo de consumidores representa logicamente o mesmo consumidor, mas com a distribuição de dados entre os membros do grupo. Isso permite que cada um dos participantes receba sua parte das mensagens, escalando assim a velocidade de leitura.
Resultados do teste
Aqui não vou escrever muito texto explicativo, apenas compartilharei os resultados obtidos. Os testes foram realizados em 3 máquinas físicas (12 CPU, 384GB de RAM, 15k SAS DISK, 10GBit/s Net), com os brokers e o zookeeper implantados em lxc.
Testes de desempenho
Durante os testes, foram obtidos os seguintes resultados.
- A velocidade de gravação de mensagens de 1KB simultaneamente por 9 produtores foi de 1.300.000 eventos por segundo.
- A velocidade de leitura de mensagens de 1KB simultaneamente por 9 consumidores foi de 1.500.000 eventos por segundo.
Testes de resistência
Durante os testes, foram obtidos os seguintes resultados (3 brokers, 3 zookeepers).
- A falha de um dos brokers não leva à parada ou indisponibilidade do cluster. O trabalho continua normalmente, mas os brokers restantes enfrentam uma carga maior.
- O encerramento inesperado de dois brokers em um cluster de três brokers com min.isr = 2 resulta na indisponibilidade do cluster para gravação, mas disponível para leitura. Se min.isr = 1, o cluster permanece disponível tanto para leitura quanto para gravação. No entanto, esse modo contraria a exigência de alta durabilidade dos dados.
- O encerramento inesperado de um dos servidores Zookeeper não leva à parada ou indisponibilidade do cluster. O funcionamento continua normalmente.
- O encerramento inesperado de dois servidores Zookeeper resulta na indisponibilidade do cluster até que pelo menos um dos servidores Zookeeper seja restaurado. Essa afirmação é verdadeira para um cluster Zookeeper com 3 servidores. Como resultado de pesquisas, foi decidido aumentar o cluster Zookeeper para 5 servidores para aumentar a resiliência.
Kafka como serviço
Constatamos que o Kafka é uma excelente tecnologia que nos permite resolver a tarefa proposta (implementação de um broker de mensagens). No entanto, decidimos proibir que os serviços acessassem o Kafka diretamente e o encerramos acima do serviço data-bus. Por que fizemos isso? Na verdade, há várias razões.
O data-bus assumiu todas as tarefas relacionadas à integração com o Kafka (implementação e configuração de consumers e producers, monitoramento, alertas, registro, escalabilidade, etc.). Assim, a integração com o broker de mensagens ocorre da forma mais simples possível.
O data-bus permitiu abstrair de uma linguagem ou biblioteca específica para trabalhar com o Kafka.
O data-bus permitiu que outros serviços se abstraíssem da camada de armazenamento. Pode ser que, em algum momento, mudemos o Kafka para o Pulsar, e isso não será percebido (todos os serviços conhecem apenas a API do data-bus).
O data-bus assumiu a validação dos esquemas de eventos.
Com o data-bus, foi implementada a autenticação.
Sob a cobertura do data-bus, podemos atualizar as versões do Kafka sem tempo de inatividade, de forma invisível, gerenciar centralizadamente as configurações de producers, consumers, brokers, etc.
O data-bus permitiu adicionar os recursos necessários que não estão no Kafka (como auditoria de tópicos, controle de anomalias no cluster, criação de DLQ, etc.).
O data-bus permite implementar failover de forma centralizada para todos os serviços.
Atualmente, para começar a enviar eventos para o broker de mensagens, basta conectar uma pequena biblioteca no código do seu serviço. É tudo. Você tem a possibilidade de escrever, ler e escalar com uma única linha de código. Toda a implementação está oculta para você; o que aparece externamente é apenas algumas configurações, como o tamanho do lote. Sob o capô, o serviço data-bus levanta a quantidade necessária de instâncias de producers e consumers no Kubernetes e fornece a configuração necessária, tudo de forma transparente para o seu serviço.
Claro, não existe uma solução mágica, e essa abordagem tem suas limitações.
- O data-bus precisa ser mantido por você mesmo, ao contrário de bibliotecas de terceiros.
- O data-bus aumenta o número de interações entre serviços e o broker de mensagens, o que leva a uma diminuição de desempenho em comparação com a Kafka pura.
- Nem tudo pode ser tão facilmente ocultado dos serviços; duplicar a funcionalidade do KSQL ou Kafka Streams no data-bus não é algo que queremos, então às vezes precisamos permitir que os serviços acessem diretamente.
No nosso caso, os benefícios superaram as desvantagens, e a decisão de ocultar o broker de mensagens atrás de um serviço separado se mostrou válida. Em um ano de operação, não tivemos nenhuma falha ou problema sério.
P.S. Agradeço à minha namorada, Ekaterina Obalyaeva, pelas ilustrações incríveis para este artigo. Se você gostou delas, mais ilustrações estarão disponíveis.
Fonte: habr.com
