

Cada vez mais, recebemos solicitações dos clientes como: "Queremos algo como o Amazon RDS, mas mais barato"; "Queremos algo como o RDS, mas em qualquer infraestrutura". Para realizar uma solução gerenciada semelhante no Kubernetes, analisamos o estado atual dos operadores mais populares para PostgreSQL (Stolon, operadores da Crunchy Data e da Zalando) e fizemos nossa escolha.
Este artigo é nossa experiência adquirida tanto do ponto de vista teórico (revisão de soluções) quanto do lado prático (o que foi escolhido e o que resultou disso). Mas, antes de tudo, vamos definir quais são os requisitos para uma possível substituição do RDS...
O que é o RDS?
Quando as pessoas falam sobre RDS, pela nossa experiência, elas se referem a um serviço gerenciado (managed) de SGBD que:
- é fácil de configurar;
- tem a capacidade de trabalhar com snapshots e se recuperar deles (preferencialmente com suporte a );
- permite criar topologias master-slave;
- tem uma lista rica de extensões;
- oferece auditoria e gestão de usuários/acessos.
De maneira geral, as abordagens para a implementação da tarefa proposta podem ser bastante variadas, no entanto, o caminho com o condicional Ansible não nos agrada. (Os colegas da 2GIS chegaram a uma conclusão semelhante após de criar "uma ferramenta para a rápida implantação de um cluster tolerante a falhas baseado em Postgres".)
Os operadores são a abordagem amplamente aceita para resolver tarefas semelhantes no ecossistema Kubernetes. Mais detalhes sobre eles em relação a bancos de dados executados dentro do Kubernetes já foram abordados pelo diretor técnico da "Flanta", , neste teste de 2015 .
NB: Para a criação rápida de operadores simples, recomendamos prestar atenção à nossa ferramenta Open Source . Usando-a, é possível fazer isso sem conhecimento de Go, utilizando métodos mais familiares para administradores de sistema: em Bash, Python, etc.
Existem vários operadores populares para K8s no PostgreSQL:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Vamos analisá-los mais de perto.
Escolha do operador
Além das importantes funcionalidades já mencionadas, nós — como engenheiros de operação de infraestrutura no Kubernetes — também esperávamos dos operadores o seguinte:
- deploy a partir do Git e com ;
- suporte à anti-affinity de pods;
- instalação de node affinity ou node selector;
- instalação de tolerances;
- possibilidade de tunning;
- tecnologias compreensíveis e até mesmo comandos.
Sem entrar em detalhes sobre cada um dos pontos (perguntem nos comentários se houver dúvidas após a leitura de todo o artigo), gostaria de ressaltar que esses parâmetros são necessários para uma descrição mais precisa da especialização dos nós do cluster, permitindo que sejam encomendados de acordo com aplicações específicas. Assim, podemos alcançar um equilíbrio ideal entre desempenho e custo.
Agora, vamos aos operadores do PostgreSQL.
1. Stolon
da empresa italiana Sorint.lab em foi considerado um padrão entre os operadores para SGBDs. É um projeto bastante antigo: seu primeiro lançamento público ocorreu em novembro de 2015(!), e o repositório do GitHub pode se orgulhar de quase 3000 estrelas e mais de 40 contribuidores.
E realmente, o Stolon é um excelente exemplo de uma arquitetura bem pensada:
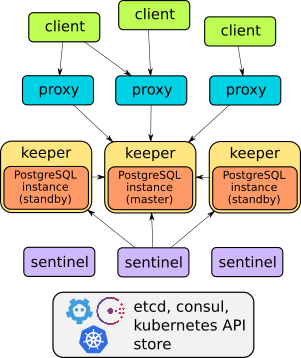
Os detalhes sobre este operador podem ser encontrados no relatório ou . De modo geral, pode-se dizer que ele realiza tudo o que foi descrito: failover, proxy para acesso transparente dos clientes, backups... E o proxy fornece acesso através de um único endpoint de serviço — ao contrário das outras duas soluções que serão discutidas a seguir (as quais têm dois serviços para acesso ao banco).
No entanto, o Stolon , o que impossibilita sua implementação de uma maneira simples e rápida — "como pãezinhos quentes" — para criar instâncias de SGBD no Kubernetes. A gestão é feita através da utilidade stolonctl, a implantação — através do Helm chart, e os usuários definem as configurações no ConfigMap.
Por um lado, parece que o operador não é realmente um operador (já que não utiliza CRD). Mas, por outro lado, é um sistema flexível que permite configurar recursos no K8s de acordo com suas necessidades.
Resumindo, para nós, não parecia ideal criar um chart separado para cada banco de dados. Portanto, começamos a procurar alternativas.
2. Crunchy Data PostgreSQL Operator
, uma jovem startup americana, parecia uma alternativa lógica. Sua história pública começa com o primeiro lançamento em março de 2017, desde então o repositório do GitHub recebeu pouco menos de 1300 estrelas e mais de 50 contribuidores. O último lançamento de setembro foi testado para funcionar com Kubernetes 1.15—1.18, OpenShift 3.11+ e 4.4+, GKE e VMware Enterprise PKS 1.3+.
A arquitetura do Crunchy Data PostgreSQL Operator também atende aos requisitos declarados:
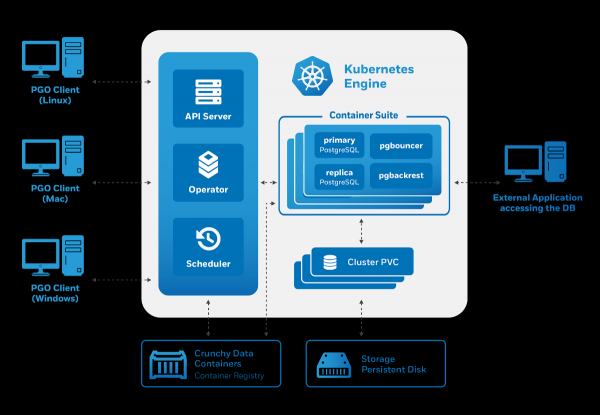
A gestão ocorre através da utilidade pgo, no entanto, ele por sua vez gera Recursos Personalizados para Kubernetes. Portanto, nós, como potenciais usuários, ficamos satisfeitos com o operador:
- há gerenciamento via CRD;
- gerenciamento conveniente de usuários (também via CRD);
- integração com outros componentes — uma coleção especializada de imagens de contêineres para PostgreSQL e utilitários para trabalhar com ela (incluindo pgBackRest, pgAudit, extensões do contrib, etc.).
No entanto, as tentativas de começar a usar o operador da Crunchy Data revelaram alguns problemas:
- Não havia possibilidade de tolerâncias — apenas o nodeSelector estava disponível.
- Os pods criados faziam parte do Deployment, mesmo que estivéssemos implantando uma aplicação stateful. Ao contrário do StatefulSet, os Deployments não conseguem criar discos.
Essa última desvantagem leva a momentos curiosos: no ambiente de teste, foi possível iniciar 3 réplicas com um único disco armazenamento local, resultando em o operador relatar que 3 réplicas estavam em funcionamento (embora isso não fosse verdade).
Outra característica deste operador é sua integração pronta com vários sistemas auxiliares. Por exemplo, é fácil instalar o pgAdmin e o pgBounce, enquanto a pré-configuração do Grafana e Prometheus está sendo considerada. No recente destaca-se a melhoria na integração com o projeto , permitindo que o operador ofereça uma visualização clara das métricas PgSQL "out of the box".
No entanto, a escolha estranha dos recursos do Kubernetes gerados nos levou à necessidade de encontrar outra solução.
3. Zalando Postgres Operator
Os produtos Zalando são conhecidos por nós há muito tempo: temos experiência com o Zalenium e, claro, tentamos — sua popular solução HA para PostgreSQL. Sobre a abordagem da empresa para criar o falou um de seus autores — Alexey Klyukin — no ar , e nós gostamos.
Esta é a solução mais recente entre as consideradas no artigo: o primeiro lançamento ocorreu em agosto de 2018. No entanto, mesmo com um número relativamente pequeno de lançamentos formais, o projeto percorreu um longo caminho, já superando em popularidade a solução da Crunchy Data com mais de 1300 estrelas no GitHub e o maior número de colaboradores (70+).
"Por baixo do capô" deste operador, são usadas soluções testadas pelo tempo:
- Patroni e para gerenciamento,
- — para backups,
- — como pool de conexões.
Veja como a arquitetura do operador da Zalando é apresentada:
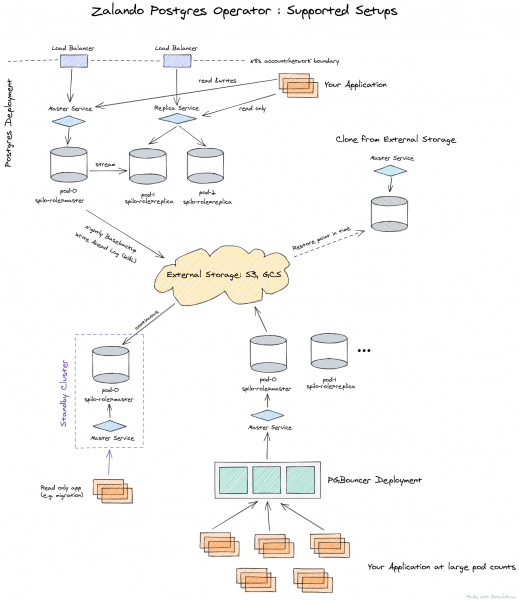
O operador é gerenciado completamente através de Recursos Personalizados, criando automaticamente um StatefulSet a partir de contêineres, que podem então ser personalizados adicionando diferentes sidecars ao pod. Tudo isso é uma vantagem significativa em comparação ao operador da Crunchy Data.
Uma vez que escolhamos a solução da Zalando entre as 3 opções consideradas, a descrição de suas funcionalidades será apresentada abaixo, junto com a prática de aplicação.
Prática com o Postgres Operator da Zalando
O deploy do operador é muito simples: basta baixar a versão mais recente do GitHub e aplicar os arquivos YAML do diretório . Como alternativa, você também pode usar .
Após a instalação, é necessário configurar . A configuração é feita através do ConfigMap postgres-operator no namespace onde você instalou o operador. Quando os armazenamentos estão configurados, é possível implantar o primeiro cluster PostgreSQL.
Por exemplo, o deploy padrão que temos é o seguinte:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Este manifesto implanta um cluster de 3 instâncias com sidecar na forma de , do qual coletamos métricas da aplicação. Como você pode ver, tudo é muito simples, e se desejar, é possível criar virtualmente um número ilimitado de clusters.
Vale a pena prestar atenção também na interface da web para administração — . Ela é fornecida junto com o operador e permite criar e excluir clusters, além de trabalhar com os backups que o operador gera.
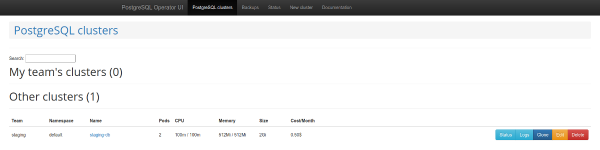
Lista de clusters PostgreSQL
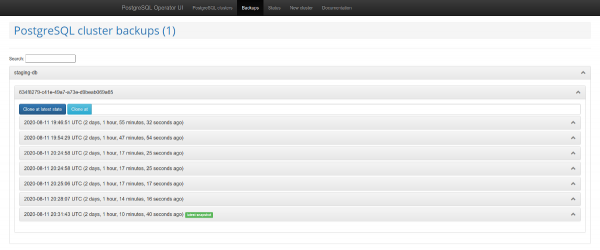
Gerenciamento de backups
Outra característica interessante é o suporte ao . Este mecanismo cria automaticamente funções no PostgreSQL, com base na lista de nomes de usuários recebida. Depois disso, a API permite retornar a lista de usuários para os quais as funções são criadas automaticamente.
Problemas e suas soluções
Entretanto, o uso do operador logo revelou algumas desvantagens significativas:
- a falta de suporte ao nodeSelector;
- impossibilidade de desativar backups;
- ao usar a função de criação de bancos, as permissões padrão não aparecem;
- periodicamente falta documentação ou ela está desatualizada.
Felizmente, muitos desses problemas podem ser resolvidos. Vamos começar pelo fim — problemas com documentação.
É provável que você se depare com a dificuldade de entender como configurar backups e como conectar o bucket de backup à interface do Operator. Isso é mencionado brevemente na documentação, enquanto a descrição real está em :
- é necessário criar um segredo;
- passá-lo ao operador como parâmetro
pod_environment_secret_nameno CRD com as configurações do operador ou no ConfigMap (depende de como você decidiu instalar o operador).
No entanto, como se descobriu, atualmente isso não é possível. É por isso que reunimos com algumas contribuições adicionais de terceiros. Mais detalhes sobre isso - veja abaixo.
Se você passar parâmetros para o operador para o backup, nomeadamente — wal_s3_bucket e as chaves de acesso no AWS S3, então ele fará backup de tudo: não apenas de bancos em produção, mas também de staging. Isso não nos agradou.
Na descrição dos parâmetros do Spilo, que é a camada Docker básica para PgSQL ao usar o operador, descobriu-se que você pode passar o parâmetro WAL_S3_BUCKET vazio, desativando assim os backups. Além disso, para nossa grande alegria, foi encontrado um , que aceitamos imediatamente em nosso fork. Agora é suficiente apenas adicionar enableWALArchiving: false ao recurso do cluster PostgreSQL.
Sim, havia a possibilidade de fazer isso de outra forma, executando 2 operadores: um para staging (sem backups) e outro - para produção. Mas assim conseguimos nos sair bem com um só.
Ok, nós aprendemos a conceder acesso ao S3 nos bancos e os backups começaram a ser enviados para o armazenamento. Como ativar as páginas de backups na interface do Operator?
Na interface do Operator, você precisará adicionar 3 variáveis:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Depois disso, a gestão dos backups estará disponível, o que no nosso caso simplificará o trabalho com staging, permitindo enviar cópias da produção sem scripts adicionais.
Como um ponto adicional, mencionou-se o trabalho com a API Teams e as amplas possibilidades de criação de bancos e funções por meio do operador. No entanto, os papéis criados não tinham permissões padrão.Consequentemente, o usuário com permissões de leitura não conseguia acessar novas tabelas.
Por que isso? Apesar de que no código necessário GRANT, eles não são aplicados sempre. Existem 2 métodos: syncPreparedDatabases e syncDatabases. No syncPreparedDatabases — apesar de a seção preparedDatabases ter uma condição defaultRoles e defaultUsers para criar funções, — as permissões padrão não são aplicadas. Estamos preparando um patch para que essas permissões sejam aplicadas automaticamente.
E o último ponto nas melhorias relevantes para nós — , adicionando Node Affinity no StatefulSet criado. Nossos clientes frequentemente preferem reduzir custos usando instâncias spot, e claramente não é prudente hospedar serviços de banco de dados nelas. Essa questão poderia ser resolvida através de tolerações, mas a presença de Node Affinity proporciona maior segurança.
O que conseguimos?
Como resultado da resolução dos problemas mencionados, nós bifurcamos o Postgres Operator da Zalando para , onde ele é construído com patches tão úteis. E para maior conveniência, também .
Lista de PRs aceitos na bifurcação:
- ;
- ;
- ;
- .
Seria ótimo se a comunidade apoiasse esses PRs para que eles fossem incluídos na upstream com a próxima versão do operador (1.6).
Bônus! História de sucesso com a migração de produção
Se você usa o Patroni, pode migrar uma produção ativa para o operador com um mínimo de tempo de inatividade.
Spilo permite fazer clusters de standby através do armazenamento S3 com , quando o log binário do PgSQL é primeiro salvo no S3 e depois extraído pela réplica. Mas o que fazer se você não está usando Wal-E em uma infraestrutura antiga? A solução para esse problema já no Habr.
A lógica de replicação do PostgreSQL vem ao nosso socorro. No entanto, não vamos entrar em detalhes sobre como criar publicações e assinaturas, porque… nosso plano falhou.
O problema é que o banco de dados tinha várias tabelas sobrecarregadas com milhões de linhas, que, além disso, eram constantemente preenchidas e deletadas. com copy_data, em que uma nova réplica copia todo o conteúdo do mestre, simplesmente não conseguia acompanhar o mestre. A cópia do conteúdo funcionou por uma semana, mas não conseguiu alcançar o mestre. No final, conseguimos resolver o problema com a ajuda de colegas da Avito: é possível transferir dados usando pg_dump. Vou descrever nossa (um pouco aprimorada) versão desse algoritmo.
A ideia é criar uma assinatura desligada, ligada a um slot de replicação específico, e depois corrigir o número da transação. Replcas estavam disponíveis para o funcionamento da produção. Isso é importante, pois a réplica ajudará a criar um dump consistente e continuar recebendo mudanças do mestre.
Nos comandos subsequentes que descrevem o processo de migração, serão usados os seguintes termos para os hosts:
- master — servidor de origem;
- replica1 — réplica de streaming do antigo production;
- replica2 — nova réplica lógica.
Plano de migração
1. Vamos criar no mestre uma assinatura para todas as tabelas no esquema public do banco dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Vamos criar um slot de replicação no mestre:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Vamos parar a replicação na antiga réplica:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Vamos obter o número da transação do mestre:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Vamos fazer o dump da antiga réplica. Faremos isso em várias threads, o que ajudará a acelerar o processo:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Vamos carregar o dump no novo servidor:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Após carregar o dump, a replicação pode ser iniciada na réplica de streaming:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Vamos criar uma assinatura na nova réplica lógica:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Vamos obter oid da assinatura:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Suponha que foi obtido oid=1000. Vamos aplicar o número da transação à assinatura:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Vamos iniciar a replicação:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Vamos verificar o status da assinatura; a replicação deve estar funcionando:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Depois que a replicação for iniciada e os bancos estiverem sincronizados, a troca pode ser realizada.
13. Após desligar a replicação, é necessário corrigir as sequências. Isso está bem descrito .
Com esse plano, a troca ocorreu com mínimas interrupções.
Conclusão
Os operadores Kubernetes simplificam várias ações, reduzindo-as à criação de recursos K8s. No entanto, ao alcançar uma automação notável com eles, é importante lembrar que isso pode trazer uma série de nuances inesperadas, portanto, escolha os operadores com sabedoria.
Após considerar os três operadores Kubernetes mais populares para PostgreSQL, escolhemos o projeto da Zalando. Embora tenhamos encontrado algumas dificuldades, o resultado realmente nos agradou, e planejamos expandir essa experiência para algumas outras instalações PgSQL. Se você tiver experiência com soluções semelhantes, adoraríamos ver os detalhes nos comentários!
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
