

A classificação de dados baseada em conteúdo é um problema em aberto. Os sistemas tradicionais de prevenção contra perda de dados (DLP) resolvem esse problema identificando os dados relevantes e monitorando os terminais para impressão digital. Dado o grande número de recursos de dados em constante mudança no Facebook, esta abordagem não só não é escalável, como também é ineficaz para determinar onde os dados residem. Este artigo se concentra em um sistema ponta a ponta construído para detectar tipos semânticos confidenciais no Facebook em escala e aplicar automaticamente o armazenamento de dados e o controle de acesso.
A abordagem descrita aqui é o nosso primeiro sistema de privacidade ponta a ponta que tenta resolver esse problema incorporando sinais de dados, aprendizado de máquina e técnicas tradicionais de impressão digital para mapear e classificar todos os dados no Facebook. O sistema descrito é operado em um ambiente de produção, alcançando uma pontuação F2 média de 0,9+ em várias classes de privacidade enquanto processa grandes quantidades de recursos de dados em dezenas de repositórios. Apresentando uma tradução do artigo ArXiv do Facebook sobre classificação escalonável de dados para segurança e privacidade com base em aprendizado de máquina.
Introdução
Hoje, as organizações coletam e armazenam grandes quantidades de dados em uma variedade de formatos e locais [1], então os dados são consumidos em muitos lugares, às vezes copiados ou armazenados em cache várias vezes, resultando na dispersão de informações comerciais valiosas e confidenciais por muitos dados corporativos. lojas. Quando uma organização é obrigada a cumprir determinados requisitos legais ou regulamentares, tais como o cumprimento de regulamentos em processos civis, torna-se necessário recolher dados sobre a localização dos dados necessários. Quando uma regulamentação de privacidade determina que uma organização deve mascarar todos os números de segurança social (SSNs) ao compartilhar informações pessoais com entidades não autorizadas, o primeiro passo natural é pesquisar todos os SSNs nos armazenamentos de dados da organização. Sob tais circunstâncias, a classificação dos dados torna-se crítica [1]. O sistema de classificação permitirá que as organizações apliquem automaticamente políticas de privacidade e segurança, como habilitação de políticas de controle de acesso e retenção de dados. O Facebook está introduzindo um sistema que construímos no Facebook que usa vários sinais de dados, arquitetura de sistema escalonável e aprendizado de máquina para descobrir tipos de dados semânticos confidenciais.
A descoberta e classificação de dados é o processo de localização e rotulagem de dados para que informações relevantes possam ser recuperadas de forma rápida e eficiente quando necessário. O processo atual é de natureza bastante manual e consiste em examinar as leis ou regulamentos relevantes, determinar quais tipos de informação devem ser considerados sensíveis e quais são os diferentes níveis de sensibilidade e, em seguida, construir classes e políticas de classificação em conformidade [1]. A prevenção contra perda de dados (DLP), em seguida, identifica os dados e monitora os endpoints downstream para obter impressões digitais. Ao lidar com um armazém com muitos ativos e petabytes de dados, essa abordagem simplesmente não é escalável.
Nosso objetivo é construir um sistema de classificação de dados que seja dimensionado para dados de usuário robustos e transitórios, sem quaisquer restrições adicionais sobre o tipo ou formato de dados. Este é um objetivo audacioso e, naturalmente, traz consigo desafios. Um determinado registro de dados pode ter milhares de caracteres.
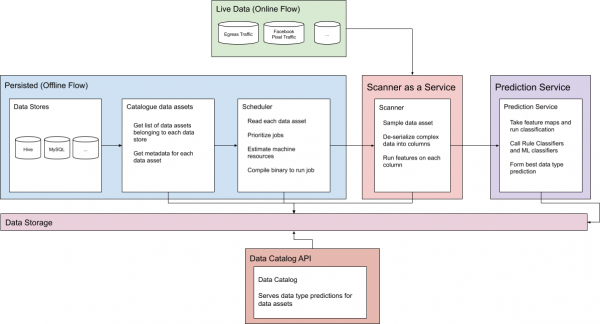
Figura 1. Fluxos de previsão online e offline
Portanto, devemos representá-lo de forma eficiente usando um conjunto comum de características que possam mais tarde ser combinadas e facilmente movidas. Esses recursos não devem apenas fornecer classificação precisa, mas também flexibilidade e extensibilidade para adicionar e descobrir facilmente novos tipos de dados no futuro. Em segundo lugar, você precisa lidar com grandes tabelas offline. Dados duráveis podem ser armazenados em tabelas com muitos petabytes de tamanho. Isso pode resultar em velocidades de digitalização mais lentas. Terceiro, devemos aderir a uma classificação rigorosa de SLA para dados voláteis. Isso força o sistema a ser altamente eficiente, rápido e preciso. Finalmente, devemos fornecer classificação de dados de baixa latência para dados voláteis para realizar a classificação em tempo real, bem como para casos de uso da Internet.
Este artigo descreve como lidamos com os desafios acima e apresenta um sistema de classificação rápido e escalonável que classifica elementos de dados de todos os tipos, formatos e fontes com base em um conjunto comum de recursos. Expandimos a arquitetura do sistema e criamos um modelo personalizado de aprendizado de máquina para classificar rapidamente dados offline e online. Este artigo está organizado da seguinte forma: A Seção 2 apresenta o design geral do sistema. A seção 3 discute as partes de um sistema de aprendizado de máquina. As seções 4 e 5 destacam o trabalho relacionado e delineiam futuras direções de trabalho.
Arquitetura
Para lidar com os desafios dos dados online persistentes e à escala do Facebook, o sistema de classificação tem dois fluxos separados, que discutiremos em detalhe.
Dados Sustentáveis
Inicialmente, o sistema deve aprender sobre os muitos ativos de informação do Facebook. Para cada repositório, algumas informações básicas são coletadas, como o data center que contém esses dados, o sistema que contém esses dados e os ativos localizados no repositório de dados específico. Isso cria um catálogo de metadados que permite ao sistema recuperar dados com eficiência, sem sobrecarregar clientes e recursos usados por outros engenheiros.
Este catálogo de metadados fornece uma fonte confiável para todos os ativos verificados e permite rastrear o status de vários ativos. Usando essas informações, a prioridade de agendamento é estabelecida com base nos dados coletados e nas informações internas do sistema, como a hora em que o ativo foi verificado pela última vez com êxito e a hora em que foi criado, bem como os requisitos anteriores de memória e CPU para esse ativo, se ele já foi digitalizado antes. Então, para cada recurso de dados (à medida que os recursos ficam disponíveis), uma tarefa é chamada para realmente verificar o recurso.
Cada trabalho é um arquivo binário compilado que realiza amostragem de Bernoulli nos dados mais recentes disponíveis para cada ativo. O ativo é dividido em colunas individuais, onde o resultado da classificação de cada coluna é processado de forma independente. Além disso, o sistema verifica quaisquer dados saturados nas colunas. JSON, matrizes, estruturas codificadas, URLs, dados serializados de base 64 e muito mais são verificados. Isso pode aumentar significativamente o tempo de execução da verificação porque uma única tabela pode conter milhares de colunas aninhadas em um blob json.
Para cada linha selecionada no ativo de dados, o sistema de classificação extrai os objetos flutuantes e de texto do conteúdo e associa cada objeto de volta à coluna da qual ele foi obtido. A saída da etapa de extração de recursos é um mapa de todos os recursos de cada coluna encontrada no ativo de dados.
Para que servem os sinais?
O conceito de atributos é fundamental. Em vez de características flutuantes e de texto, podemos passar amostras de strings brutas que são extraídas diretamente de cada recurso de dados. Além disso, os modelos de aprendizado de máquina podem ser treinados diretamente em cada amostra, em vez de centenas de cálculos de recursos que apenas tentam aproximar a amostra. Há várias razões para isso:
- Privacidade em primeiro lugar: Mais importante ainda, o conceito de recursos nos permite armazenar na memória apenas os padrões que recuperamos. Isto garante que armazenamos amostras para uma única finalidade e nunca as registamos através dos nossos próprios esforços. Isto é especialmente importante para dados voláteis, uma vez que o serviço deve manter algum estado de classificação antes de fornecer uma previsão.
- Memória: Algumas amostras podem ter milhares de caracteres. Armazenar esses dados e transmiti-los para partes do sistema consome desnecessariamente muitos bytes adicionais. Os dois fatores podem se combinar ao longo do tempo, visto que existem muitos recursos de dados com milhares de colunas.
- Agregação de recursos: Os recursos representam claramente os resultados de cada verificação por meio de um conjunto de recursos, permitindo ao sistema combinar os resultados de verificações anteriores do mesmo recurso de dados de maneira conveniente. Isso pode ser útil para agregar resultados de varredura de um único recurso de dados em diversas execuções.
Os recursos são então enviados para um serviço de previsão onde usamos classificação baseada em regras e aprendizado de máquina para prever os rótulos de dados de cada coluna. O serviço depende de classificadores de regras e de aprendizado de máquina e seleciona a melhor previsão fornecida de cada objeto de previsão.
Os classificadores de regras são heurísticas manuais, eles usam cálculos e coeficientes para normalizar um objeto para um intervalo de 0 a 100. Uma vez que essa pontuação inicial é gerada para cada tipo de dados e nome de coluna associado a esses dados, ela não é incluída em nenhum "banimento". listas", o classificador de regras seleciona a pontuação normalizada mais alta entre todos os tipos de dados.
Devido à complexidade da classificação, confiar apenas na heurística manual resulta em baixa precisão de classificação, especialmente para dados não estruturados. Por esse motivo, desenvolvemos um sistema de aprendizado de máquina para trabalhar com a classificação de dados não estruturados como conteúdo e endereço do usuário. O aprendizado de máquina tornou possível começar a se afastar da heurística manual e aplicar sinais de dados adicionais (por exemplo, nomes de colunas, proveniência dos dados), melhorando significativamente a precisão da detecção. Iremos nos aprofundar em nossa arquitetura de aprendizado de máquina mais tarde.
O serviço de previsão armazena os resultados de cada coluna junto com metadados relativos ao horário e ao estado da verificação. Quaisquer consumidores e processos downstream que dependam desses dados podem lê-los no conjunto de dados publicado diariamente. Este conjunto agrega os resultados de todos esses trabalhos de verificação ou APIs do Catálogo de Dados em Tempo Real. As previsões publicadas são a base para a aplicação automática das políticas de privacidade e segurança.
Por fim, depois que o serviço de previsão grava todos os dados e todas as previsões são armazenadas, nossa API do Catálogo de Dados pode retornar todas as previsões de tipo de dados para o recurso em tempo real. Todos os dias o sistema publica um conjunto de dados contendo todas as previsões mais recentes para cada ativo.
Dados voláteis
Embora o processo acima seja projetado para ativos persistentes, o tráfego não persistente também é considerado parte dos dados de uma organização e pode ser importante. Por esse motivo, o sistema fornece uma API online para gerar previsões de classificação em tempo real para qualquer tráfego intermitente. O sistema de previsão em tempo real é amplamente utilizado na classificação do tráfego de saída e de entrada em modelos de aprendizado de máquina e dados de anunciantes.
Aqui a API utiliza dois argumentos principais: a chave de agrupamento e os dados brutos que devem ser previstos. O serviço executa a mesma recuperação de objeto descrita acima e agrupa os objetos para a mesma chave. Esses recursos também são suportados no cache de persistência para recuperação de falhas. Para cada chave de agrupamento, o serviço garante que viu amostras suficientes antes de chamar o serviço de predição, seguindo o processo descrito acima.
Otimização
Para verificar alguns armazenamentos, usamos bibliotecas e técnicas para otimizar a leitura do armazenamento quente [2] e garantir que não haja interrupções de outros usuários acessando o mesmo armazenamento.
Para tabelas extremamente grandes (mais de 50 petabytes), apesar de todas as otimizações e eficiência de memória, o sistema trabalha para verificar e computar tudo antes de ficar sem memória. Afinal, a varredura é computada inteiramente na memória e não é armazenada durante a varredura. Se tabelas grandes contiverem milhares de colunas com grupos de dados não estruturados, o trabalho poderá falhar devido a recursos de memória insuficientes ao executar previsões em toda a tabela. Isso resultará em cobertura reduzida. Para combater isso, otimizamos o sistema para usar a velocidade de varredura como um proxy de quão bem o sistema lida com a carga de trabalho atual. Usamos a velocidade como um mecanismo preditivo para ver problemas de memória e calcular preditivamente o mapa de recursos. Ao mesmo tempo, usamos menos dados do que o habitual.
Sinais de dados
Um sistema de classificação é tão bom quanto os sinais dos dados. Aqui veremos todos os sinais usados pelo sistema de classificação.
- Baseado em conteúdo: claro, o primeiro e mais importante sinal é o conteúdo. A amostragem de Bernoulli é realizada em cada ativo de dados que verificamos e extraímos recursos com base no conteúdo dos dados. Muitos sinais vêm do conteúdo. É possível qualquer número de objetos flutuantes, que representam cálculos de quantas vezes um determinado tipo de amostra foi visto. Por exemplo, podemos ter sinais do número de e-mails vistos em uma amostra ou sinais de quantos emojis são vistos em uma amostra. Esses cálculos de recursos podem ser normalizados e agregados em diferentes varreduras.
- Proveniência dos dados: um sinal importante que pode ajudar quando o conteúdo da tabela pai foi alterado. Um exemplo comum são os dados com hash. Quando os dados em uma tabela filho são criptografados, geralmente eles vêm da tabela pai, onde permanecem transparentes. Os dados de linhagem ajudam a classificar certos tipos de dados quando eles não são lidos com clareza ou são convertidos de uma tabela upstream.
- Anotações: Outro sinal de alta qualidade que auxilia na identificação de dados não estruturados. Na verdade, as anotações e os dados de proveniência podem trabalhar juntos para propagar atributos em diferentes ativos de dados. As anotações ajudam a identificar a origem dos dados não estruturados, enquanto os dados de linhagem podem ajudar a rastrear o fluxo desses dados em todo o repositório.
- A injeção de dados é uma técnica em que caracteres especiais e ilegíveis são introduzidos intencionalmente em fontes conhecidas de tipos de dados conhecidos. Então, sempre que digitalizarmos conteúdo com a mesma sequência de caracteres ilegíveis, podemos inferir que o conteúdo vem desse tipo de dados conhecido. Este é outro sinal de dados qualitativos semelhante às anotações. Exceto que a detecção baseada em conteúdo ajuda a descobrir os dados inseridos.
Medindo Métricas
Um componente importante é uma metodologia rigorosa para medir métricas. As principais métricas para a iteração de melhoria de classificação são a precisão e o recall de cada rótulo, sendo a pontuação F2 a mais importante.
Para calcular essas métricas, é necessária uma metodologia independente para rotular os ativos de dados que seja independente do próprio sistema, mas que possa ser usada para comparação direta com ele. Abaixo descrevemos como coletamos informações básicas do Facebook e as usamos para treinar nosso sistema de classificação.
Coleta de dados confiáveis
Acumulamos dados confiáveis de cada fonte listada abaixo em sua própria tabela. Cada tabela é responsável por agregar os últimos valores observados daquela fonte específica. Cada fonte possui verificações de qualidade de dados para garantir que os valores observados para cada fonte sejam de alta qualidade e contenham os rótulos de tipo de dados mais recentes.
- Configurações da plataforma de log: determinados campos nas tabelas hive são preenchidos com dados de um tipo específico. A utilização e divulgação destes dados servem como uma fonte confiável de verdade.
- Rotulagem manual: os desenvolvedores que mantêm o sistema, bem como os rotuladores externos, são treinados para rotular colunas. Isso geralmente funciona bem para todos os tipos de dados no warehouse e pode ser a principal fonte de verdade para alguns dados não estruturados, como dados de mensagens ou conteúdo do usuário.
- As colunas das tabelas pai podem ser marcadas ou anotadas como contendo determinados dados, e podemos rastrear esses dados nas tabelas filhos.
- Buscando threads de execução: threads de execução no Facebook carregam tipos específicos de dados. Usando nossa arquitetura de scanner como serviço, podemos amostrar fluxos que possuem tipos de dados conhecidos e enviá-los através do sistema. O sistema promete não armazenar esses dados.
- Tabelas de amostra: grandes tabelas Hive, que contêm todo o corpus de dados, também podem ser usadas como dados de treinamento e passadas pelo scanner como um serviço. Isso é ótimo para tabelas com uma gama completa de tipos de dados, de modo que a amostragem aleatória de uma coluna seja equivalente à amostragem de todo o conjunto desse tipo de dados.
- Dados sintéticos: podemos até usar bibliotecas que geram dados dinamicamente. Isso funciona bem para tipos de dados públicos simples, como endereço ou GPS.
- Administradores de dados: os programas de privacidade normalmente usam administradores de dados para atribuir políticas manualmente a partes de dados. Isso serve como uma fonte de verdade altamente precisa.
Combinamos todas as principais fontes de verdade em um corpus com todos esses dados. O maior desafio da validade é garantir que ela seja representativa do repositório de dados. Caso contrário, os motores de classificação poderão sofrer overtraining. Para combater isso, todas as fontes acima são utilizadas para garantir o equilíbrio ao treinar modelos ou calcular métricas. Além disso, os rotuladores humanos coletam amostras uniformemente de diferentes colunas no repositório e rotulam os dados de acordo, para que a coleta da verdade básica permaneça imparcial.
Integração contínua
Para garantir iteração e melhoria rápidas, é importante sempre medir o desempenho do sistema em tempo real. Podemos medir cada melhoria de classificação em relação ao sistema hoje, para que possamos orientar taticamente melhorias futuras com base em dados. Aqui veremos como o sistema completa o ciclo de feedback fornecido por dados válidos.
Quando o sistema de agendamento encontra um ativo que possui um rótulo de uma fonte confiável, agendamos duas tarefas. O primeiro utiliza nosso scanner de produção e, portanto, nossos recursos de produção. A segunda tarefa usa o scanner de compilação mais recente com os recursos mais recentes. Cada tarefa grava sua saída em sua própria tabela, marcando versões junto com os resultados da classificação.
É assim que comparamos os resultados da classificação do release candidate e do modelo de produção em tempo real.
Embora os conjuntos de dados comparem os recursos RC e PROD, muitas variações do mecanismo de classificação ML do serviço de previsão são registradas. O modelo de aprendizado de máquina construído mais recentemente, o modelo atual em produção e quaisquer modelos experimentais. A mesma abordagem nos permite “fatiar” diferentes versões do modelo (independentemente de nossos classificadores de regras) e comparar métricas em tempo real. Isso facilita determinar quando um experimento de ML está pronto para entrar em produção.
Todas as noites, os recursos RC calculados para aquele dia são enviados para o pipeline de treinamento de ML, onde o modelo é treinado nos recursos RC mais recentes e avalia seu desempenho em relação ao conjunto de dados reais.
Todas as manhãs, o modelo conclui o treinamento e é publicado automaticamente como modelo experimental. Ele é automaticamente incluído na lista experimental.
Alguns resultados
Mais de 100 tipos diferentes de dados são rotulados com alta precisão. Tipos bem estruturados, como e-mails e números de telefone, são classificados com pontuação f2 superior a 0,95. Tipos de dados gratuitos, como conteúdo e nome gerados pelo usuário, também apresentam desempenho muito bom, com pontuações F2 superiores a 0,85.
Um grande número de colunas individuais de dados persistentes e voláteis são classificados diariamente em todos os repositórios. Mais de 500 terabytes são verificados diariamente em mais de 10 data warehouses. A maioria desses repositórios tem cobertura superior a 98%.
Com o tempo, a classificação tornou-se muito eficiente, com trabalhos de classificação em um fluxo off-line persistente levando em média 35 segundos desde a verificação de um ativo até o cálculo das previsões para cada coluna.
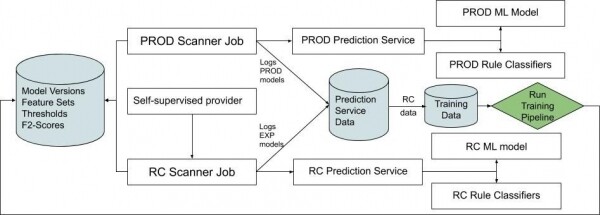
Arroz. 2. Diagrama descrevendo o fluxo de integração contínua para entender como os objetos RC são gerados e enviados ao modelo.
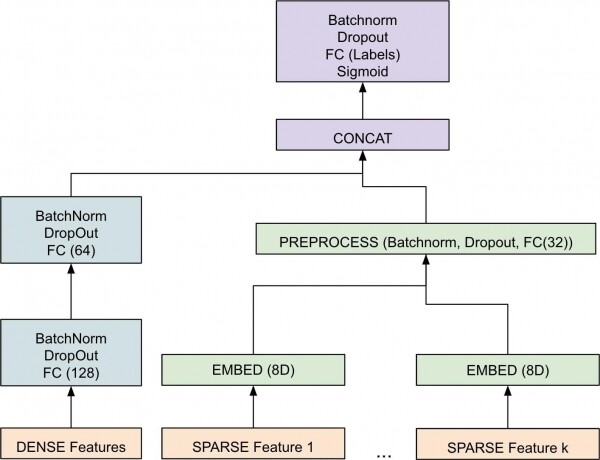
Figura 3. Diagrama de alto nível de um componente de aprendizado de máquina.
Componente do sistema de aprendizado de máquina
Na seção anterior, nos aprofundamos na arquitetura geral do sistema, destacando escala, otimização e fluxos de dados offline e online. Nesta seção, veremos o serviço de previsão e descreveremos o sistema de aprendizado de máquina que alimenta o serviço de previsão.
Com mais de 100 tipos de dados e algum conteúdo não estruturado, como dados de mensagens e conteúdo do usuário, o uso de heurística puramente manual resulta em precisão de classificação subparamétrica, especialmente para dados não estruturados. Por esse motivo, também desenvolvemos um sistema de aprendizado de máquina para lidar com as complexidades dos dados não estruturados. O uso do aprendizado de máquina permite que você comece a se afastar da heurística manual e trabalhe com recursos e sinais de dados adicionais (por exemplo, nomes de colunas, origem dos dados) para melhorar a precisão.
O modelo implementado estuda representações vetoriais [3] sobre objetos densos e esparsos separadamente. Eles são então combinados para formar um vetor, que passa por uma série de etapas de normalização em lote [4] e de não linearidade para produzir o resultado final. O resultado final é um número de ponto flutuante entre [0-1] para cada rótulo, indicando a probabilidade de o exemplo pertencer a esse tipo de sensibilidade. Usar o PyTorch para o modelo nos permitiu avançar mais rápido, permitindo que desenvolvedores fora da equipe fizessem e testassem alterações rapidamente.
Ao projetar a arquitetura, foi importante modelar objetos esparsos (por exemplo, texto) e densos (por exemplo, numéricos) separadamente devido às suas diferenças inerentes. Para a arquitetura final, também foi importante realizar uma varredura de parâmetros para encontrar o valor ideal para taxa de aprendizagem, tamanho do lote e outros hiperparâmetros. A escolha do otimizador também foi um hiperparâmetro importante. Descobrimos que um otimizador popular Adam muitas vezes leva ao overfitting, enquanto um modelo com SGD mais estável. Houve nuances adicionais que tivemos que incluir diretamente no modelo. Por exemplo, regras estáticas que garantiram que o modelo fizesse uma previsão determinística quando um recurso tivesse um determinado valor. Essas regras estáticas são definidas pelos nossos clientes. Descobrimos que incorporá-los diretamente no modelo resultou em uma arquitetura mais independente e robusta, em vez de implementar uma etapa de pós-processamento para lidar com esses casos extremos especiais. Observe também que essas regras são desativadas durante o treinamento para não interferir no processo de treinamento da descida gradiente.
Problemas
Um dos desafios foi coletar dados confiáveis e de alta qualidade. O modelo precisa de confiança para cada classe para que possa aprender associações entre objetos e rótulos. Na seção anterior, discutimos métodos de coleta de dados para medição de sistema e treinamento de modelo. A análise mostrou que classes de dados como números de cartões de crédito e contas bancárias não são muito comuns em nosso armazém. Isso dificulta a coleta de grandes quantidades de dados confiáveis para treinar modelos. Para resolver esse problema, desenvolvemos processos para obter dados sintéticos de verdade para essas classes. Geramos esses dados para tipos confidenciais, incluindo SSN, números de cartão de crédito и IBAN-números para os quais o modelo não poderia prever anteriormente. Essa abordagem permite que tipos de dados confidenciais sejam processados sem os riscos de privacidade associados à ocultação dos dados confidenciais reais.
Além das questões de verdade, há questões arquitetônicas abertas nas quais estamos trabalhando, como mudar isolamento и parada antecipada. O isolamento de alterações é importante para garantir que, quando diferentes alterações são feitas em diferentes partes da rede, o impacto seja isolado em classes específicas e não tenha um impacto amplo no desempenho geral da previsão. Melhorar os critérios de paragem precoce também é fundamental para que possamos parar o processo de treino num ponto estável para todas as classes, em vez de num ponto em que algumas classes treinam em excesso e outras não.
Importância do recurso
Quando um novo recurso é introduzido em um modelo, queremos saber seu impacto geral no modelo. Também queremos ter certeza de que as previsões sejam interpretáveis por humanos, para que possamos entender exatamente quais recursos estão sendo usados para cada tipo de dados. Para isso desenvolvemos e introduzimos por classe importância dos recursos para o modelo PyTorch. Observe que isso é diferente da importância geral do recurso, que geralmente é suportada, porque não nos informa quais recursos são importantes para uma classe específica. Medimos a importância de um objeto calculando o aumento no erro de previsão após reorganizar o objeto. Um recurso é “importante” quando a troca de valores aumenta o erro do modelo porque neste caso o modelo estava contando com o recurso para fazer sua previsão. Um recurso é “sem importância” quando embaralhar seus valores deixa o erro do modelo inalterado, pois neste caso o modelo o ignorou [5].
A importância do recurso para cada classe nos permite tornar o modelo interpretável para que possamos ver o que o modelo está observando ao prever um rótulo. Por exemplo, quando analisamos ENDEREÇO, então garantimos que o sinal associado ao endereço, como Contagem de Linhas de Endereço, tem uma classificação elevada na tabela de importância de recursos para cada classe, para que nossa intuição humana corresponda bem ao que o modelo aprendeu.
Avaliação
É importante definir uma única métrica para o sucesso. Nós escolhemos F2 - equilíbrio entre recordação e precisão (o viés de recordação é um pouco maior). A recuperação é mais importante para um caso de uso de privacidade do que a precisão, porque é fundamental para a equipe não perder nenhum dado confidencial (garantindo ao mesmo tempo uma precisão razoável). A avaliação real do desempenho F2 do nosso modelo está além do escopo deste artigo. No entanto, com um ajuste cuidadoso, podemos alcançar pontuações F0,9 altas (2+) para as classes sensíveis mais importantes.
Trabalho relatado
Existem muitos algoritmos para classificação automática de documentos não estruturados usando vários métodos, como correspondência de padrões, pesquisa de similaridade de documentos e vários métodos de aprendizado de máquina (Bayesiano, árvores de decisão, k-vizinhos mais próximos e muitos outros) [6]. Qualquer um deles pode ser usado como parte de uma classificação. No entanto, o problema é a escalabilidade. A abordagem de classificação neste artigo é voltada para flexibilidade e desempenho. Isso nos permite oferecer suporte a novas classes no futuro e manter a latência baixa.
Existe também uma vasta gama de trabalhos sobre a identificação de dados. Por exemplo, os autores em [7] descreveram uma solução que se concentra no problema de detecção de vazamentos de dados confidenciais. A premissa subjacente é que os dados podem ser identificados e comparados a um conjunto de dados confidenciais conhecidos. Os autores em [8] descrevem um problema semelhante de vazamento de privacidade, mas a solução deles é baseada em uma arquitetura específica. Android e só é classificada se as ações do usuário resultarem na transmissão de informações pessoais ou se o aplicativo subjacente vazar dados do usuário. A situação aqui é um pouco diferente, pois os dados do usuário também podem ser altamente não estruturados. Portanto, precisamos de uma técnica mais sofisticada do que a coleta de impressões digitais.
Finalmente, para fazer face à escassez de dados relativos a alguns tipos de dados sensíveis, introduzimos dados sintéticos. Há uma grande literatura sobre aumento de dados, por exemplo, os autores em [9] exploraram o papel da injeção de ruído durante o treinamento e observaram resultados positivos na aprendizagem supervisionada. Nossa abordagem à privacidade é diferente porque a introdução de dados ruidosos pode ser contraproducente e, em vez disso, nos concentramos em dados sintéticos de alta qualidade.
Conclusão
Neste artigo, apresentamos um sistema que pode classificar um dado. Isso nos permite criar sistemas para aplicar políticas de privacidade e segurança. Mostrámos que a infraestrutura escalável, a integração contínua, a aprendizagem automática e a garantia de dados de alta qualidade desempenham um papel fundamental no sucesso de muitas das nossas iniciativas de privacidade.
Existem muitas direções para trabalhos futuros. Isso pode incluir o fornecimento de suporte para dados (arquivos) não esquematizados, a classificação não apenas do tipo de dados, mas também do nível de sensibilidade e o uso de aprendizagem auto-supervisionada durante o treinamento, gerando exemplos sintéticos precisos. O que, por sua vez, ajudará o modelo a reduzir ao máximo as perdas. O trabalho futuro também poderia se concentrar no fluxo de trabalho de investigação, onde vamos além da detecção e fornecemos análises de causa raiz de diversas violações de privacidade. Isso ajudará em casos como análise de sensibilidade (ou seja, se a sensibilidade à privacidade de um tipo de dados é alta (por exemplo, IP do usuário) ou baixa (por exemplo, IP interno do Facebook)).
Bibliografia
- David Ben-David, Tamar Domany e Abigail Tarem. Classificação de dados corporativos usando tecnologias da web semântica. Em Peter F.Ï Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks e Birte Glimm, editores, A Web Semântica – ISWC 2010, páginas 66–81, Berlim, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang e Sanjeev Kumar. f4: sistema de armazenamento BLOB quente do Facebook. Em 11º Simpósio USENIX sobre Design e Implementação de Sistemas Operacionais (OSDI 14), páginas 383–398, Broomfield, CO, outubro de 2014. Associação USENIX.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado e Jeff Dean. Representações distribuídas de palavras e frases e sua composicionalidade. Em CJC Burges, L. Bottou, M. Welling, Z. Ghahramani e KQ Weinberger, editores, Avanços em Sistemas de Processamento de Informação Neural 26, páginas 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe e Christian Szegedy. Normalização em lote: Acelerando o treinamento profundo da rede, reduzindo a mudança interna de covariáveis. Em Francis Bach e David Blei, editores, Anais da 32ª Conferência Internacional sobre Aprendizado de Máquina, volume 37 de Procedimentos de pesquisa de aprendizado de máquina, páginas 448–456, Lille, França, 07–09 de julho de 2015. PMLR.
- Léo Breiman. Florestas aleatórias. Mach. Aprender., 45(1):5–32, outubro de 2001.
- Thair Nu Phyu. Levantamento de técnicas de classificação em mineração de dados.
- X. Shu, D. Yao e E. Bertino. Detecção que preserva a privacidade da exposição de dados confidenciais. Transações do IEEE em perícia e segurança da informação, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning e Xiaoyang Wang. Objetivo: Analisando a transmissão de dados confidenciais no Android para detecção de vazamento de privacidade. páginas 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong e Quoc V. Le. Aumento de dados não supervisionado.
Descubra detalhes sobre como conseguir uma profissão procurada do zero ou subir de nível em termos de habilidades e salário fazendo os cursos online SkillFactory:
- (12 meses)
- (12 semanas)
- (20 semanas)
- (20 semanas)
Mais cursos
- (9 meses)
- (8 meses)
- (9 meses)
- (12 meses)
- (18 meses)
- (12 meses)
- (9 meses)
- (7 meses)
Fonte: habr.com
