

Probabil că nu este un secret pentru nimeni că anul trecut a fost un an de mari schimbări pentru Apache Hadoop. Anul trecut a avut loc fuziunea Cloudera și Hortonworks (de fapt, achiziția celui din urmă), iar MapR, din cauza unor probleme financiare serioase, a fost vândut Hewlett Packard. Și dacă acum câțiva ani, în cazul instalărilor on-premises, alegerea se făcea adesea între Cloudera și Hortonworks, astăzi, din păcate, nu mai avem această opțiune. O surpriză a fost și faptul că Cloudera a anunțat în februarie acestui an încetarea emiterii de versiuni binare ale distribuției sale în depozitul public, iar acum acestea sunt disponibile doar pe baza unui abonament plătit. Desigur, este în continuare posibil să descărcăm ultimele versiuni CDH și HDP, lansate până la sfârșitul anului 2019, iar suportul pentru acestea este prevăzut pentru un interval de un an sau două. Dar ce să facem mai departe? Pentru cei care au plătit anterior pentru un abonament, nimic nu s-a schimbat. Iar pentru cei care nu doresc să treacă la versiunea plătită a distribuției, dar doresc să aibă posibilitatea de a primi versiuni recente ale componentelor clusterului, precum și patch-uri și alte actualizări, am pregătit acest articol. În el, vom analiza opțiunile posibile pentru a ieși din situația actuală.
Articolul este mai mult unul de tip revistă. Nu va exista o comparație a distribuțiilor și o analiză detaliată a acestora, nici rețete pentru instalarea și configurarea lor. Atunci, ce va fi? Vom discuta pe scurt despre o distribuție numită Arenadata Hadoop, care merită atenția noastră datorită accesibilității sale, ceea ce, în zilele noastre, este o raritate. Apoi, vom vorbi despre Vanilla Hadoop, în principal despre cum îl putem "găti" cu ajutorul Apache Bigtop. Sunteți gata? Atunci bun venit!
Arenadata Hadoop
Aceasta este o distribuție complet nouă și, deocamdată, puțin cunoscută, de dezvoltare internă. Din păcate, în prezent, pe Habr, există foarte puține informații despre ea. .
Informații mai detaliate pot fi găsite pe site-ul oficial al proiectului. Cele mai recente versiuni ale distribuției se bazează pe Hadoop 3.1.2 pentru versiunea 3 și 2.8.5 pentru versiunea 2.
Informații despre roadmap pot fi găsite .
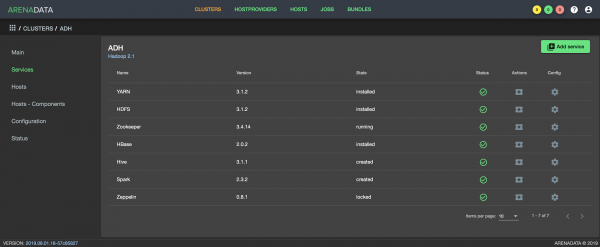
Interfața Arenadata Cluster Manager
Produsul cheie al Arenadata este , care este utilizat pentru instalarea, configurarea și monitorizarea diferitelor soluții software ale companiei. ADCM este distribuit gratuit, iar funcționalitatea sa este extinsă prin adăugarea de bundle-uri, care reprezintă un set de ansible-playbooks. Bundle-urile se împart în două tipuri: enterprise și community. Ultimele sunt disponibile pentru descărcare gratuită de pe site-ul Arenadata. De asemenea, există posibilitatea de a dezvolta propriul bundle și de a-l conecta la ADCM.
Pentru deployment și managementul Hadoop 3, este disponibilă versiunea community a bundle-ului împreună cu ADCM, iar pentru Hadoop 2 există doar ca alternativă. În ceea ce privește repository-urile de pachete, acestea sunt deschise pentru acces public, pot fi descărcate și instalate în mod obișnuit pentru toate componentele cluster-ului. În general, distribuția arată destul de interesant. Sunt sigur că există cei care sunt obișnuiți cu soluții precum Cloudera Manager și Ambari și că ADCM le va plăcea. Pentru unii, un mare plus va fi și faptul că distribuția pentru substituția importurilor.
Dacă discutăm despre dezavantaje, acestea vor fi aceleași ca și pentru toate celelalte distribuții Hadoop. Adică:
- Așa-numitul „vendor lock-in”. Pe exemplul Cloudera și Hortonworks, am înțeles deja că există întotdeauna riscul de modificare a politicii companiei.
- Întârziere semnificativă față de upstream-ul Apache.
Vanilla Hadoop
Așa cum știți, Hadoop nu este un produs monolitic, ci, în esență, o întreagă paletă de servicii în jurul sistemului său de fișiere distribuite HDFS. Puțini vor fi mulțumiți de un singur cluster de fișiere. Unii au nevoie de Hive, alții de Presto, și mai există HBase și Phoenix, iar Spark este din ce în ce mai folosit. Pentru orchestrarea și încărcarea datelor se întâlnesc uneori Oozie, Sqoop și Flume. Iar dacă trebuie să ne ocupăm de securitate, ne amintim imediat de Kerberos în legătură cu Ranger.
Versiunile binare ale componentelor Hadoop sunt disponibile pe site-ul fiecărui proiect din ecosistem sub formă de tarballs. Acestea pot fi descărcate și instalate, dar cu o condiție: pe lângă construirea pachetelor din binarii „neprelucrate”, pe care cel mai probabil veți dori să o faceți, nu veți avea nicio siguranță privind compatibilitatea versiunilor componentelor descărcate între ele. O variantă mai preferabilă este construcția cu ajutorul Apache Bigtop. Bigtop va permite construirea din repositoare maven Apache, rularea testelor și crearea pachetelor. Dar, ceea ce este foarte important pentru noi, Bigtop va construi versiunile componentelor care vor fi compatibile între ele. Despre aceasta vom vorbi mai în detaliu mai departe.
Apache Bigtop
Apache Bigtop este un instrument pentru construcția, ambalarea și testarea mai multor
proiecte open source, cum ar fi Hadoop și Greenplum. Bigtop are numeroase
versiuni. La momentul redactării acestui articol, ultima versiune stabilă era 1.4,
iar în master se afla 1.5. În diferitele versiuni ale lansărilor se utilizează versiuni diferite
ale componentelor. De exemplu, pentru 1.4 componentele de bază Hadoop au versiunea 2.8.5, iar în master
2.10.0. Se schimbă și compunerea componentelor suportate. Ceea ce este vechi și
neactualizat dispare, iar în locul său apare ceva nou, mai solicitat, și
nu este neapărat ceva din familia Apache.
În plus, Bigtop are numeroase .
Când am început să ne familiarizăm cu Bigtop, ne-a surprins în primul rând popularitatea sa modestă, în comparație cu celelalte proiecte Apache, și comunitatea sa destul de mică. Din aceasta decurge faptul că informațiile despre produs sunt minime, iar căutarea soluțiilor pentru problemele apărute pe forumuri și mailing liste poate să nu ofere deloc rezultate. La început, a fost o provocare să realizăm o construcție completă a distribuției din cauza particularităților instrumentului, dar despre asta vom vorbi puțin mai târziu.
Ca un teaser — celor care în trecut au fost atrași de proiecte din universul Linux, cum ar fi Gentoo și LFS, le-ar putea părea nostalgicamente plăcut să lucreze cu acest lucru și să-și amintească vremurile „legendare” când noi căutam (sau chiar scriam) ebuild-uri și recompilam regulat cu patch-uri noi Mozilla.
Un mare atu al Bigtop este deschiderea și versatilitatea instrumentelor pe care se bazează. La baza sa se află Gradle și Apache Maven. Gradle este cunoscut ca un instrument folosit de Google pentru a compila aplicații Android. Este flexibil și, cum se spune, „testat în luptă”. Maven este instrumentul standard pentru compilarea proiectelor în cadrul Apache, iar, având în vedere că majoritatea produselor sale sunt lansate prin Maven, acesta joacă un rol esențial. Merită să ne concentrăm asupra POM (modelul de obiect al proiectului) – un fișier xml „fundamental” care descrie tot ce este necesar pentru ca Maven să funcționeze cu proiectul dumneavoastră, în jurul căruia se desfășoară toată activitatea. Anume în
parte a Maven se întâlnesc unele obstacole cu care se confruntă de obicei cei care se apucă pentru prima dată de Bigtop.
Practică
Așadar, cu ce ar trebui să începem? Mergem pe pagina de descărcare și descărcăm ultima versiune stabilă sub formă de arhivă. Acolo putem găsi și artefactele binare compilate de Bigtop. Apropo, dintre gestionarii de pachete obișnuiți, sunt acceptați YUM și APT.
O alternativă este să descărcați ultima versiune stabilă direct de pe
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitClonare în „bigtop”…
remote: Enumerating objects: 46, done.
remote: Counting objects: 100% (46/46), done.
remote: Compressing objects: 100% (41/41), done.
remote: Total 40217 (delta 14), reused 10 (delta 1), pack-reused 40171
Obținerea obiectelor: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, complet.
Determinarea modificărilor: 100% (20503/20503), complet.
Actualizarea fișierelor: 100% (1998/1998), complet.
Arată astfel directorul rezultat ./$bigtop:
./bigtop-bigpetstore — aplicații demo, exemple sintetice
./bigtop-ci — instrumente CI, jenkins
./bigtop-data-generators — generare de date, sintetic, pentru teste de tip smoke etc.
./bigtop-deploy — instrumente pentru deploy
./bigtop-packages — configurații, scripturi, patch-uri pentru compilare, partea principală a instrumentului
./bigtop-test-framework — cadru de testare
./bigtop-tests — testele în sine, de stres și smoke
./bigtop_toolchain — mediu de compilare, pregătirea mediului pentru funcționarea instrumentului
./build — directorul de lucru pentru compilare
./dl — directorul pentru sursele descărcate
./docker — compilare în imagini docker, testare
./gradle — configurație gradle
./output – directorul în care ajung artefactele de compilare
./provisioner — provisioning
Cel mai interesant aspect pentru noi în acest moment este configurația principală ./bigtop/bigtop.bom, în care vedem toate componentele suportate cu versiunile lor. Aici putem specifica o altă versiune a produsului (dacă dorim să încercăm să o compilăm) sau versiunea compilei (dacă, de exemplu, am adăugat un patch semnificativ).
De asemenea, un mare interes este generat de subdirectorul .\/bigtop\/bigtop-packages, care are legătură directă cu procesul de compilare a componentelor și pachetelor acestora.
Așadar, am descărcat arhiva, am dezarhivat-o sau am făcut un clon de pe github, putem începe compilarea?
Nu, înainte trebuie să ne pregătim mediul.
Pregătirea mediului
Și aici va fi nevoie de o mică digresiune. Pentru a compila aproape orice produs mai mult sau mai puțin complex, este necesar un mediu specific — în cazul nostru, acesta este JDK, aceleași biblioteci partajate, fișiere header etc., unelte, de exemplu, ant, ivy2 și multe altele. Una dintre opțiunile de a obține mediul necesar pentru Bigtop este instalarea componentelor necesare pe gazda de compilare. S-ar putea să greșesc în cronologie, dar, pare-se, cu versiunea 1.0 a apărut și opțiunea de compilare în imagini docker preconfigurate și disponibile, cu care se pot familiariza aici.
În ceea ce privește pregătirea mediului, există un asistent pentru aceasta — Puppet.
Se pot folosi următoarele comenzi, rularea se face din directorul rădăcină
al instrumentului, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Sau direct prin puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"Din păcate, deja în această etapă pot apărea dificultăți. Sfaturile generale aici sunt – folosiți o distribuție suportată, în stare actualizată pe gazda de compilare sau încercați drumul cu docker.
Compilare
Ce putem încerca să compilăm? Răspunsul la această întrebare ne va oferi output-ul comenzii
.\/gradlew tasks În secțiunea Package tasks există o serie de produse care reprezintă artefactele finale ale Bigtop.
Acestea pot fi identificate după sufixul -rpm sau -pkg-ind (în cazul compilării
în docker). În cazul nostru, cel mai interesant este Hadoop.
Să încercăm să efectuăm compilarea în mediul serverului nostru de build:
.\/gradlew hadoop-rpmBigtop va descărca singur sursele necesare, necesare pentru componenta specifică, și va începe compilarea. Astfel, funcționarea instrumentului este legată de repozitoarele Maven și alte surse, ceea ce înseamnă că are nevoie de acces la Internet.
În timpul lucrului se generează o ieșire standard. Uneori, pe baza acesteia și a mesajelor de eroare, se poate înțelege ce a mers prost. Alteori, este necesară obținerea de informații suplimentare. În acest caz, ar trebui adăugate argumente --info sau --debug, de asemenea, poate fi util –stacktrace. Există o modalitate convenabilă de a forma un set de date pentru o ulterioare apeluri în listele de distribuție, cheia --scan.
Cu ajutorul acestuia, bigtop va aduna toate informațiile și le va expune în gradle, după care va oferi un link,
prin care o persoană competentă va putea înțelege de ce compilarea a eșuat.
Trebuie avut în vedere că această opțiune poate face publice informații nedorite pentru tine, cum ar fi numele utilizatorilor, nodurilor, variabile de mediu etc., așa că fii atent.
Adesea, erorile sunt rezultatul imposibilității de a obține anumite componente necesare pentru compilare. De obicei, problema poate fi rezolvată prin crearea unui patch pentru a corecta ceva în sursă, de exemplu, adresa în pom.xml din directorul rădăcină al surselor. Aceasta se face prin crearea și plasarea acestuia în directorul corespunzător .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ patch, de exemplu, sub forma patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@


central
- http:\/\/repo1.maven.org\/maven2
+ https:\/\/repo1.maven.org\/maven2

false
Cel mai probabil, la momentul redactării acestui articol, corectura menționată mai sus nu va trebui să o faci singur.
Atunci când implementezi orice patch-uri și modificări în mecanismul de compilare, s-ar putea să fie necesară "resetarea" compilării folosind comanda de curățare:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Această operație va anula toate modificările realizate asupra compilării acestui component, după care compilarea se va efectua din nou. De data aceasta, vom încerca să compilăm proiectul într-un container docker:
./gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Task :hadoop-pkg-ind
Se construiește 1.2.1 hadoop-pkg pe centos-7 în Docker...
+++ dirname ./bigtop-ci/build.sh
++ cd ./bigtop-ci/..
++ pwd
+ BIGTOP_HOME=/tmp/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop/slaves:1.2.1-centos-7 /sbin/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
multă ieșire
....
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-secondarynamenode-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-journalnode-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-resourcemanager-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-nodemanager-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-proxyserver-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-timelineserver-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-historyserver-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-client-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Scris: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd /bigtop/build/hadoop/rpm//BUILD
+ cd hadoop-2.8.5-src
+ /usr/bin/rm -rf /bigtop/build/hadoop/rpm/BUILDROOT/hadoop-2.8.5-1.el7.x86_64
Executare(%clean): /bin/sh -e /var/tmp/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Executare(--clean): /bin/sh -e /var/tmp/rpm-tmp.CwDb22
+ cd /bigtop/build/hadoop/rpm//BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Creare /bigtop/build/hadoop/.rpm
:hadoop-rpm (Thread[Task worker for ':',5,main]) finalizat. A durat 38 min 1.151 secs.
:hadoop-pkg (Thread[Task worker for ':',5,main]) a început.
> Task :hadoop-pkg
Task ':hadoop-pkg' nu este actualizat pentru că:
Task nu a declarat nici o ieșire în ciuda executării acțiunilor.
:hadoop-pkg (Thread[Task worker for ':',5,main]) finalizat. A durat 0.0 secs.
BUILD FINALIZAT CU SUCCES în 40m 37s
6 sarcini acționabile: 6 executate
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Eroare: Nu există un astfel de container:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD FINALIZAT CU SUCCES în 41m 24s
1 sarcină acționabilă: 1 executată
Compunerea s-a realizat sub CentOS, dar poate fi efectuată și sub Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indPe lângă compilarea pachetelor pentru diferite distribuții Linux, instrumentul poate genera un repository cu pachetele compilate, de exemplu:
.\/gradlew yumDe asemenea, putem menționa testele smoke și desfășurarea în docker.
Creează un cluster din trei noduri:
.\/gradlew -Pnum_instances=3 docker-provisionerRularea testelor smoke în clusterul din trei noduri:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerȘterge clusterul:
.\/gradlew docker-provisioner-destroyObține comenzile pentru conectarea în interiorul containerelor docker:
.\/gradlew docker-provisioner-sshAfișează starea:
.\/gradlew docker-provisioner-statusDespre sarcinile de desfășurare se poate citi mai în detaliu în documentație.
În ceea ce privește testele, există un număr destul de mare, în principal teste smoke și de integrare. Analizarea lor este în afara domeniului acestui articol. Voi spune doar că compilarea distribuției nu este o sarcină atât de complicată cum ar putea părea la prima vedere. Toate componentele pe care le folosim în producție au fost compilate și au trecut testele, iar noi nu am avut probleme cu desfășurarea și executarea operațiunilor de bază în mediu de testare.
În plus față de componentele existente în Bigtop, există posibilitatea de a adăuga și alte elemente, chiar și dezvoltări software proprii. Toate acestea sunt perfect automatizate și se încadrează în conceptul CI/CD.
Concluzie
Este evident că distribuția compilată în acest mod nu trebuie trimisă imediat în producție. Trebuie să înțelegem că, dacă există o nevoie reală pentru compilarea și întreținerea propriei distribuții, este necesar să investim atât financiar, cât și în timp.
Cu toate acestea, în combinație cu o abordare corectă și o echipă profesionistă, este complet posibil să ne descurcăm fără soluții comerciale.
Este important de menționat că proiectul Bigtop are nevoie de dezvoltare și, se pare, că în prezent nu există dezvoltări active în el. De asemenea, perspectiva apariției Hadoop 3 rămâne neclară. Apropo, dacă aveți o nevoie reală de compilare Hadoop 3, puteți lua în considerare de la Arenadata, care, pe lângă componentele standard, include și o serie întreagă de suplimente (Ranger, Knox, NiFi).
În ceea ce privește Rostelecom, pentru noi, Bigtop este una dintre opțiunile evaluate în prezent. Rămâne de văzut dacă ne vom concentra pe acesta sau nu.
Appendix
Appendix
Pentru a adăuga un nou component în construcție, trebuie să adăugați descrierea sa în bigtop.bom și .\/bigtop-packages. Puteți încerca să faceți acest lucru prin analogie cu componentele existente. Încercați să înțelegeți. Nu este atât de complicat cum pare la prima vedere.
Ce părere aveți? Ne-ar face plăcere să vedem opiniile dumneavoastră în comentarii și vă mulțumim pentru atenție!
Articolul a fost pregătit de echipa de management al datelor de la «Rostelecom»
Sursa: habr.com
