

Salut, comunitate. Așa cum am menționat, în această lună OTUS lansează două cursuri despre învățarea automată, și anume și . În acest context, continuăm să împărtășim materiale utile.
Scopul acestui articol este de a povesti despre prima noastră experiență cu .
Vom începe cu recenzia serverului său de tracking și vom loga toate iterațiile cercetării. Apoi, vom împărtăși experiența conectării Spark cu MLflow prin UDF.
Context
Noi, la folosește învățarea automată și inteligența artificială pentru a permite oamenilor să aibă grijă de sănătatea și bunăstarea lor. De aceea, modelele de învățare automată sunt fundamentul produselor noastre de procesare a datelor, și de aceea ne-a atras atenția MLflow - o platformă open source care acoperă toate aspectele ciclului de viață al învățării automate.
MLflow
Scopul principal al MLflow este de a oferi un strat suplimentar deasupra învățării automate, care să permită specialiștilor în data science să lucreze practic cu orice bibliotecă de învățare automată (, , , , și ), ridicându-i performanța la un nou nivel.
MLflow oferă trei componente:
- Tracking – înregistrarea și interogarea experimentelor: cod, date, configurație și rezultate. Monitorizarea procesului de creare a modelului este foarte importantă.
- Projects – format de pachet pentru a fi rulat pe orice platformă (de exemplu, )
- Models – format comun pentru livrarea modelelor în diverse instrumente de implementare.
MLflow (în momentul scrierii acestui articol în versiune alpha) - este o platformă open source care permite gestionarea ciclului de viață al învățării automate, inclusiv experimentele, reutilizarea și implementarea.
Configurația MLflow
Pentru a folosi MLflow, trebuie mai întâi să configurăm întreaga mediu Python, pentru care vom folosi (pentru a instala Python pe Mac, verificați ). Astfel, vom putea crea un mediu virtual în care vom instala toate bibliotecile necesare pentru rulare.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Folosește Python 3.7
mkvirtualenv mlflow # Creează un mediu virtual cu Python 3.7
workon mlflow
```
Vom instala bibliotecile necesare.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Notă: folosim PyArrow pentru a rula modele precum UDF. Versiunile PyArrow și Numpy au trebuit să fie ajustate, deoarece ultimele versiuni aveau conflicte între ele.
Începem Tracking UI
MLflow Tracking ne permite să logăm și să interogăm experimentele prin Python și API-ul. În plus, putem defini unde să stocăm artefactele modelului (localhost, , , sau ). Având în vedere că în Alpha Health folosim AWS, S3 va fi folosit ca și spațiu de stocare a artefactelor.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow recomandă utilizarea unei stocări de fișiere permanente. Stocarea fișierelor este locul unde serverul va salva metadatele lansărilor și experimentelor. Atunci când lansați serverul, asigurați-vă că acesta indică către o stocare de fișiere permanentă. Aici, pentru experiment, vom folosi doar /tmp.
Rețineți că, dacă dorim să folosim serverul mlflow pentru a rula experimente vechi, acestea trebuie să fie prezente în stocarea de fișiere. Totuși, chiar și fără asta, am putea să le utilizăm în UDF, deoarece avem nevoie doar de calea către model.
Notă: Aveți în vedere că Tracking UI și clientul modelului trebuie să aibă acces la locația artefactului. Cu alte cuvinte, indiferent de faptul că Tracking UI se află pe un exemplu EC2, la lansarea locală a MLflow, mașina trebuie să aibă acces direct la S3 pentru a înregistra modele artefacte.
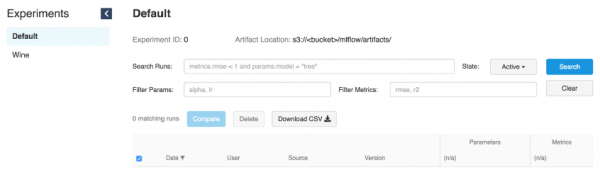
Tracking UI stochează artefactele într-un bucket S3
Lansarea modelelor
Odată ce serverul Tracking funcționează, putem începe să antrenăm modelele.
Ca exemplu, vom folosi modificarea wine din exemplul MLflow în .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Așa cum am spus deja, MLflow permite logarea parametrilor, metricilor și artefactelor modelelor, astfel încât să putem urmări cum se dezvoltă pe parcursul iterațiilor. Această funcție este extrem de utilă, deoarece ne permite să reproducem cel mai bun model, accesând serverul Tracking sau înțelegând ce cod a executat iterația dorită, folosind logurile git hash ale commit-urilor.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 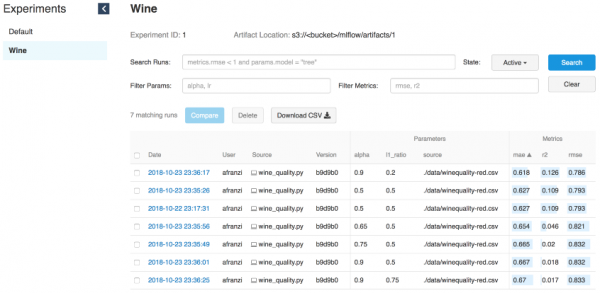
Iterațiile wine
Partea de server pentru model
Serverul de urmărire MLflow, pornit cu comanda "mlflow server", are o API REST pentru urmărirea execuțiilor și înregistrarea datelor în sistemul de fișiere local. Puteți specifica adresa serverului de urmărire folosind variabila de mediu «MLFLOW_TRACKING_URI», iar API-ul de urmărire MLflow se va conecta automat la serverul de urmărire la această adresă pentru a crea/obține informații despre execuție, metrici de loguri etc.
Sursa:
Pentru a furniza modelului un server, avem nevoie de un server de urmărire pornit (vezi interfața de lansare) și ID-ul execuției modelului.
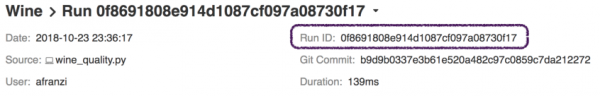
ID execuției
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Pentru a gestiona modelele cu ajutorul funcționalității MLflow serve, avem nevoie de acces la UI-ul de urmărire, pentru a obține informații despre model, indicând simplu --run_id.
Odată ce modelul se conectează la serverul de urmărire, putem obține un nou endpoint pentru model.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Rularea modelelor din Spark
Deși serverul de urmărire este suficient de puternic pentru a gestiona modele în timp real, antrenarea și utilizarea funcționalității serve (sursa: ), utilizarea Spark (batch sau streaming) este o soluție și mai puternică datorită distribuției.
Imaginați-vă că ați finalizat antrenarea offline, iar apoi ați aplicat modelul rezultat la toate datele dumneavoastră. Aici, Spark și MLflow vor fi cele mai utile.
Instalăm PySpark + Jupyter + Spark
Sursa:
Pentru a arăta cum aplicăm modelele MLflow la dataframe-urile Spark, trebuie să configurăm colaborarea între notele Jupyter și PySpark.
Începeți cu instalarea celei mai recente versiuni stabile :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Instalați PySpark și Jupyter în mediu virtual:
pip install pyspark jupyterConfigurați variabilele de mediu:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Definind notebook-dir, putem stoca notele noastre în folderul dorit.
Lansăm Jupyter din PySpark
Deoarece am reușit să configurăm Jupyter ca driver PySpark, acum putem lansa notebook-ul Jupyter în contextul PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] extensia sparkmagic activată!
[I 19:05:01.573 NotebookApp] Notebook-urile sunt servite din directorul local: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] Jupyter Notebook este în execuție la:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Folosește Control-C pentru a opri acest server și a închide toate kernel-urile (de două ori pentru a sări peste confirmare).
[C 19:05:01.574 NotebookApp]

    Cumpără/atașează acest URL în browserul tău când te conectezi pentru prima dată,
    pentru a te autentifica cu un token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Așa cum am menționat anterior, MLflow oferă funcția de logare a artefactelor modelului în S3. Odată ce avem modelul ales, putem să-l importăm ca UDF folosind modulul mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 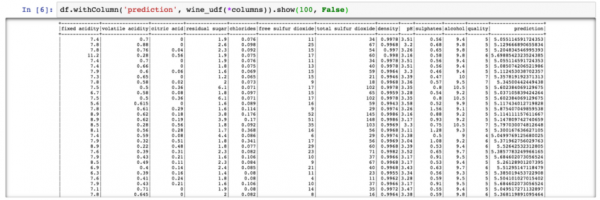
PySpark – Ieșirea prognozei calității vinului
Până acum, am discutat despre cum să folosim PySpark cu MLflow, efectuând prognozarea calității vinului pe întregul set de date wine. Dar ce facem dacă trebuie să folosim modulele Python MLflow din Scala Spark?
Am testat și aceasta, împărțind contextul Spark între Scala și Python. Adică am înregistrat UDF-ul MLflow în Python și l-am folosit din Scala (da, poate nu este cea mai bună soluție, dar este ceea ce avem).
Scala Spark + MLflow
Pentru acest exemplu, vom adăuga în Jupyter-ul existent.
Instalăm Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Kerneluri disponibile:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
După cum se poate vedea din notebook-ul atașat, UDF-ul este folosit împreună cu Spark și PySpark. Sperăm că această secțiune va fi utilă celor care iubesc Scala și doresc să desfășoare modele de învățare automată în producție.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf.<locals>.predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Următorii pași
Deși, la momentul redactării acestui articol, MLflow se află în versiune Alpha, arată promițător. Posibilitatea de a rula mai multe framework-uri de învățare automată și de a le folosi dintr-un singur punct de acces ridică sistemele de recomandare la un nou nivel.
În plus, MLflow apropie inginerii de date de specialiștii în știința datelor, creând un strat comun între ei.
După această cercetare MLflow, suntem convinși că vom merge mai departe și vom folosi aceasta pentru pipeline-urile noastre Spark și în sistemele de recomandare.
Ar fi bine să sincronizăm stocarea de fișiere cu baza de date, în loc să folosim sistemul de fișiere. Astfel, ar trebui să obținem mai multe puncte finale care pot utiliza aceeași stocare de fișiere. De exemplu, să folosim mai multe instanțe și cu același metastore Glue.
În concluzie, dorim să mulțumim comunității MLFlow pentru că faceți munca noastră cu datele mai interesantă.
Dacă experimentați cu MLflow, nu ezitați să ne scrieți și să ne povestiți cum îl folosiți, mai ales dacă îl utilizați în producție.
Aflați mai multe despre cursuri:
Citește mai mult:
Sursa: habr.com
