

Salut, Habr!
Vă reamintim că, pe lângă cartea despre am publicat o lucrare la fel de interesantă despre biblioteca .
În timp ce comunitatea abia începe să exploreze limitele acestui instrument puternic. Recent a fost publicat un articol, cu traducerea căruia vrem să vă familiarizăm. Autorul povestește din experiența proprie cum să transformi Kafka Streams într-un depozit de date distribuit. Lectură plăcută!
Biblioteca Apache este utilizată la nivel mondial în mediul enterprise pentru procesarea fluxurilor distribuite pe baza Apache Kafka. Unul dintre aspectele subestimate ale acestui cadru este că permite păstrarea unui stat local, generat pe baza procesării fluxurilor.
În acest articol, voi explica cum compania noastră a reușit să utilizeze eficient această oportunitate în dezvoltarea unui produs pentru securitatea aplicațiilor cloud. Cu ajutorul Kafka Streams, am creat microservicii cu stare partajată, fiecare dintre ele servind ca o sursă de informații de încredere, rezistentă la erori și cu disponibilitate ridicată, despre starea obiectelor din sistem. Pentru noi, acesta a fost un pas înainte atât în ceea ce privește fiabilitatea, cât și în confortul întreținerii.
Dacă sunteți interesat de o abordare alternativă care permite utilizarea unei baze de date centrale unice pentru a susține starea formală a obiectelor dumneavoastră – citiți, va fi interesant...
De ce am considerat că este timpul să ne schimbăm abordările în gestionarea stării partajate
Aveam nevoie să menținem starea diferitelor obiecte bazându-ne pe rapoartele agenților (de exemplu: a fost un atac asupra site-ului?). Înainte de a migra la Kafka Streams, ne bazam adesea pentru gestionarea stării pe o bază de date centrală unică (+ API de serviciu). Această abordare are dezavantajele sale: menținerea consistenței și sincronizării devine o adevărată provocare. Baza de date poate deveni un blocaj, sau s-ar putea afla într-o și să sufere de imprevizibilitate.
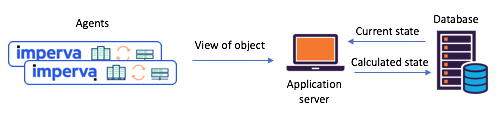
Ilustrarea 1: Un scenariu tipic de separare a stării, întâlnit înainte de migrarea la
Kafka și Kafka Streams: agenții comunică viziuni prin API, starea actualizată este calculată prin baza de date centrală.
Cunoașteți Kafka Streams – acum a devenit ușor să creați microservicii cu stare partajată.
Aproape un an în urmă, am decis să regândim seriile noastre de lucru cu starea partajată pentru a rezolva astfel de probleme. Imediat am decis să încercăm Kafka Streams - este binecunoscută scalabilitatea, disponibilitatea ridicată și reziliența acesteia, precum și bogata funcționalitate de streaming (inclusiv transformări cu păstrarea stării). Exact ceea ce ne trebuia, nemaivorbind de cât de matură și fiabilă este sistemul de mesagerie dezvoltat în Kafka.
Fiecare dintre microserviciile noastre cu starea partajată era construit pe baza unei instanțe Kafka Streams cu o topologie destul de simplă. Aceasta consta în 1) o sursă 2) un procesor cu un magazin permanent de chei și valori 3) un flux:
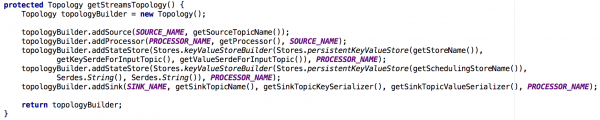
Ilustrarea 2: topologia implicită a instanțelor noastre de streaming pentru microserviciile cu starea partajată. Rețineți: aici există, de asemenea, un magazin care conține metadate despre programare.
În acest nou mod de abordare, agenții compun mesajele trimise către topicul sursă, iar consumatorii - să zicem, serviciul de notificări prin poștă - primesc starea partajată calculată prin flux (topicul de ieșire).
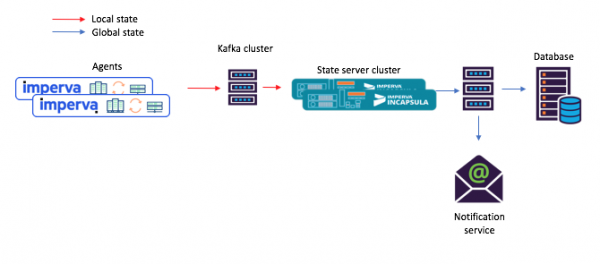
Ilustrarea 3: un nou exemplu de flux de sarcini pentru un scenariu cu microservicii partajate: 1) agentul generează un mesaj care ajunge în topicul sursă Kafka; 2) microserviciul cu starea partajată (folosind Kafka Streams) îl procesează și scrie starea calculată în topicul final Kafka; după care 3) consumatorii primesc noua stare.
Hei, și acest magazin încorporat de chei și valori este cu adevărat foarte util!
Așa cum s-a menționat anterior, topologia noastră cu starea partajată conține un magazin de chei și valori. Am descoperit câteva moduri de utilizare a acestuia, iar două dintre ele sunt descrise mai jos.
Opțiunea #1: utilizarea magazinului de chei și valori în cadrul calculilor.
Primul nostru depozit de chei și valori conținea date auxiliare de care aveam nevoie pentru calcule. De exemplu, în unele cazuri, starea partajată era determinată pe baza principiului „majorității voturilor”. În depozit se puteau păstra toate ultimele rapoarte ale agenților despre starea unui anumit obiect. Apoi, primind un nou raport de la un anumit agent, puteam salva raportul, extrage din depozit rapoartele tuturor celorlalți agenți despre starea aceluiași obiect și repeta calculul.
Ilustrația 4 de mai jos arată cum am deschis accesul la depozitul de chei și valori pentru metoda de procesare a procesorului, astfel încât să putem procesa un nou mesaj.
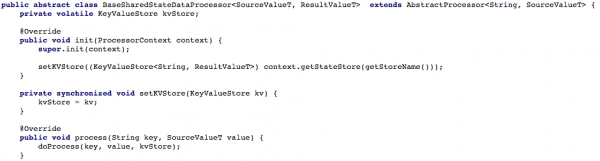
Ilustrația 4: deschiderea accesului la depozitul de chei și valori pentru metoda de procesare a procesorului (după aceasta, în fiecare scenariu care lucrează cu stări partajate, este necesar să se implementeze metoda doProcess)
Opțiunea #2: crearea unui API CRUD deasupra Kafka Streams
După ce ne-am configurat fluxul de sarcini de bază, am încercat să scriem un API RESTful CRUD pentru microserviciile noastre cu stare partajată. Am dorit să putem extrage starea unora sau a tuturor obiectelor, precum și să stabilim sau să ștergem starea unui obiect (acest lucru este util pentru suportul părții server).
Pentru a susține toate API-urile Get State, de fiecare dată când trebuia să recalculăm starea în timpul procesării, o stocam pe termen lung în depozitul încorporat de chei și valori. În acest caz, devine suficient de simplu să implementăm un astfel de API folosind un singur exemplu de Kafka Streams, așa cum este ilustrat în listingul de mai jos:
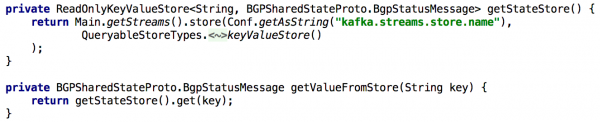
Ilustrația 5: utilizarea depozitului încorporat de chei și valori pentru obținerea stării pre-calculate a obiectului
Actualizarea stării unui obiect prin API nu este de asemenea greu de realizat. În principiu, pentru aceasta trebuie doar să creăm un producer Kafka, iar cu acesta să facem o scriere care conține noua stare. Aceasta asigură că toate mesajele generate prin API vor fi procesate exact la fel ca cele care provin de la alți producători (de exemplu, agenți).
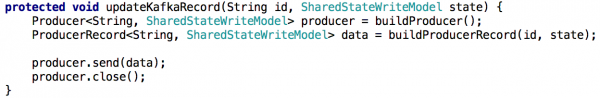
Ilustrația 6: starea unui obiect poate fi stabilită prin intermediul unui producer Kafka
O mică complicație: Kafka are multe partiții
Așadar, am dorit să distribuiem sarcina de procesare și să îmbunătățim disponibilitatea, oferind pentru fiecare scenariu un cluster de microservicii cu stare partajată. Configurarea a fost mai simplă decât ne-am fi imaginat: după ce am configurat toate instanțele pentru a lucra cu același ID de aplicație (și cu aceleași servere de boot), aproape totul s-a realizat automat. De asemenea, am specificat că fiecare topic de intrare va consta din mai multe partiții, pentru ca fiecărei instanțe să-i fie atribuit un subset al acestor partiții.
De asemenea, aș dori să menționez că aici este obișnuit să faci un backup al stocării stărilor, pentru ca, de exemplu, în caz de recuperare după o defecțiune, să transferi această copie pe o altă instanță. Fiecare stocare de stare în Kafka Streams are un topic replicabil creat cu un jurnal de modificări (în care se urmăresc actualizările locale). Astfel, Kafka asigură constant stocarea stărilor. Prin urmare, în caz de defecțiune a uneia sau alteia dintre instanțe, stocarea stărilor Kafka Streams poate fi recuperată rapid pe altă instanță, unde vor fi transferate partițiile corespunzătoare. Testele noastre au arătat că acest lucru se face în câteva secunde, chiar și atunci când stocarea conține milioane de înregistrări.
Trecând de la un singur microserviciu cu stare partajată la un cluster de microservicii, devine mai puțin trivial să implementăm Get State API. În noua situație, stocarea stărilor fiecărui microserviciu conține doar o parte din imaginea generală (acele obiecte ai căror chei erau mapate la o anumită partiție). A trebuit să determinăm pe ce instanță se afla starea obiectului dorit, și am făcut acest lucru pe baza metadatelor fluxurilor, așa cum este prezentat mai jos:
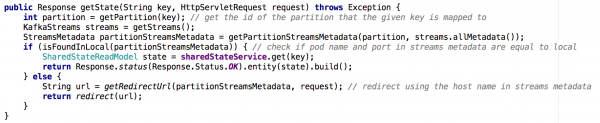
Ilustrarea 7: folosind metadatele fluxurilor, determinăm de pe ce instanță să cerem starea obiectului necesar; o abordare similară a fost utilizată cu GET ALL API
Concluzii principale
Stocările stărilor în Kafka Streams pot de facto servi ca o bază de date distribuită,
- replicată constant în Kafka
- Pe o astfel de sistem, este ușor de construit un CRUD API
- Procesarea mai multor partiții devine puțin mai complexă
- De asemenea, este posibil să adăugați una sau mai multe stocări de stare în topologia de flux pentru a păstra date auxiliare. Această opțiune poate fi utilizată pentru:
- Stocarea pe termen lung a datelor necesare pentru calcule în cadrul procesării de flux
- Stocarea pe termen lung a datelor care pot fi utile la următoarea inițializare a instanței de flux
- multe altele…
Datorită acestor și altor avantaje, Kafka Streams este ideal pentru a sprijini starea globală într-o astfel de sistem distribuit ca al nostru. Kafka Streams s-a dovedit a fi foarte fiabil în producție (de la implementarea sa, nu am pierdut practic mesaje), și suntem încrezători că posibilitățile sale nu se limitează aici!
Sursa: habr.com
