

Uneori, pentru a rezolva o problemă, trebuie doar să te uiți la ea dintr-un alt unghi. Chiar dacă în ultimii zece ani, probleme similare au fost rezolvate în același mod cu efecte diferite, nu înseamnă că această metodă este singura.
Există un lucru numit plecare a clienților. Este ceva inevitabil, deoarece clienții oricărei companii pot, din diverse motive, să înceteze să folosească produsele sau serviciile sale. Evident, pentru o companie, plecarea este, deși naturală, o acțiune de dorit, prin urmare, toată lumea încearcă să minimizeze acest fenomen. Și mai bine ar fi să prezicem probabilitatea plecării unei anumite categorii de utilizatori sau a unui utilizator specific și să propunem anumite măsuri pentru retenție.
Analiza și încercarea de a reține clientul, dacă este posibil, este necesară, cel puțin, din următoarele motive:
- atragerea de noi clienți este mai scumpă decât procedurile de retenție. De obicei, este necesar să cheltuiești o sumă pentru atragerea de noi clienți (publicitate), în timp ce clienții existenți pot fi activați printr-o ofertă specială cu condiții speciale;
- înțelegerea motivelor plecării clienților este cheia pentru îmbunătățirea produselor și serviciilor.
Există abordări standard pentru prognozarea plecării. Dar, la unul dintre campionatele de AI, am decis să încercăm distribuția Weibull pentru acest scop. Este folosită cel mai frecvent pentru analiza supraviețuirii, prognozarea vremii, analiza dezastrelor naturale, inginerie industrială și altceva similar. Distribuția Weibull este o funcție de distribuție specială, parametrizată prin doi parametri.  și
 .
Wikipedia
În general, este o idee interesantă, dar pentru prognozarea plecării, și în general în fintech, nu este folosită atât de des. Sub tipar vă vom povesti cum am realizat acest lucru (Laboratorul de analiză inteligentă a datelor), câștigând în același timp aurul la Campionatul de inteligență artificială la categoria „AI în bănci”.
Despre plecare în general
Hai să înțelegem puțin ce este retenția clienților și de ce este atât de importantă. Pentru afaceri, baza de clienți este esențială. Această bază se completează cu clienți noi, care află despre produs sau serviciu prin publicitate, folosesc activ produsele pentru o perioadă de timp și, după un anumit interval, încetează să le folosească. Această perioadă este numită „Ciclul de viață al clientului” (eng. Customer Lifecycle) — un termen care descrie etapele prin care trece un client când află despre un produs, ia o decizie de cumpărare, face plata, utilizează și devine un consumator loial, iar ulterior, din diverse motive, încetează utilizarea produselor. Așadar, retenția reprezintă etapa finală a ciclului de viață al clientului, atunci când clientul încetează să mai utilizeze serviciile, iar pentru afacere, aceasta înseamnă că din acel moment clientul nu mai aduce profit și, în general, niciun beneficiu.
Fiecare client al băncii este o persoană concretă, care alege un anumit tip de card bancar în funcție de nevoile sale. Călătorește frecvent — îi va fi util un card cu mile. Face multe cumpărături — salut, card cu cashback. Face multe achiziții în magazine specifice — pentru aceștia deja există un plastic partener. Bineînțeles, uneori cardul este ales și pe criteriul „Cele mai ieftine costuri de întreținere”. În general, aici variabilele sunt numeroase.
De asemenea, persoana alege și banca — care ar fi sensul de a alege cardul unei bănci, a cărei sucursale există doar în Moscova și împrejurimi, când tu ești din Habarovsk? Chiar dacă cardul acelei bănci ar fi de două ori mai avantajos, prezența sucursalelor băncii în apropiere rămâne un criteriu important. Da, 2019 este deja aici și digitalul este totul pentru noi, dar unele probleme la anumite bănci pot fi rezolvate doar în sucursală. În plus, o parte a populației acordă mult mai multă încredere băncii fizice decât unei aplicații pe smartphone, și acest lucru trebuie luat în considerare.
Ca urmare, există multe motive pentru care o persoană poate renunța la produsele băncii (sau la bancă în sine). A schimbat locul de muncă, iar tariful cardului s-a schimbat dintr-unul de salariu într-unul pentru „muritorii de rând”, care este mai puțin avantajos. S-a mutat într-un alt oraș, unde nu există sucursale ale băncii. Nu i-a plăcut interacțiunea cu un operator necalificat din sucursală. Așadar, motivele pentru închiderea contului pot fi chiar mai numeroase decât cele pentru utilizarea produsului.
În plus, clientul nu trebuie să-și exprime în mod explicit intenția - de a merge la bancă și a scrie o cerere, ci poate pur și simplu să înceteze utilizarea produselor, fără a rezilia contractul. De aceea, pentru a înțelege astfel de situații, s-a decis utilizarea învățării automate și a inteligenței artificiale.
Mai mult, pierderea clienților poate avea loc în orice industrie (telecomunicații, furnizori de internet, companii de asigurări, în general, oriunde există o bază de clienți și tranzacții periodice).
Ce am făcut
În primul rând, a fost necesar să se descrie o limită clară - de la ce moment începem să considerăm clientul ca fiind plecat. Din perspectiva băncii care ne-a oferit datele pentru analiză, starea de activitate a clientului era binară - fie era activ, fie nu. Există un flag numit ACTIVE_FLAG în tabelul «Activitate», al cărui valoare putea fi fie «0», fie «1» (respectiv, «Inactiv» și «Activ»). Și totul ar fi fost bine, dar natura umană este astfel încât o persoană poate folosi activ produsele pentru o perioadă, iar apoi să devină inactivă timp de o lună - poate s-a îmbolnăvit, a plecat în vacanță în altă țară sau pur și simplu testează cardul unei alte bănci. Sau poate, după o perioadă lungă de inactivitate, începe din nou să utilizeze serviciile băncii.
Prin urmare, am decis să numim perioada de inactivitate un anumit interval continuu de timp în care flag-ul pentru el era setat ca «0».
Clienții trec din starea de inactivitate în starea activă după perioade de inactivitate de diverse lungimi. Avem posibilitatea de a calcula gradul de mărime empirică «fiabilitatea perioadelor de inactivitate» - adică probabilitatea că o persoană să înceapă din nou să folosească produsele băncii după o inactivitate temporară.
De exemplu, în acest grafic este reprezentată reluarea activității (ACTIVE_FLAG=1) a clienților după câteva luni de inactivitate (ACTIVE_FLAG=0).
Aici vom clarifica puțin setul de date cu care am început să lucrăm. Astfel, banca a furnizat informații agregate pe 19 luni în următoarele tabele:
- «Activitate» - tranzacții lunare ale clienților (pe carduri, în online banking și mobile banking), inclusiv plăți salariale și informații despre turnover.
- «Carduri» - date despre toate cardurile deținute de client, cu o rețea tarifară detaliată.
- „Contractele“ – informații despre contractele clienților (atât cele deschise, cât și cele închise): credite, depozite și altele, cu indicația parametrilor fiecăruia.
- „Clienții“ – un set de date demografice (sex și vârstă) și disponibilitatea datelor de contact.
Pentru lucru, ne-au fost necesare toate tabelele, mai puțin „Cardurile“.
Dificultatea a fost că, în aceste date, banca nu specifica ce tip de activitate a avut loc pe carduri. Asta înseamnă că am putut înțelege dacă au existat tranzacții, dar nu am putut determina tipul acestora. Deci, nu era clar dacă clientul a retras numerar, a primit salariul sau a cheltuit bani pe achiziții. De asemenea, nu aveam date despre soldurile din conturi, ceea ce ar fi fost util.
Selectarea în sine a fost nesegmentată – în acest eșantion, timp de 19 luni, banca nu a făcut nicio tentativă de a reține clienții și de a minimiza pierderile.
Așadar, despre perioadele de inactivitate.
Pentru formularea definiției pierderii, trebuie ales un period de inactivitate. Pentru a crea o prognoză a pierderii în anumite momente în timp,  , trebuie să avem istoria clienților de minimum 3 luni în intervalul
 . Istoria noastră a fost limitată la 19 luni, așa că am decis să luăm perioada de inactivitate de 6 luni, dacă există. Iar pentru perioada minimă pentru o prognoză de calitate, am luat 3 luni. Numerele de 3 și 6 luni le-am ales empiric pe baza analizei comportamentului acestor clienți.
Am formulat definiția pierderii astfel: luna de pierdere a clientului  este prima lună cu ACTIVE_FLAG=0, unde din această lună urmează cel puțin șase zero-uri consecutive în câmpul ACTIVE_FLAG, cu alte cuvinte, luna din care clientul a fost inactiv timp de 6 luni.
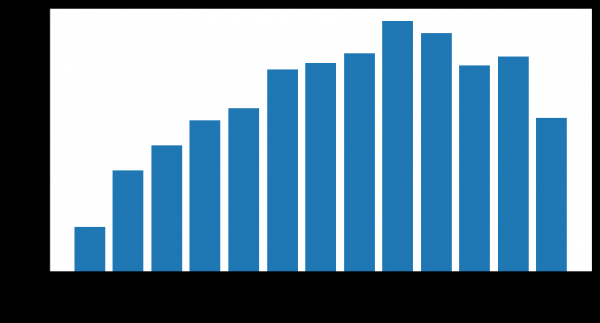
Numărul de clienți pierduți
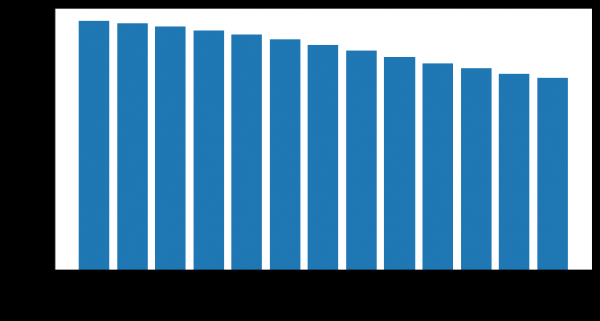
Numărul de clienți rămași
Cum se consideră pierderea
În astfel de competiții și, în general, în practică, pierderea este adesea prognozată în acest mod. Clientul folosește produse și servicii în intervale diferite de timp, iar datele despre interacțiunea cu acesta sunt prezentate sub formă de vector de caracteristici de lungime fixă n. Cel mai frecvent, aceste informații includ:
- Datele caracterizatoare ale utilizatorului (date demografice, segment de marketing).
- Istoria utilizării produselor și serviciilor bancare (acestea sunt acțiunile clienților, care sunt întotdeauna legate de un anumit timp sau de perioada intervalului necesar pentru noi).
- Date externe, dacă au fost obținute — de exemplu, recenzii din rețelele sociale.
Și apoi, după aceea, se formulează o definire a ratei de abandon, specifică pentru fiecare sarcină. Apoi se utilizează un algoritm de învățare automată, care prezice probabilitatea plecării clientului  pe baza vectorului de factori
 . Pentru antrenarea algoritmului se folosește unul dintre cadrele cunoscute pentru construirea ansamblurilor de arbori decizionali, , , sau modificările acestora.
Algoritmul în sine nu este rău, dar în ceea ce privește prognoza ratei de abandon are câteva dezavantaje semnificative.
- Nu dispune de așa-numita „memorie”. La intrarea modelului ajunge un număr specificat de caracteristici, care corespund momentului actual. Pentru a incorpora informații despre istoria modificării parametrilor, este necesar să se calculeze caracteristici speciale, care caracterizează modificările parametrilor în timp, de exemplu, numărul sau suma tranzacțiilor bancare în ultimele 1, 2, 3 luni. Această abordare poate reflecta doar parțial natura modificărilor temporale.
- Horizon de prognoză fixat. Modelul poate prezice abandonul clienților doar pe o perioadă de timp prestabilită, de exemplu, prognoza pentru o lună în viitor. Dacă este necesară o prognoză pentru o altă perioadă de timp, de exemplu, pentru trei luni, atunci trebuie să se reconfigureze setul de date pentru antrenament și să se reantreneze un nou model.
Abordarea noastră
Am decis de la început că nu vom folosi abordările standard. În campionat s-au înregistrat și alți 497 de participanți, fiecare având o experiență considerabilă. Așa că încercarea de a face ceva conform schemei standard în aceste condiții nu este cea mai bună idee.
Și am început să abordăm problemele întâmpinate de modelul de clasificare binară, prin prognozarea distribuției probabilității timpului de abandon al clienților. O astfel de abordare poate fi examinată , ea permite prognozarea mai flexibilă a abandonului și verificarea unor ipoteze mai complexe decât în abordarea clasică. Ca familie de distribuții care modelează timpul de abandon, am ales distribuția pentru utilizarea sa largă în analiza supraviețuirii. Comportamentul clientului poate fi privit ca un fel de supraviețuire.
Iată exemple de distribuții de densitate de probabilitate Weibull în funcție de parametri  și
 :
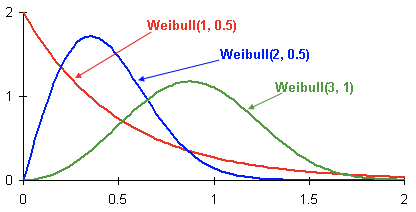
Aceasta este densitatea de distribuție a probabilității de abandon a trei clienți diferiți în timp. Timpul este reprezentat în luni. Cu alte cuvinte, acest grafic arată când este cel mai probabil să aibă loc abandonul clientului în următoarele două luni. După cum se poate observa, clientul cu distribuția Weibull(2, 0.5) are un potențial mai mare de a pleca mai devreme comparativ cu clienții cu distribuțiile Weibull(2, 0.5) și Weibull(3,1).
Rezultatul este un model care prezice pentru fiecare client, pentru orice
lună, parametrii distribuției Weibull care reflectă cel mai bine probabilitatea de abandon în timp. Mai precis:
- Caracteristicile țintă din setul de antrenament sunt timpul rămas până la abandon în o anumită lună pentru un anumit client.
- Dacă nu avem un indicator de abandon pentru client, presupunem că timpul de abandon este mai mare decât numărul de luni, de la momentul actual și până la sfârșitul istoricului pe care îl avem.
- Modelul utilizat: rețea neuronală recurentă cu strat LSTM.
- Folosim ca funcție de pierdere logaritmul negativ al funcției de verosimilitate pentru distribuția Weibull.
Iată avantajele acestei metode:
- Distribuția probabilistică, pe lângă evidenta capacitate de clasifiere binară, permite prezicerea flexibilă a diferitelor evenimente, de exemplu, dacă un client va înceta să folosească serviciile băncii în termen de 3 luni. De asemenea, dacă este necesar, putem media diferite metrici pe baza acestei distribuții.
- Rețeaua neuronală recurentă LSTM are memorie și utilizează eficient toată istoricul disponibil. Odată cu extinderea sau rafinarea istoricului, acuratețea crește.
- Abordarea poate fi scalată fără probleme prin împărțirea intervalelor de timp în unități mai mici (de exemplu, prin împărțirea lunilor în săptămâni).
Dar este insuficient să creezi un model bun, este necesar să evaluăm corect calitatea acestuia.
Cum am evaluat calitatea
Ca metrică, am ales Curba de Lift. Aceasta este utilizată în afaceri pentru astfel de cazuri datorită interpretării sale clare, fiind bine descrisă și . Dacă ar trebui să descriem sensul acestei metrici în unei fraze, ar fi „De câte ori algoritmul face o prezicere mai bună în primele  % comparativ cu una aleatoare.”
Antrenăm modelele
Condițiile competiției nu au stabilit o metrică specifică de calitate prin care să putem compara diferite modele și abordări. Mai mult decât atât, definiția conceptului de churn poate varia și poate depinde de obiectivele de afaceri. Prin urmare, pentru a înțelege care metodă este mai bună, am antrenat două modele:
- Abordarea frecvent utilizată a clasificării binare folosind algoritmul de învățare automată bazat pe ansambluri de arbori decizionali ();
- Modelul Weibull-LSTM
Setul de testare a fost format din 500 de clienți selectați anterior, care nu erau în setul de antrenament. Pentru model, s-au realizat ajustări ale hiperparametrelor utilizând validarea încrucișată pe baza clienților. Pentru antrenarea fiecărui model au fost folosite aceleași seturi de caracteristici.
Având în vedere că modelul nu are memorie, s-au luat caracteristici speciale care arată relația dintre schimbările parametrilor dintr-o lună comparativ cu media parametrilor din ultimele trei luni. Aceasta a caracterizat viteza de schimbare a valorilor din ultimele trei luni. Fără aceasta, modelul bazat pe Random Forest ar fi fost în dezavantaj față de Weibull-LSTM.
De ce este LSTM cu distribuția Weibull mai bun decât abordarea bazată pe ansambluri de arbori decizionali
Aici totul este vizibil, literar, cu câteva imagini.
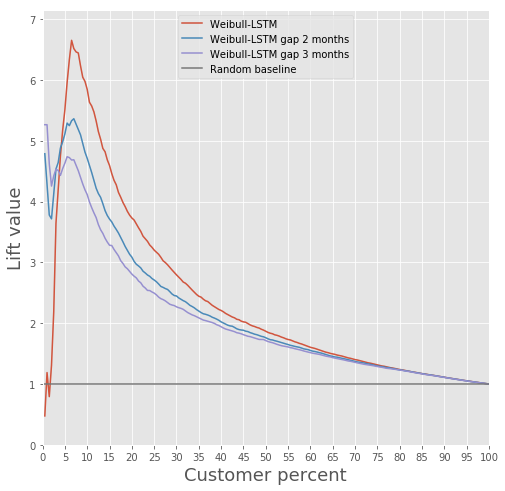
Compararea Lift Curve pentru algoritmul clasic și Weibull-LSTM
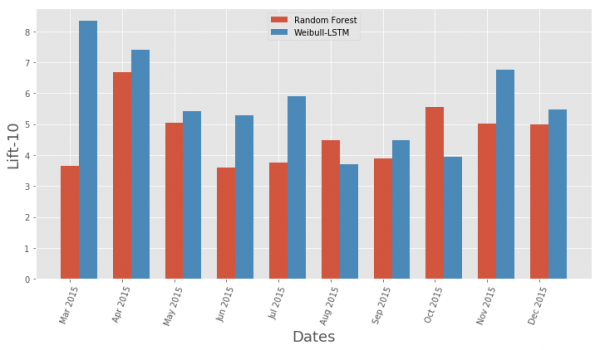
Compararea metricii Lift Curve pe luni pentru algoritmul clasic și Weibull-LSTM
În general, LSTM depășește algoritmul clasic în aproape toate cazurile.
Predicția churn-ului
Modelul bazat pe rețele neuronale recurente cu celule LSTM cu distribuție Weibull poate prezice churn-ul în avans, de exemplu, poate prezice plecarea clientului în următoarele n luni. Să examinăm cazul pentru n = 3. În acest caz, pentru fiecare lună, rețeaua neurală trebuie să determine corect: dacă clientul va pleca începând cu luna următoare până la luna n. Cu alte cuvinte, trebuie să determine corect dacă clientul va rămâne după expirarea lui n luni. Acesta poate fi considerat un prognoză anticipată: prezicerea momentului când clientul a început doar să se gândească să plece.
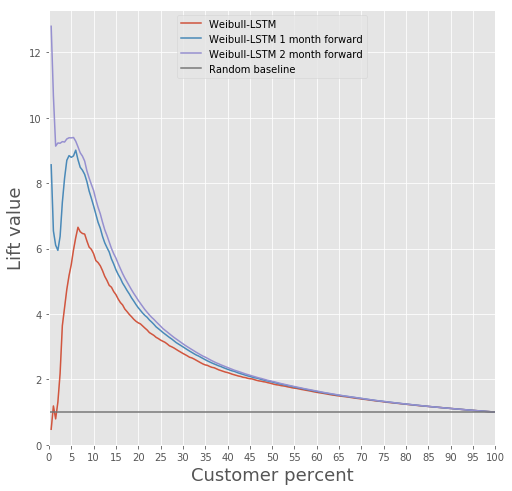
Să comparăm Lift Curve pentru Weibull-LSTM cu 1, 2 și 3 luni înainte de churn:
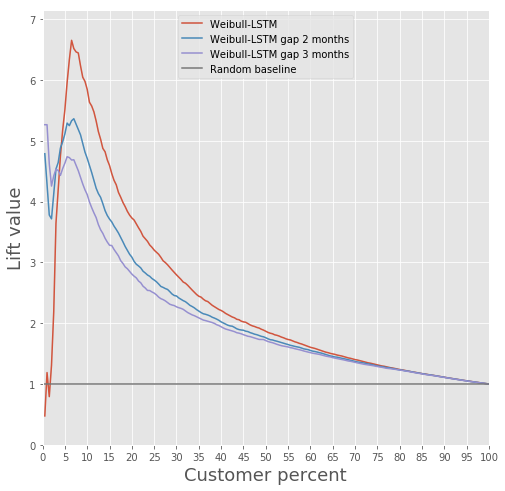
Am menționat anterior că sunt importante și prognozările pentru clienții care devin inactivi pentru o perioadă de timp. Așadar, vom adăuga în selecție cazurile în care un client plecat a fost inactiv timp de o lună sau două, și vom verifica dacă Weibull-LSTM clasifică corect aceste cazuri ca fiind pierdere. Deoarece aceste cazuri au fost prezente în selecție, ne așteptăm ca rețeaua să le gestioneze bine:
Păstrarea clienților
Aceasta este, de fapt, esența a ceea ce putem face, având informația că anumiți clienți se pregătesc să nu mai utilizeze produsul. Vorbind despre construirea unui model care ar putea oferi ceva util clienților pentru a-i păstra - acest lucru nu va fi posibil dacă nu aveți o istorie a unor asemenea încercări care au avut un rezultat pozitiv.
Nu am avut o astfel de istorie, așa că am decis să procedăm astfel.
- Construim un model care identifică produsele interesante pentru fiecare client.
- În fiecare lună, rulăm clasificatorul și identificăm clienții potențial plecători.
- O parte din clienți primesc produse conform modelului din punctul 1, ne amintim acțiunile noastre.
- După câteva luni, observăm cine dintre acești clienți potențial plecători a plecat și cine a rămas. Astfel, formulam un set de date pentru învățare.
- Învățăm modelul pe baza istoriei obținute în punctul 4.
- Opțional, repetăm procedura, înlocuind modelul din punctul 1 cu modelul obținut în punctul 5.
O metodă de verificare a calității acestei păstrări poate fi un test A/B obișnuit - împărțim clienții potențial plecători în două grupuri. Uneia îi oferim produse bazate pe modelul nostru de păstrează, iar celeilalte nu le oferim nimic. Am decis să învățăm un model care ar putea aduce beneficii chiar în punctul 1 al exemplului nostru.
Am dorit să facem segmentarea cât mai ușor de interpretat. Pentru aceasta, am ales câteva caracteristici care ar putea fi interpretate ușor: numărul total de tranzacții, salariul, volumul total al contului, vârsta, sexul. Caracteristicile din tabelul „Carduri” nu au fost luate în considerare ca fiind puțin informatice, iar caracteristicile din tabelul 3 „Contracte” - din cauza complexității procesării pentru a evita scurgerea de date între setul de validare și setul de învățare.
Clusterizarea a fost realizată folosind modele de amestec Gaussian. Criteriul de informație Akaike a permis identificarea a două optimumuri. Primul optimum corespunde unui cluster. Al doilea optimum, mai puțin pronunțat, corespunde la 80 de clustere. Din acest rezultat se poate trasa următoarea concluzie: datele sunt extrem de greu de împărțit în clustere fără informații prealabile. Pentru o clusterizare de mai bună calitate sunt necesare date care descriu detaliat fiecare client.
Prin urmare, a fost analizată problema învățării supervizate, pentru a propune fiecărui client în parte produsul său. Au fost luate în considerare următoarele produse: „Depozit la termen”, „Card de credit”, „Overdraft”, „Credit de consum”, „Credit auto”, „Ipotecă”.
În date a fost prezent un alt tip de produs: „Cont curent”. Dar nu l-am considerat din cauza informațiilor insuficiente. Pe utilizatorii care sunt clienți ai băncii, adică nu au încetat să utilizeze produsele sale, a fost construit un model care prezice ce produs le-ar putea interesa. Ca model a fost aleasă regresia logistică, iar ca metrică de evaluare a calității a fost utilizată valoarea Lift pentru primele 10 percentile.
Calitatea modelului poate fi evaluată în figura.
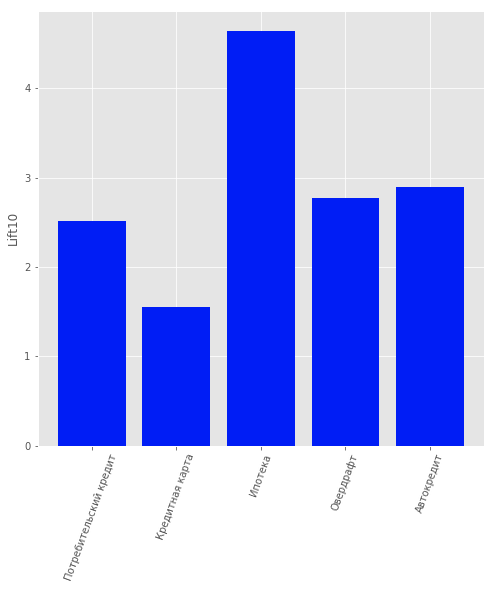
Rezultatele modelului de recomandare a produselor pentru clienți
Rezultatul
Această abordare ne-a adus primul loc la categoria „AI în bănci” la Campionatul AI RAIF-Challenge 2017.
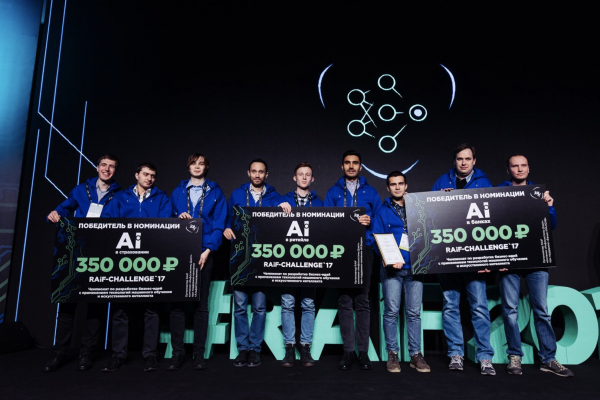
Se pare că principalul lucru a fost să abordăm problema dintr-o perspectivă mai puțin obișnuită și să folosim o metodă care este de obicei utilizată pentru alte situații.
Deși migrarea masivă a utilizatorilor poate fi cu adevărat o catastrofă pentru servicii.
Această metodă poate fi luată în considerare și pentru orice alt domeniu, unde este important să se țină cont de migrare, nu doar de bănci. De exemplu, am folosit-o și pentru a calcula propria migrare - în filiala din Siberia și în cea din Sankt Petersburg a Rostelecom.
„Laboratorul de analiză intelectuală a datelor” compania „Portalul de căutare Sputnik”
Sursa: habr.com
