

Leto tradične zaznamenáva pokles aktivity zákazníkov aj tempa zmien v infraštruktúre webových projektov, hovorí nám Captain Obvious. Jednoducho preto, že aj IT špecialisti si niekedy berú dovolenku. A aj CTO. Ešte ťažšie je to pre tých, ktorí zostávajú v službe, ale o to nejde: možno práve preto je leto najlepší čas na prehodnotenie existujúceho zálohovacieho systému a vypracovanie plánu na zlepšenie. Skúsenosti Jegora Andreeva z... , o ktorom hovoril na konferencii .
Pri budovaní záložných stránok, pri vytváraní záloh, existuje niekoľko pascí, do ktorých môžete padnúť. A absolútne do nich nesmiete padnúť. A v tomto všetkom, ako aj v mnohých iných veciach, je naším pádom perfekcionizmus a... lenivosť. Snažíme sa robiť všetko dokonale, ale dokonalosť nie je potrebná! Stačí robiť len určité veci, ale robiť ich správne, dotiahnuť ich do konca, aby fungovali správne.
Záložné prepnutie nie je len taká zábavná vec, ktorú treba mať; je navrhnuté presne na jednu vec: skrátiť prestoje, aby služba alebo spoločnosť strácala menej peňazí. A pri všetkých metódach zálohovania navrhujem zamyslieť sa v tomto kontexte: kde sú peniaze?
Prvá pascaKeď budujeme rozsiahle a spoľahlivé systémy a implementujeme redundanciu, znižujeme počet porúch. Toto je hrozný omyl. Keď implementujeme redundanciu, s najväčšou pravdepodobnosťou zvyšujeme počet porúch. A ak urobíme všetko správne, znížime celkový prestoj. Porúch bude viac, ale budú sa vyskytovať s nižšími nákladmi. Veď čo je redundancia? Je to zvyšovanie zložitosti systému. Akákoľvek zložitosť je zlá: máme viac ozubených koliesok, viac prevodov, skrátka viac prvkov – a teda vyššiu šancu na zlyhanie. A tie sa naozaj pokazia. A budú sa pokaziť častejšie. Jednoduchý príklad: povedzme, že máme webovú stránku s PHP a MySQL. A súrne ju treba zálohovať.
Takže, vezmime si druhú lokalitu a postavme identický systém... Zložitosť sa zdvojnásobí – máme dve entity. Pridáme tiež špecifickú logiku na prenos údajov z jednej lokality na druhú – teda replikáciu údajov, statické kopírovanie atď. Logika replikácie je teda zvyčajne veľmi zložitá, a preto celková zložitosť systému môže byť nie 2-krát, ale 3-krát, 5-krát alebo 10-krát väčšia.
Druhá pascaKeď stavime skutočne rozsiahle a komplexné systémy, predstavujeme si, čo chceme dosiahnuť. Voilà: chceme superspoľahlivý systém, ktorý funguje bez akýchkoľvek prestojov, prepne sa za pol sekundy (alebo ešte lepšie, okamžite) a začneme premieňať svoje sny na skutočnosť. Je tu však háčik: čím kratší je požadovaný čas prepnutia, tým zložitejšia je logika systému. Čím zložitejšia je táto logika, tým častejšie systém zlyháva. A môžeme sa dostať do veľmi nepríjemnej situácie: snažíme sa zo všetkých síl skrátiť prestoje, ale v skutočnosti všetko príliš komplikujeme a keď sa niečo pokazí, prestoje sú nakoniec dlhšie. Tu sa často pristihnete pri myšlienke: no... bolo by lepšie, keby nebola redundancia. Bolo by lepšie, keby to bol jeden systém s jasným časom prestoja.
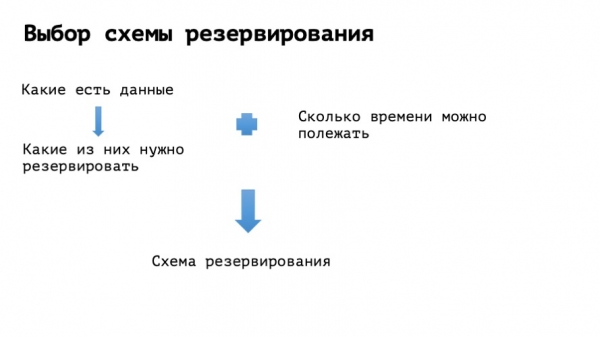
Ako s tým môžeme bojovať? Musíme prestať klamať sami seba, prestať si lichotiť, že sa chystáme postaviť vesmírnu loď, ale namiesto toho realisticky pochopiť, ako dlho môže projekt trvať. A v rámci tohto maximálneho časového rámca si vyberieme metódy, ktoré použijeme na zlepšenie spoľahlivosti nášho systému.
Je čas na nejaké „príbehy zo zadku“... samozrejme zo života.
Príklad číslo jedna
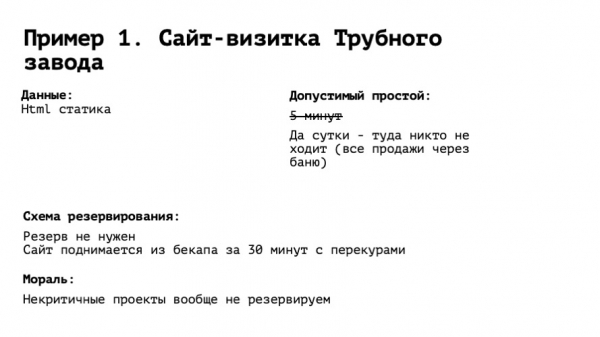
Predstavte si webovú stránku Valcovne rúr č. 1 v meste N. Obrovskými písmenami je na nej napísané: VALCOVŇA RÚR č. 1. Hneď pod tým je slogan: „Naše rúry sú najokrúhlejšie rúry v N.“ A pod tým je telefónne číslo a meno generálneho riaditeľa. Uvedomujeme si, že potrebujeme zálohu – je to neuveriteľne dôležité! Začíname chápať, z čoho pozostáva. Statický HTML kód je niekoľko obrázkov, ktoré zobrazujú generálneho riaditeľa v skutočnosti pri stole v saune so svojím partnerom a diskutujú o nejakom novom obchode. Začíname premýšľať o prestojoch. Napadne nás: mal by tam sedieť päť minút, nie viac. A potom vyvstáva otázka: koľko predajov bolo v skutočnosti vygenerovaných z tejto našej webovej stránky? Koľko? Čo znamená „nula“? Znamená to presne to: pretože generálny riaditeľ uzavrel všetky štyri obchody minulý rok pri tom istom stole, s tými istými ľuďmi, s ktorými sedí v saune. A chápeme, že aj keď je webová stránka nefunkčná jeden deň, nič hrozné sa nestane.
Na základe zadaných údajov máme deň na to, aby sme tento príbeh rozbehli. Začneme premýšľať o schéme zálohovania. A pre tento príklad vyberieme najideálnejšiu schému zálohovania: nepoužívame zálohy. Ktorýkoľvek administrátor to celé nastaví za pol hodiny vrátane prestávok. Nastaví webový server, nahraje súbory – to je všetko. Funguje to. Nič netreba monitorovať, nič si nevyžaduje špeciálnu pozornosť. Záver z príkladu číslo jedna je teda celkom zrejmý: služby, ktoré nepotrebujú zálohy, sa nemusia zálohovať.
Príklad číslo dva
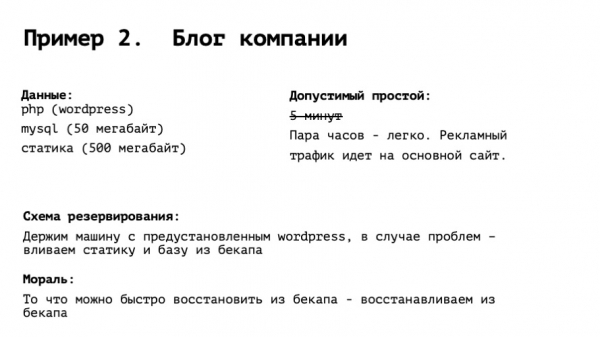
Firemný blog: špeciálne vyškolení zamestnanci tam píšu správy, napríklad, že sme sa zúčastnili tej a tej výstavy, že sme vydali nový produkt a tak ďalej. Povedzme, že ide o štandardné PHP s WordPress, malú databázu a trochu statických údajov. Samozrejme, myšlienka nechať ho nedostupný bezdôvodne – „nie viac ako päť minút!“ – a tak ďalej. Ale poďme sa zamyslieť ďalej. Čo tento blog robí? Ľudia sem prichádzajú z Yandexu, Googlu a organického vyhľadávania. Skvelé. Súvisia s tým vôbec predaje? Postreh: nie veľmi. Reklamná návštevnosť smeruje na hlavnú stránku, ktorá je na inom počítači. Začíname premýšľať o záložnom pláne pre blog. V ideálnom prípade by mal byť spustený do niekoľkých hodín a bolo by dobré byť na to pripravený. Rozumným riešením by bolo prenajať si počítač z iného dátového centra a nainštalovať naň prostredie, teda webový server, PHP, WordPress, MySQL a nechať ho tam, stlmený. V momente, keď si uvedomíme, že je všetko pokazené, musíme urobiť dve veci: spustiť výpis MySQL 50 metrov ďalej, čo trvá minútu, a spustiť nejaké obrazy zo zálohy. To tiež nie je práve veľa. Takže celé je to spustené a beží to do pol hodiny. Žiadna replikácia, alebo, Bože odpusť, automatické prepnutie na záložný systém. Zhrnutie: to, čo vieme rýchlo spustiť zo zálohy, nemusí byť zálohované.
Príklad číslo tri, trochu zložitejší
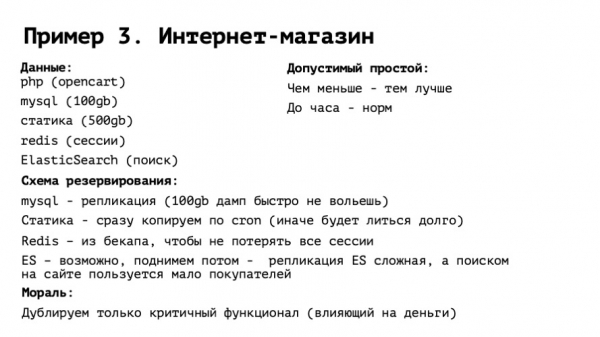
Internetový obchod. PHP s open-source enginom, mierne upravené, MySQL so solídnou databázou. Dosť statických dát (internetový obchod má krásne HD obrázky a tak ďalej), Redis pre reláciu a Elasticsearch pre vyhľadávanie. Začíname premýšľať o prestojoch. A tu je samozrejme zrejmé, že internetový obchod nemôže len tak sedieť deň bez toho, aby trpel. Koniec koncov, čím dlhšie je mimo prevádzky, tým viac peňazí strácame. Musíme ho zrýchliť. Ale koľko? Predpokladám, že ak tam budeme len tak sedieť hodinu, nikto sa nezblázni. Áno, niečo stratíme, ale ak to preženieme, bude to len horšie. Definujeme prijateľnú hodinovú sadzbu prestojov.
Ako sa dá toto všetko zálohovať? V každom prípade je potrebný stroj: hodina je dosť krátka. MySQL: to vyžaduje replikáciu, živú replikáciu, pretože 100 GB sa pravdepodobne za hodinu nevydá. Štatistiky, obrázky: opäť, 500 GB sa nemusí dať vydá za hodinu. Preto je lepšie obrázky skopírovať hneď. Redis: toto je zaujímavejšie. Relácie sa ukladajú v Redise – nemôžeme to len tak zakopať. Pretože by to nebolo veľmi dobré: všetci používatelia by boli odhlásení, košíky by sa vyprázdnili atď. Ľudia by boli nútení znova zadávať svoje používateľské meno a heslo a mnohí ľudia by mohli odísť a nedokončiť nákup. Opäť by klesla konverzia. Na druhej strane, Redis, ktorý je úplne aktuálny s najnovšie prihlásenými používateľmi, je pravdepodobne tiež zbytočný. Dobrým kompromisom je vziať Redis a obnoviť ho zo zálohy, buď včerajšej, alebo, ak máte zálohu každú hodinu, spred hodiny. Našťastie, obnova zo zálohy je len kopírovanie jedného súboru. A najzaujímavejší príbeh je Elasticsearch. Nastavil už niekto replikáciu MySQL? Nastavil už niekto replikáciu Elasticsearch? A fungovala odvtedy správne? Chcem tým povedať, že v našom systéme vidíme určitú entitu. Zdá sa to užitočné, ale je to zložité.
Je to zložité v tom zmysle, že naši kolegovia inžinieri s tým nemajú žiadne skúsenosti. Alebo majú negatívne skúsenosti. Alebo chápeme, že je to stále pomerne nová technológia s nuansami a stále neúplná. Myslíme si... Sakra, elastic je tiež obrovský a jeho obnova zo zálohy tiež trvá dlho, čo by sme mali robiť? Chápeme, že v tomto prípade sa elastic používa na vyhľadávanie. Ale ako sa náš internetový obchod predáva? Ideme za marketérmi a pýtame sa, odkiaľ ľudia prichádzajú. Odpovedajú: „90 % ľudí z Yandex Marketu prichádza priamo na kartu produktu.“ A buď kúpia, alebo nie. Preto 10 % používateľov potrebuje vyhľadávanie. A udržiavanie elastic replikácie, najmä medzi rôznymi dátovými centrami v rôznych zónach – tam je naozaj veľa nuans. Aké je riešenie? Nainštalujeme elastic na redundantnú stránku a nič s ňou nerobíme. Ak sa to bude naťahovať, možno ho raz spustíme, ale to nie je isté. V podstate záver zostáva viac-menej rovnaký: opäť si nerezervujeme služby, ktoré neovplyvňujú peniaze. Aby bol systém jednoduchý.
Príklad číslo štyri, ešte zložitejší
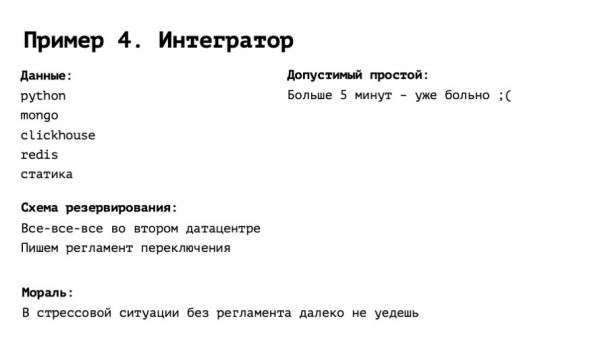
Integrátor: predaj kvetov, objednávanie taxíkov, predaj tovaru – v podstate čokoľvek. Je to seriózny softvér, ktorý beží 24 hodín denne, 7 dní v týždni pre veľký počet používateľov. Má plnohodnotný a zaujímavý balík so zaujímavými databázami a riešeniami a zvláda vysokú záťaž, ale čo je najdôležitejšie, je nepríjemné nechať ho stáť dlhšie ako päť minút. Nielen preto, že si ho ľudia nekúpia, ale aj preto, že uvidia, že je pokazený, nahnevajú sa a možno sa vôbec neobjaví.
Dobre. Päť minút. Čo s tým urobíme? V tomto prípade vybudujeme skutočnú záložnú lokalitu, plne financovanú, s plnou replikáciou a možno dokonca čo najviac automatizujeme prepnutie na túto lokalitu pri zlyhaní. A okrem toho si musíme pamätať jednu dôležitú vec: skutočne napísať protokol pre prepnutie pri zlyhaní. Protokol, aj keď ste všetko automatizovali, môže byť veľmi jednoduchý. Niečo ako „spustiť tento skript Ansible“, „zaškrtnúť toto políčko na trase 53“ atď. – ale mal by to byť presný zoznam akcií.
A všetko sa zdá byť jasné. Prepínanie replikácie je triviálna úloha, inak sa prepne sama. Prepísanie názvu domény v DNS je rovnaký príbeh. Problém je v tom, že keď sa takýto projekt zrúti, nastáva panika a aj tí najskúsenejší administrátori môžu byť náchylní na ňu. Bez jasných pokynov typu „otvorte terminál, choďte sem, adresa nášho servera je stále táto“ je ťažké dodržať päťminútovú dobu obnovy. Navyše, keď používame túto politiku, je ľahké napríklad odhaliť akékoľvek zmeny v infraštruktúre a podľa toho politiku upraviť.
No, ak je zálohovací systém veľmi zložitý a v určitom okamihu urobíme chybu, môžeme zrútiť našu zálohovaciu stránku a navyše sa dáta na oboch stránkach premenia na tekvicu – to by bolo naozaj smutné.
Príklad číslo päť, full hardcore
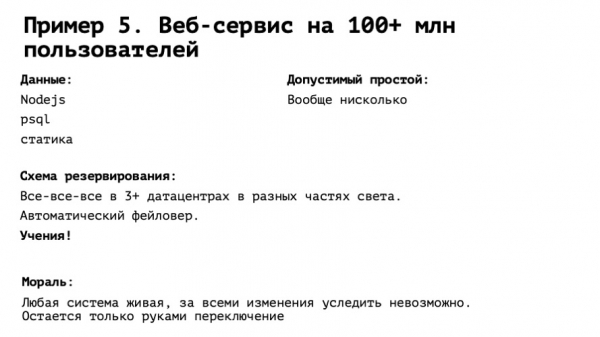
Medzinárodná služba so stovkami miliónov používateľov po celom svete. Všetky možné časové pásma, vysoká záťaž na maximálnych nastaveniach a absolútne žiadne prestoje. Minúta a bude to mizerné. Čo robiť? Znova zálohovať v plnom rozsahu. Urobili sme všetko, čo som spomenul v predchádzajúcom príklade, a ešte niečo navyše. Je to dokonalý svet a naša infraštruktúra je IaaC podľa všetkých štandardov DevOps. To znamená, že všetko je v Gite a stačí stlačiť tlačidlo.
Čo chýba? Jedna vec – školenie. Bez neho sa nezaobídeme. Zdá sa, že všetko je perfektné, máme všetko pod kontrolou. Stlačíme tlačidlo a všetko sa stane. Aj keď je to pravda – a chápeme, že to tak vždy nie je – náš systém interaguje s inými systémami. Napríklad DNS z Route 53, úložisko S3, integrácia s niektorými API. V tomto teoretickom experimente nedokážeme predvídať všetko. A kým skutočne nestlačíme prepínač, nebudeme vedieť, či to bude fungovať alebo nie.
To je asi všetko. Nebuďte leniví a nepreháňajte to. A nech vás sprevádza dostupnosť!
Zdroj: hab.com
