

Od roku 2008 sa naša spoločnosť zameriava predovšetkým na správu infraštruktúry a technickú podporu webových projektov 24 hodín denne, 7 dní v týždni. Máme viac ako 400 klientov, čo predstavuje približne 15 % ruského trhu elektronického obchodu. V dôsledku toho podporujeme veľmi rozmanitú architektúru. Ak sa niečo pokazí, sme povinní to opraviť do 15 minút. Aby sme však skutočne pochopili, že sa vyskytol problém, musíme projekt monitorovať a reagovať na incidenty. Ako to však urobíme?
Myslím si, že je problém s nastavením správneho monitorovacieho systému. Ak by problém neexistoval, moja ponuka by bola jedno jednoduché vyhlásenie: „Prosím, nainštalujte si Prometheus + Grafana a pluginy 1, 2, 3.“ Bohužiaľ, takto to už nefunguje. A hlavný problém je, že všetci stále veria v niečo, čo existovalo v roku 2008, čo sa týka softvérových komponentov.
Čo sa týka organizácie monitorovacieho systému, dovolím si tvrdiť, že... projekty s riadnym monitorovaním neexistujú. A situácia je taká zlá, že ak sa niečo pokazí, existuje riziko, že si to nevšimneme – koniec koncov, všetci sú presvedčení, že „všetko je monitorované“.
Možno je všetko monitorované. Ale ako?
Všetci sme sa už stretli s takýmto príbehom: člen DevOps tímu a administrátor pracujú na niečom a príde k nim tím vývojárov a povie: „Vydali sme to, teraz to monitorujte.“ Čo tým myslíte, monitorujte to? Ako to funguje?
Dobre. Monitorujeme to staromódnym spôsobom. Ale už sa to mení a ukázalo sa, že ste monitorovali službu A, ktorá sa stala službou B, ktorá interaguje so službou C. Vývojový tím vám však povie: „Nainštalujte si softvér; mal by monitorovať všetko!“
Tak čo sa zmenilo? - Všetko sa zmenilo!
2008. Všetko je v poriadku.
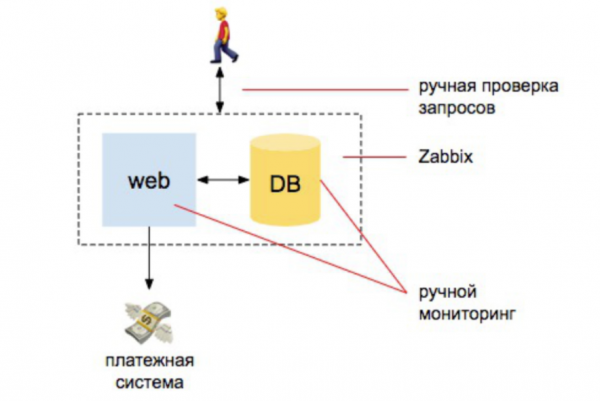
Je tu pár vývojárov, jeden server, jeden databázový server. Tam to všetko začína. Máme nejaké informácie, nainštalujeme Zabbix, Nagios a Cacti. Potom nastavíme jasné upozornenia na CPU, aktivitu disku a miesto na disku. Vykonáme aj niekoľko manuálnych kontrol, aby sme sa uistili, že webová stránka reaguje a že sa do databázy prijímajú objednávky. A to je všetko – sme viac-menej chránení.
V porovnaní s množstvom práce, ktorú administrátor v tom čase vykonával na zabezpečenie monitorovania, bolo 98 % automatizovaných: monitorujúca osoba musela rozumieť inštalácii Zabbixu, jeho konfigurácii a nastaveniu upozornení. A 2 % boli určené na externé kontroly: zabezpečenie odpovede stránky, dotazovanie databázy a zabezpečenie prijatia nových objednávok.
2010. Pracovná záťaž rastie.
Začíname rozširovať web a pridávať vyhľadávač. Chceme si byť istí, že katalóg produktov obsahuje všetky produkty a že vyhľadávanie produktov funguje. Že databáza funguje, že objednávky sa spracovávajú, že stránka reaguje externe a v oboch smeroch. serverov a používateľ nie je vyhodený zo stránky počas jej presúvania na iný server atď. Počet entít sa zvyšuje.
Navyše, problém súvisiaci s infraštruktúrou zostáva v mysli manažéra najväčším problémom. Stále pretrváva predstava, že za monitorovanie je zodpovedná osoba, ktorá inštaluje a konfiguruje Zabbix.
Zároveň sa však pracuje na vykonávaní externých kontrol, na vytvorení sady skriptov dotazov pre indexovanie vyhľadávania, sady skriptov na kontrolu, či sa vyhľadávanie počas procesu indexovania mení, sady skriptov, ktoré kontrolujú, či sa tovar prenáša do doručovacej služby atď.
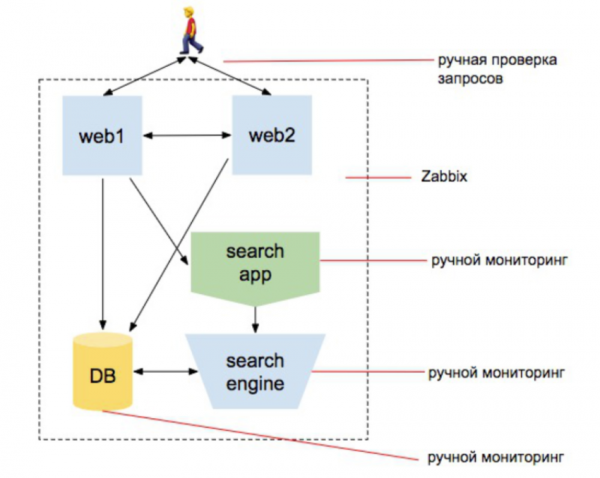
Poznámka: „Súbor skriptov“ som napísal trikrát. To znamená, že osoba zodpovedná za monitorovanie už nie je tá, ktorá len inštaluje Zabbix. Je to tá, ktorá začína kódovať. Ale v hlavách tímu sa zatiaľ nič nezmenilo.
Svet sa však mení, stáva sa čoraz komplexnejším. Pridáva sa virtualizačná vrstva a niekoľko nových systémov. Začínajú navzájom interagovať. Kto povedal, že „to vonia ako mikroslužby“? Ale každá služba, braná samostatne, stále vyzerá ako webová stránka. Môžeme k nej pristupovať a pochopiť, že poskytuje potrebné informácie a funguje nezávisle. A ak ste administrátor, neustále pracujete na projekte, ktorý sa vyvíja už 5-7-10 rokov, zhromažďujete tieto vedomosti: objaví sa nová úroveň – rozpoznáte ju, objaví sa ďalšia úroveň – rozpoznáte ju...
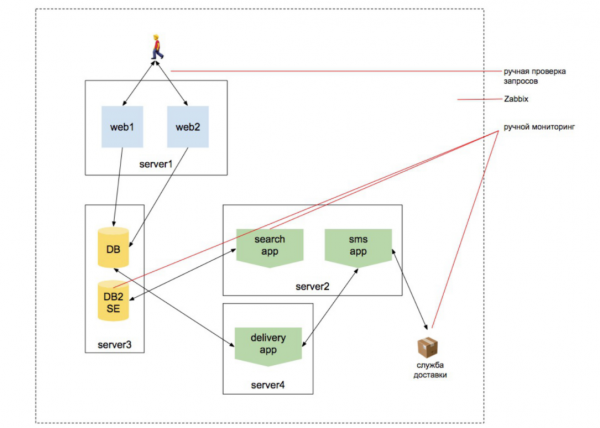
Ale je zriedkavé, aby niekto sledoval projekt 10 rokov.
Monitorovanie životopisu muža
Povedzme, že ste sa pridali k novému startupu, ktorý okamžite najal 20 vývojárov, napísal 15 mikroslužieb a vy ste administrátor, a oni vám povedia: „Vytvorte CI/CD. Prooooool.“ Vytvorili ste CI/CD a zrazu počujete: „Máme problém pracovať s produkciou v „kocke“ bez toho, aby sme pochopili, ako v nej bude aplikácia fungovať. Vytvorte nám sandbox v tej istej „kocke“.“
V tejto kocke vytvoríte sandbox. Okamžite vám povedia: „Chceme databázu fáz, ktorá sa denne aktualizuje z produkcie, aby sme videli, čo v databáze funguje, ale bez toho, aby sme narušili produkčnú databázu.“
V tomto všetkom žijete. Dva týždne pred vydaním vám povedia: „Teraz už len musím toto všetko monitorovať...“ To znamená monitorovať infraštruktúru klastra, monitorovať architektúru mikroservisov, monitorovať prácu s externými službami...
A moji kolegovia vytiahnu z hlavy túto známu schému a povedia: „Tu je všetko jasné! Nainštalujte si program, ktorý to všetko bude monitorovať.“ Áno, áno: Prometheus + Grafana + pluginy.
A dodávajú: „Máte dva týždne, uistite sa, že je všetko v bezpečí.“
V mnohých projektoch, ktoré vidíme, je monitorovanie pridelené jednej osobe. Predstavte si, že chceme niekoho najať na dva týždne, aby sa staral o monitorovanie, a zostavujeme životopis. Aké zručnosti by mala táto osoba mať vzhľadom na všetko, čo sme doteraz prediskutovali?
- Musí rozumieť monitorovaniu a špecifikám prevádzky železnej infraštruktúry.
- Musí rozumieť špecifikám monitorovania Kubernetes (a každý chce byť v „kocke“, pretože sa môže od všetkého abstrahovať, schovať, pretože administrátor sa postará o zvyšok) – samotného, jeho infraštruktúry a rozumieť tomu, ako monitorovať aplikácie vo vnútri.
- Musia pochopiť, že služby medzi sebou komunikujú špecifickými spôsobmi a musia byť oboznámení so špecifikami toho, ako interagujú. Je úplne možné vidieť projekt, kde niektoré služby komunikujú synchrónne, pretože neexistuje iný spôsob. Napríklad backend používa REST, gRPC na prístup k katalógovej službe, načíta zoznam produktov a vráti ich. Tu sa nečaká. A pri iných službách to funguje asynchrónne. Odoslanie objednávky doručovacej službe, odoslanie e-mailu atď.
Pravdepodobne sa z toho všetkého už cítite trochu zahltení? A administrátor, ktorý by to mal monitorovať, je ešte viac. - Musí byť schopný plánovať a správne plánovať – pretože práce je čoraz viac.
- Preto musia vytvoriť stratégiu zo služby, ktorú vytvorili, aby pochopili, ako ju konkrétne monitorovať. Potrebujú pochopiť architektúru projektu a jeho vývoj, ako aj technológie používané pri vývoji.
Spomeňme si na úplne bežný prípad: niektoré služby sú napísané v PHP, niektoré v Go a niektoré v JS. Nejako medzi sebou interagujú. Odtiaľ pochádza termín „mikroslužba“: existuje toľko samostatných systémov, že vývojári nedokážu pochopiť projekt ako celok. Jedna časť tímu píše služby v JS, ktoré fungujú nezávisle a nevedia, ako funguje zvyšok systému. Ďalšia časť píše služby v Pythone a nezasahuje do fungovania ostatných služieb; sú izolované vo svojej vlastnej doméne. Tretia časť píše služby v PHP alebo v niečom inom.
Všetkých 20 ľudí je rozdelených do 15 služieb a existuje iba jeden administrátor, ktorý tomu všetkému musí rozumieť. Počkajte! Systém sme práve rozdelili do 15 mikroslužieb, pretože 20 ľudí nedokáže rozumieť celému systému.
Ale treba to nejako monitorovať...
Aký je konečný výsledok? Konečným výsledkom je, že existuje jedna osoba, ktorá dokáže pochopiť všetko, čo celý tím vývojárov nedokáže, a zároveň musí vedieť a byť zdatný vo všetkom, čo sme spomenuli vyššie – hardvérovej infraštruktúre, infraštruktúre Kubernetes atď.
Čo môžem povedať... Houston, máme problém.
Monitorovanie moderného softvérového projektu je samo o sebe softvérovým projektom.
Mylná predstava, že monitorovanie je softvér, nás vedie k viere v zázraky. Ale zázraky sa, žiaľ, nedejú. Nemôžete si nainštalovať Zabbix a očakávať, že všetko bude fungovať. Nemá zmysel inštalovať Grafanu a dúfať, že všetko bude v poriadku. Väčšinu času strávite organizovaním kontrol prevádzky služieb a ich interakcií, kontrolou fungovania externých systémov. V skutočnosti sa 90 % času nestrávi písaním skriptov, ale vývojom softvéru. A to by mal robiť tím, ktorý projektu rozumie.
Ak bude jedna osoba poverená monitorovaním tejto situácie, nastane katastrofa. A to sa deje všade.
Napríklad existuje niekoľko služieb, ktoré medzi sebou komunikujú cez Kafku. Objednávka príde a my o nej pošleme správu do Kafky. Existuje služba, ktorá počúva informácie o objednávke a odošle tovar. Ďalšia služba počúva informácie o objednávke a pošle e-mail používateľovi. A potom sa objaví kopa ďalších služieb a my začneme byť zmätení.
A ak to odovzdáte administrátorovi a vývojárom tesne pred vydaním, budú musieť pochopiť celý protokol. To znamená, že projekt tohto rozsahu si vyžaduje značné množstvo času a to sa musí zohľadniť pri vývoji systému.
Ale veľmi často, najmä v startupoch v zhone, vidíme, že monitorovanie sa odkladá na neskôr. „Teraz vytvoríme Proof of Concept, spustíme ho, necháme ho zlyhávať – sme ochotní to obetovať. A potom to budeme všetko monitorovať.“ Keď (alebo ak) projekt začne zarábať peniaze, firma chce vytvoriť ešte viac funkcií – pretože funguje, takže ich musí neustále pridávať! Ale ste v bode, keď musíte najprv monitorovať všetko, čo bolo predtým, čo zaberá výrazne viac ako 1 % času. A mimochodom, monitorovanie si vyžaduje vývojárov a je jednoduchšie ich prinútiť pracovať na nových funkciách. Výsledkom je, že sa napíšu nové funkcie, všetko sa vytvorí a vy uviaznete v nekonečnej slepej uličke.
Ako teda monitorovať projekt od začiatku a čo by ste mali robiť, ak vám bol pridelený projekt, ktorý je potrebné monitorovať, a neviete, kde začať?
Najprv si musíte naplánovať.
Malá odbočka: ľudia často začínajú s monitorovaním infraštruktúry. Napríklad máme Kubernetes. Začneme inštaláciou Prometheus a Grafana a potom nainštalujeme pluginy na monitorovanie „kocky“. Nielen vývojári, ale aj administrátori majú tento nešťastný zvyk: „Nainštalujeme si tento plugin a plugin pravdepodobne vie, ako na to.“ Ľudia majú tendenciu začínať s jednoduchými a priamočiarymi akciami, a nie s tými najdôležitejšími. A monitorovanie infraštruktúry je jednoduché.
Najprv sa rozhodnite, čo a ako chcete monitorovať, a potom si vyberte nástroj, pretože iní ľudia za vás myslieť nemôžu. A mali by? Iní ľudia premýšľali sami za seba, o univerzálnom systéme – alebo vôbec nemysleli, keď písali tento doplnok. A len preto, že tento doplnok má 5 000 používateľov, neznamená to, že je užitočný. Môžete sa stať 5 001. len preto, že ho už 5 000 ľudí používa.
Ak ste začali monitorovať svoju infraštruktúru a backend vašej aplikácie prestane reagovať, všetci používatelia stratia pripojenie k mobilnej aplikácii. Zobrazí sa chyba. Niekto za vami príde a povie: „Aplikácia nefunguje, čo robíte?“ – „Monitorujeme.“ – „Ako môžete monitorovať, keď nevidíte, že aplikácia nefunguje?!“
- Myslím si, že monitorovanie by malo začať od vstupného bodu používateľa. Ak používateľ nevidí, že aplikácia funguje, je to koniec, je to chyba. A monitorovací systém by ho na to mal v prvom rade upozorniť.
- Až potom môžeme monitorovať infraštruktúru. Alebo to robiť paralelne. S infraštruktúrou je to jednoduchšie – potom môžeme konečne nainštalovať Zabbix.
- A teraz sa musíte pozrieť na koreň aplikácie, aby ste pochopili, kde niečo nefunguje.
Mojím hlavným argumentom je, že monitorovanie by malo prebiehať súbežne s procesom vývoja. Ak rozptýlite monitorovací tím od iných úloh (vytváranie CI/CD, sandboxov, reorganizácia infraštruktúry), monitorovanie začne zaostávať a možno nikdy nedobehnete vývoj (alebo ho budete musieť skôr či neskôr zastaviť).
Všetko je v úrovniach
Takto vidím organizáciu monitorovacieho systému.
1) Úroveň aplikácie:
- monitorovanie obchodnej logiky aplikácie;
- monitorovanie zdravotných metrík služieb;
- monitorovanie integrácie.
2) Úroveň infraštruktúry:
- monitorovanie úrovne orchestrácie;
- monitorovanie systémového softvéru;
- monitorovanie na úrovni hardvéru.
3) Opäť úroveň aplikácie - ale tentoraz ako inžiniersky produkt:
- zhromažďovanie a monitorovanie aplikačných protokolov;
- APM;
- trasovanie.
4) Upozornenie:
- organizácia varovného systému;
- organizácia systému povinností;
- organizácia „vedomostnej bázy“ a pracovného postupu pre riešenie incidentov.
Je to dôležité,K upozorneniam sa dostávame hneď, nie neskôr! Nie je potrebné spúšťať monitorovanie a potom zisťovať, kto bude dostávať upozornenia „niekedy neskôr“. Cieľom monitorovania je koniec koncov pochopiť, kde v systéme niečo nefunguje správne, a upozorniť správnych ľudí. Ak to necháte na koniec, správni ľudia zistia, že niečo nie je v poriadku, až keď počujú „tu nič nefunguje“.
Aplikačná vrstva - monitorovanie obchodnej logiky
Hovoríme tu o overení samotnej skutočnosti, že aplikácia pre používateľa funguje.
Táto vrstva by mala byť implementovaná počas fázy vývoja. Napríklad máme hypotetického Prometheusa: pristupuje k serveru, ktorý spracováva kontroly, načíta koncový bod a koncový bod skontroluje API.
Keď ľudia často žiadajú o monitorovanie hlavnej stránky, aby sa uistili, že web funguje, programátori im dajú prístupový kód, ktorý môžu použiť vždy, keď potrebujú skontrolovať, či API funguje. Medzitým programátori jednoducho zadajú /api/test/helloworld.
Jediný spôsob, ako zabezpečiť, aby všetko fungovalo? - Nie!
- Vytváranie takýchto kontrol je v podstate úlohou vývojárov. Jednotkové testy by mali písať programátori, ktorí píšu kód. Pretože ak to napíšete administrátorovi: „Kámo, tu je zoznam API protokolov pre všetkých 25 funkcií, prosím, monitoruj ich všetky!“ – nič sa nestane.
- Ak vypíšete „ahoj svet“, nikto sa nikdy nedozvie, že API má fungovať a skutočne funguje. Každá zmena API by mala znamenať zmeny v kontrolách.
- Ak už máte problémy, zastavte funkcie a poverte vývojárov, aby tieto kontroly napísali, alebo akceptujte straty a zmierte sa s tým, že nič sa nekontroluje a systém zlyhá.
Technické tipy:
- Nezabudnite si nastaviť externý server pre audity – musíte si byť istí, že váš projekt je prístupný vonkajšiemu svetu.
- Organizujte testovanie v celom API protokole, nielen v jednotlivých koncových bodoch.
- Vytvorte prometheus-endpoint s výsledkami kontroly.
Úroveň aplikácie – monitorovanie metrík stavu
Teraz hovoríme o externých metrikách zdravia služieb.
Rozhodli sme sa monitorovať všetky „handlery“ aplikácií pomocou externých kontrol volaných z externého monitorovacieho systému. Sú to však len „handlery“, ktoré používateľ „vidí“. Chceme si byť istí, že naše samotné služby fungujú. Toto je lepší príbeh: K8s má kontroly stavu, takže aspoň samotná „kocka“ môže overiť, či služba beží. Ale polovica kontrol, ktoré som videl, je stále tá istá stará správa „hello world“. Takže sa to spustí raz po nasadení a systém odpovie, že všetko je v poriadku – a to je všetko. Ale služba, ak interne sprístupní svoje API, má obrovské množstvo vstupných bodov API, ktoré je tiež potrebné monitorovať, pretože chceme vedieť, či funguje. A my to monitorujeme interne.
Správny spôsob, ako to technicky implementovať, je nasledovný: každá služba sprístupní koncový bod, ktorý indikuje jej aktuálny stav, a v grafoch Grafany (alebo akejkoľvek inej aplikácie) vidíme stav všetkých služieb.
- Každá zmena API musí viesť k zmene kontrol.
- Okamžite vytvorte novú službu s metrikami stavu.
- Administrátor môže osloviť vývojárov a požiadať ich, aby „pridali niekoľko funkcií, aby som všetkému rozumel a pridal o nich informácie do svojho monitorovacieho systému“. Vývojári však zvyčajne odpovedia: „Dva týždne pred vydaním nebudeme nič pridávať.“
Dajte vedieť manažérom rozvoja, že k takýmto stratám dôjde, a dajte o tom vedieť aj ich nadriadeným. Pretože keď sa niečo pokazí, niekto stále zavolá a bude požadovať monitorovanie „neustále zlyhávajúcej služby“. (c) - Mimochodom, prosím, poverte vývojárov písaním pluginov pre Grafanu – to bude pre administrátorov veľká pomoc.
Aplikačná vrstva – monitorovanie integrácie
Monitorovanie integrácie sa zameriava na monitorovanie komunikácie medzi systémami kritickými pre podnikanie.
Napríklad existuje 15 služieb, ktoré medzi sebou komunikujú. Už to nie sú samostatné webové stránky. To znamená, že nemôžeme len tak spustiť službu, získať /helloworld a vedieť, že funguje. Pretože webová služba na spracovanie objednávok musí odoslať informácie o objednávke do zbernice – odtiaľ musí služba správy skladu túto správu prijať a ďalej ju spracovať. A služba distribúcie e-mailov ju musí ďalej spracovať atď.
Preto nemôžeme zistiť, či všetko funguje, skúmaním každej jednotlivej služby. Pretože máme nejakú zbernicu, cez ktorú všetko komunikuje a interaguje.
Preto by sa táto fáza mala definovať ako testovanie interakcií služieb s inými službami. Komunikáciu nemožno monitorovať monitorovaním sprostredkovateľa správ. Ak existuje služba, ktorá vytvára dáta, a služba, ktorá ich prijíma, monitorovanie sprostredkovateľa bude sledovať iba prenos dát tam a späť. Aj keby sa nám nejako podarilo monitorovať interné interakcie týchto dát – že producent odosiela dáta, niekto ich číta a tento tok naďalej prúdi do Kafky – stále nám to nepovie, či jedna služba odoslala správu v jednej verzii, zatiaľ čo iná služba túto verziu neočakávala a preskočila ju. Nebudeme o tom vedieť, pretože služby nám povedia, že všetko funguje.
Ako to odporúčam urobiť:
- Pri synchrónnej komunikácii koncový bod odosiela požiadavky do súvisiacich služieb. To znamená, že vezmeme tento koncový bod, spustíme skript v rámci služby, ktorý ide do všetkých koncových bodov a hovorí: „Môžem spustiť toto a môžem spustiť tamto, môžem spustiť tamto...“
- Pre asynchrónnu komunikáciu: prichádzajúce správy - koncový bod kontroluje zbernicu, či neobsahuje testovacie správy, a vracia stav spracovania.
- Pre asynchrónnu komunikáciu: odchádzajúce správy – koncový bod odosiela testovacie správy do zbernice.
Zvyčajne to funguje takto: máme službu, ktorá vkladá dáta do zbernice. Oslovíme túto službu a požiadame ju o správu o stave jej integrácie. A ak služba potrebuje niekde ďalej (webová aplikácia) vygenerovať správu, tak vygeneruje túto testovaciu správu. A ak spustíme službu na strane spracovania objednávok, najprv uverejní to, čo môže nezávisle uverejniť, a ak existujú nejaké závislé veci, tak prečíta sadu testovacích správ zo zbernice, pochopí, že ich môže spracovať, nahlásiť to a v prípade potreby ich uverejniť ďalej a toto je to, čo povie: všetko je v poriadku, som nažive.
Často počúvame otázku: „Ako to môžeme otestovať na výrobných dátach?“ Zoberme si napríklad objednávkovú službu. Objednávka posiela správy do skladu, kde sa produkty odpisujú. Na výrobných dátach to nemôžeme otestovať, pretože „moje produkty budú odpísané!“ Riešenie: naplánovať celý tento test od začiatku. Máte jednotkové testy, ktoré spúšťajú simulácie. Takže to robte na hlbšej úrovni, kde máte komunikačný kanál, ktorý nenaruší vaše podnikanie.
Úroveň infraštruktúry
Monitorovanie infraštruktúry sa už dlho považuje za monitorovanie samotné.
- Monitorovanie infraštruktúry môže a malo by prebiehať ako samostatný proces.
- Nezačínajte monitorovaním infraštruktúry na živom projekte, aj keď naozaj chcete. Toto je bežné úskalie všetkých DevOps profesionálov. „Najprv budem monitorovať klaster, potom infraštruktúru“ – čo znamená, že budú monitorovať, čo je pod ním, ale nebudú sa zaoberať aplikáciou. Pretože aplikácia je pre DevOps profesionálov cudzí koncept. Dostali ju a nerozumejú, ako funguje. Rozumejú však infraštruktúre a začínajú s ňou. Ale nie – vždy musíte najprv monitorovať aplikáciu.
- Nepreháňajte to s upozorneniami. Vzhľadom na zložitosť moderných systémov neustále prichádzajú upozornenia a vy sa musíte s touto záplavou upozornení vyrovnať. A pohotovostná osoba sa po zhliadnutí stoviek upozornení rozhodne: „Nechcem na to myslieť.“ Upozornenia by vás mali informovať iba o kritických problémoch.
Aplikačná vrstva ako obchodná jednotka
Kľúčové body:
- ELK. Je to priemyselný štandard. Ak z nejakého dôvodu neagregujete protokoly, začnite s tým okamžite.
- APM. Externé APM sú spôsobom, ako rýchlo vypnúť monitorovanie aplikácií (NewRelic, BlackFire, Datadog). Môžete ich dočasne nainštalovať, aby ste aspoň získali prehľad o tom, čo sa deje.
- Sledovanie. Pri desiatkach mikroslužieb by ste mali sledovať všetko, pretože požiadavky už samy o sebe neexistujú. Je veľmi ťažké k nim neskôr niečo pridať, takže je najlepšie plánovať sledovanie vo vývoji od začiatku – je to úloha a nástroj vývojára. Ak ste to ešte neimplementovali, urobte to! Pozri Jaeger/Zipkin
Upozornenie
- Organizácia systému upozornení: Pri monitorovaní množstva vecí je potrebný jednotný systém upozornení. Grafana je dobrou voľbou. Na Západe každý používa PagerDuty. Upozornenia by mali byť jasné (napríklad odkiaľ pochádzajú...). A je tiež dobrý nápad zabezpečiť, aby boli upozornenia skutočne doručené.
- Zorganizujte si rozpis služieb: upozornenia by nemali byť prijímané univerzálne (buď všetci zareagujú hromadne, alebo nikto). Vývojári musia byť tiež v pohotovosti: nezabudnite definovať oblasti zodpovednosti, vytvoriť jasné pokyny a špecifikovať, komu volať v pondelok a stredu a komu volať v utorok a piatok (inak nikomu nezavolajú ani v prípade vážnej núdze – budú sa báť zobudiť ich alebo ich vyrušiť: ľudia vo všeobecnosti neradi volajú a budia ostatných, najmä v noci). Vysvetlite, že žiadosť o pomoc nie je znakom neschopnosti („Žiadam o pomoc, to znamená, že som zlý pracovník“); povzbudzujte žiadosti o pomoc.
- Zorganizujte znalostnú základňu a pracovný postup pre riešenie incidentov: pre každý závažný incident by sa mala naplánovať analýza po incidente a ako dočasné opatrenie by sa mali zaznamenať opatrenia na jeho vyriešenie. A zaveďte prax, že opakované upozornenia sú hriechom; mali by sa opraviť v kóde alebo v prácach na infraštruktúre.
Zásobník technológií
Predstavme si, že náš zásobník vyzerá takto:
- zber údajov — Prometheus + Grafana;
- analýza protokolov - ELK;
- pre APM alebo sledovanie - Jaeger (Zipkin).

Výber možností nie je kritický. Ak ste si najprv ujasnili, ako monitorovať systém a načrtli plán, môžete začať vyberať nástroje, ktoré vyhovujú vašim potrebám. Otázkou je, čo sa rozhodnete monitorovať ako prvé. Pretože nástroj, ktorý ste si pôvodne vybrali, nemusí byť vôbec vhodný pre vaše potreby.
V poslednej dobe vidím všade niekoľko technických problémov:
Prometheus je natlačený do Kubernetes – kto prišiel s týmto nápadom?! Čo urobíte, ak váš klaster zlyhá? Ak máte zložitý klaster, mali by ste mať nejaký monitorovací systém spustený vo vnútri klastra a ďalší mimo neho, ktorý zhromažďuje údaje zvnútra klastra.
Vnútri klastra zhromažďujeme protokoly a všetko ostatné. Monitorovací systém však musí byť externý. Klaster s interne nainštalovaným Promtheusom má často aj systémy, ktoré vykonávajú externé kontroly výkonu lokality. Čo ak sú vaše pripojenia k vonkajšiemu svetu nefunkčné a aplikácia nefunguje? Interne sa teda zdá byť všetko v poriadku, ale to používateľom nijako neuľahčuje prácu.
Závery
- Vývoj monitorovania nie je o inštalácii nástrojov, ale o vývoji softvérového produktu. 98 % dnešného monitorovania je kódovanie. Kódovanie služieb, kódovanie externých kontrol, kontrola externých služieb a všetko medzi tým.
- Nešetrite časom vývojárov venovaným monitorovaniu: môže to zabrať až 30 % ich práce, ale stojí to za to.
- DevOps, nebojte sa, že niečo nedokážete monitorovať, pretože niektoré veci si vyžadujú úplne iný spôsob myslenia. Neboli ste programátori a monitorovanie je presne to – ich práca.
- Ak projekt už beží a nie je monitorovaný (a ste manažér), vyčlente zdroje na monitorovanie.
- Ak je produkt už v produkcii a ste DevOps, ktorému bolo povedané, aby si „nastavil monitoring“, skúste vedeniu vysvetliť, o čom som písal.
Toto je rozšírená verzia prednášky z konferencie Saint Highload++.
Ak vás zaujímajú moje myšlienky a postrehy k tejto téme a súvisiacim témam, môžete ????
Zdroj: hab.com
