

TL; DR: JSONB môže významne zjednodušiť návrh schémy databázy bez negatívneho dopadu na výkon pri dotazoch.
Úvod
Uveďme klasický príklad, pravdepodobne jedného z najstarších spôsobov použitia vo svete relačných databáz (databáza): máme entitu a potrebujeme uložiť určité vlastnosti (atribúty) tejto entity. Ale nie všetky inštancie môžu mať rovnakú množinu vlastností, navyše v budúcnosti je možné pridať ďalšie vlastnosti.
Najjednoduchší spôsob, ako túto otázku vyriešiť, je vytvorenie stĺpca v tabuľke databázy pre každú hodnotu vlastnosti a jednoducho vyplniť tie, ktoré sú potrebné pre konkrétnu inštanciu entity. Výborne! Problém je vyriešený... do chvíle, kým vaša tabuľka neobsahuje milióny záznamov a nezjaví sa potreba pridať nový záznam.
Zvážme vzor EAV (), ktorý sa často vyskytuje. Jedna tabuľka obsahuje entity (záznamy), druhá tabuľka obsahuje mená vlastností (atribútov), a treťa tabuľka prepojuje entity s ich atribútmi a obsahuje hodnoty týchto atribútov pre aktuálnu entitu. To vám umožňuje mať rôzne množiny vlastností pre rôzne objekty a tiež pridávať vlastnosti „za behu“, bez zmeny štruktúry databázy.
Napriek tomu by som o tejto poznámke nepísal, keby neexistovali nevýhody prístupu využívajúceho EVA. Napríklad na získanie jednej alebo viacerých entít, ktoré majú 1 atribút, sú potrebné 2 JOIN-y (zlučovania) v dotaze: prvý – zlučovanie s tabuľkou atribútov, druhý – zlučovanie s tabuľkou hodnôt. Ak má entita 2 atribúty, už potrebujete 4 JOIN-y! Okrem toho sa všetky atribúty zvyčajne uchovávajú ako reťazce, čo vedie k typovému prevodu, ako pre výsledok, tak aj pre podmienku WHERE. Ak píšete veľa dotazov, je to dosť plytvanie, pokiaľ ide o využitie zdrojov.
Napriek týmto evidentným nevýhodám sa EAV už dlho používa na riešenie takýchto problémov. Boli to nevyhnutné nevýhody a lepšia alternatíva jednoducho neexistovala.
Ale potom sa v PostgreSQL objavila nová „technológia“…
Od verzie PostgreSQL 9.4 bol pridaný typ dát JSONB na uchovávanie binárnych dát JSON. Hoci uloženie JSON v tomto formáte obvykle zaberá o niečo viac miesta a času ako jednoduchý textový JSON, vykonávanie operácií s ním je oveľa rýchlejšie. JSONB tiež podporuje indexovanie, čo ešte viac urýchľuje dotazy.
Typ dát JSONB nám umožňuje nahradiť objemný vzor EAV pridaním len jedného stĺpca JSONB do našej tabuľky entít, čo výrazne zjednoduší návrh databázy. Mnohí však tvrdia, že to môže viesť k zníženiu výkonu… Z tohto dôvodu vznikol tento článok.
Nastavenie testovacej databázy
Pre toto porovnanie som vytvoril databázu na novej inštalácii PostgreSQL 9.5 na zostave za 80 dolárov. Ubuntu 14.04. Po nastavení niektorých parametrov v postgresql.conf som spustil skript pomocou psql. Pre predstavenie dát vo forme EAV boli vytvorené nasledujúce tabuľky:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Nižšie je tabuľka, kde budú uchovávané tie isté dáta, ale s atribútmi v stĺpci typu JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Vyzerá to omnoho jednoduchšie, že? Potom bolo do tabuliek entít (entity & entity_jsonb) pridaných 10 miliónov záznamov a rovnako boli naplnené rovnakými dátami tabuľky, kde sa používa vzor EAV a prístup so stĺpcom JSONB – entity_jsonb.properties. Týmto spôsobom sme získali niekoľko rôznych typov dát medzi celým súborom vlastností. Príklad dát:
{
  id:          1
  name:        "Entity1"
  description: "Testovacia entita č. 1"
  properties:  {
    color:        "červená"
    length:       120
    width:        3.1882420
    hassomething: true
    country:      "Belgicko"
  }
}
Takže teraz máme rovnaké dáta pre dva varianty. Poďme začať porovnávať implementácie v praxi!
Zjednodušenie dizajnu
Už bolo spomenuté, že dizajn DB bol výrazne zjednodušený: jedna tabuľka, vďaka používaniu stĺpca JSONB pre vlastnosti, namiesto troch tabuliek pre EAV. Ako sa to však odráža v dotazoch? Aktualizácia jedného atribútu entity vyzerá nasledovne:
-- EAV
UPDATE entity_attribute_value
SET value = 'blue'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"blue"')
WHERE id = 120;
Ako vidíme, posledný dotaz nevyzerá jednoduchšie. Aby sme aktualizovali hodnotu vlastnosti v objekte JSONB, musíme použiť funkciu , a musíme odovzdať našu novú hodnotu ako objekt JSONB. Napriek tomu nemusíme vedieť žiadny identifikátor vopred. Pri pohľade na príklad s EAV potrebujeme poznať aj entity_id, aj entity_attribute_id, aby sme mohli vykonať aktualizáciu. Ak chcete aktualizovať vlastnosť v stĺpci JSONB na základe mena objektu, – to všetko sa robí jedným jednoduchým riadkom.
Teraz si vyberme tú entitu, ktorú sme práve aktualizovali, na základe jej novej farby:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'blue';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'blue';
Myslím, že sa môžeme zhodnúť na tom, že druhé je kratšie (bez join!), a preto aj čitateľnejšie. Tu vyhráva JSONB! Používame operátor JSON ->>, aby sme získali farbu ako textovú hodnotu z objektu JSONB. Existuje aj druhý spôsob, ako dosiahnuť ten istý výsledok v modeli JSONB pomocou operátora @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "blue"}';
To je trochu zložitejšie: kontrolujeme, či objekt JSON v stĺpci vlastností obsahuje objekt, ktorý sa nachádza napravo od operátora @>. Menej čitateľné, ale výkonnější (pozri ďalej).
Zjednodušme používanie JSONB ešte viac, keď potrebujete vybrať viac vlastností naraz. Tu sa naozaj hodí prístup JSONB: jednoducho vyberáme vlastnosti ako ďalšie stĺpce v našej sadzbe výsledkov bez potreby joinov:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
S EAV budete potrebovať 2 joiny pre každú vlastnosť, ktorú chcete dotazovať. Podľa môjho názoru uvedené dotazy ukazujú veľké zjednodušenie v dizajne databázy. Viac príkladov, ako písať dotazy na JSONB, možno nájsť tiež v príspevku.
Teraz je čas hovoriť o výkonnosti.
Výkon
Aby sme porovnali výkonnosť, použil som v dopytoch na výpočet času vykonania. Každý dopyt bol vykonaný aspoň trikrát, pretože plánovač dopytov potrebuje viac času na prvý pokus. Najprv som vykonal dopyty bez akýchkoľvek indexov. Je zrejmé, že to bolo výhodou JSONB, keďže pripojenia potrebné pre EAV nemohli využívať indexy (polia cudzích kľúčov neboli indexované). Potom som vytvoril index na 2 stĺpce cudzích kľúčov v tabuľke hodnôt EAV, ako aj index pre stĺpec JSONB.
Aktualizácie údajov ukázali nasledujúce výsledky v čase (v ms). Všimnite si, že škála je logaritmická:
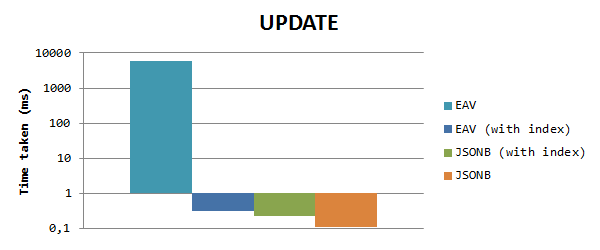
Vidíme, že JSONB je oveľa (> 50000-krát) rýchlejší ako EAV, ak sa indexy nepoužívajú, z dôvodu uvedeného vyššie. Keď indexujeme stĺpce s primárnymi kľúčmi, rozdiel takmer zmizne, ale JSONB je stále 1,3-krát rýchlejší ako EAV. Majte na pamäti, že index v stĺpci JSONB tu nemá žiadny vplyv, pretože nepoužívame stĺpec vlastností v hodnotiacich kritériách.
Pre výber údajov na základe hodnoty vlastnosti dostávame nasledujúce výsledky (bežná škála):
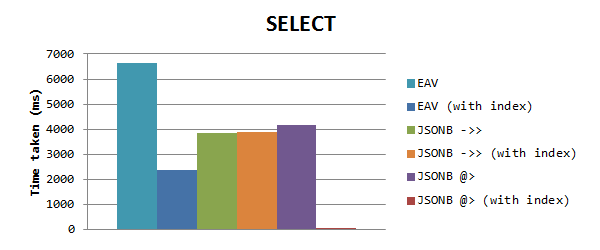
Môžeme si všimnúť, že JSONB znova funguje rýchlejšie ako EAV bez indexov, ale keď EAV má indexy, stále funguje rýchlejšie ako JSONB. Potom som si všimol, že čas pre dopyty JSONB bol rovnaký, čo ma priviedlo k zisteniu, že GIN-index nefunguje. Zjavne, keď používate index GIN pre stĺpec so zaplnenými vlastnosťami, funguje to iba pri použití operátora prítomnosti @>. Použil som to v novom teste, čo malo obrovský dopad na čas: iba 0,153 ms! To je 15000-krát rýchlejšie ako EAV a 25000-krát rýchlejšie ako operátor ->>
Myslím, že to bolo dosť rýchle!
Veľkosť tabuliek DB
Porovnajme veľkosti tabuliek pri oboch prístupoch. V psql môžeme zobraziť veľkosť všetkých tabuliek a indexov pomocou príkazu dti+
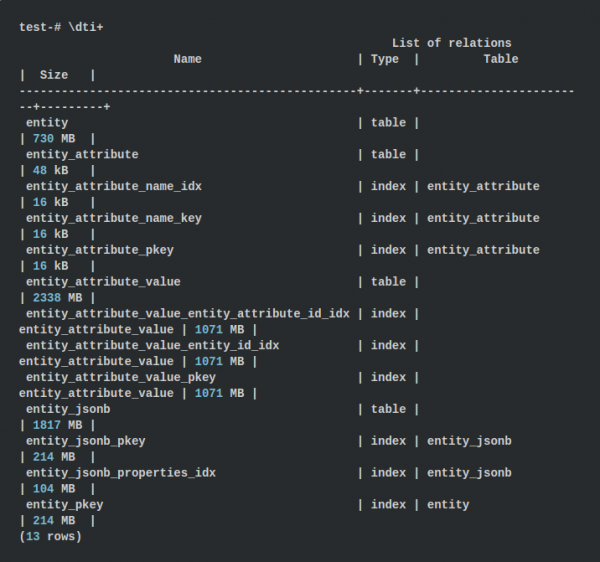
Pre prístup EAV sú veľkosti tabuliek približne 3068 MB a indexy až 3427 MB, čo v súčte dáva 6,43 GB. Pri použití prístupu s JSONB sa používa 1817 MB pre tabuľku a 318 MB pre indexy, čo predstavuje 2,08 GB. To je trikrát menej! Tento fakt ma trochu prekvapil, pretože uchovávame názvy vlastností v každom objekte JSONB.
Ale predsa čísla hovoria sama za seba: v EAV uchovávame 2 celé čísla ako externé kľúče na hodnotu atribútu, čo vedie k dodatočným 8 bajtom dát. Okrem toho, v EAV sú všetky hodnoty vlastností uložené ako text, zatiaľ čo JSONB používa číselné a logické hodnoty tam, kde je to možné, čím sa dosiahne menší objem.
Zhrnutie
Celkovo si myslím, že uchovávanie vlastností entít vo formáte JSONB môže výrazne zjednodušiť návrh a údržbu vašej databázy. Ak vykonávate veľa dotazov, všetko, čo je uložené v jednej tabuľke s entitou, bude skutočne fungovať efektívnejšie. A to, že to zjednodušuje interakciu medzi údajmi, je už plusom, ale aj výsledná databáza je trikrát menšia z objemu.
Tiež, podľa vykonaného testu, je možné urobiť záver, že straty výkonu sú veľmi nepatrné. V niektorých prípadoch JSONB dokonca funguje rýchlejšie ako EAV, čo ho robí ešte lepším. Avšak tento referenčný test samozrejme nezahŕňa všetky aspekty (napríklad entity s veľmi veľkým počtom vlastností, významným zvýšením počtu vlastností existujúcich údajov...), preto, ak máte nejaké návrhy na ich zlepšenie, neváhajte zanechať komentáre!
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish