

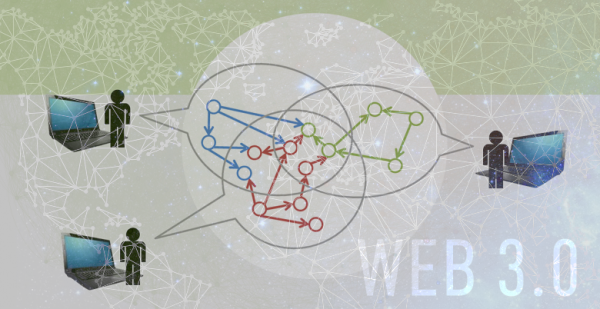
Myšlienku nevyhnutnosti prechodu globálnej siete zo štruktúry zameranej na lokalitu na štruktúru zameranú na používateľa som vyjadril už v roku 2012 ( alebo v skrátenej forme ). Tento rok som sa v texte snažil rozvinúť tému nového internetu Teraz zverejňujem druhú časť článku. (Odporúčam vám, aby ste si túto stránku pred prečítaním prečítali).
Takže, o čo ide? Vo webe 3.0 existuje internet, ale žiadne webové stránky? Tak čo tam je?
Dáta sú usporiadané do globálneho sémantického grafu: všetko je prepojené so všetkým ostatným, všetko z niečoho vyplýva, všetko si niekto konkrétny všimol, zmenil alebo vytvoril. Posledné dva body o „mal by“ a „niekto“ nám pripomínajú, že graf by nemal byť založený na objektoch, ale na subjektoch a udalostiach. Ale to bude na samostatný príbeh (pozri úvodnú časť). ). Zatiaľ nám stačí pochopiť, že sémantický graf webu 3.0 nie je statická sada vedomostí, ale je časový a zaznamenáva vzťahy objektov a aktérov akejkoľvek činnosti v ich časovej postupnosti.
Pri diskusii o dátovej vrstve treba tiež poznamenať, že globálny graf je nevyhnutne rozdelený na dve nerovnaké časti: modelový strom opisujúci vzťahy medzi akciami, konceptmi a ich vlastnosťami (zodpovedajúci súboru terminologických axiómov TBox v OWL) a graf predmetov obsahujúci udalosti zaznamenávajúce špecifické hodnoty vlastností vecí a akcií (súbor tvrdení o jednotlivcoch ABox v OWL). Medzi týmito dvoma časťami grafu je vytvorený vzťah jedna k jednej: údaje o jednotlivcoch – teda o konkrétnych veciach, akciách a aktéroch – je možné formovať a zapisovať do grafu iba a výlučne podľa zodpovedajúcich modelov. A ako už bolo spomenuté, globálny graf – predovšetkým jeho modelová časť a podľa toho aj jeho predmetová časť – je prirodzene rozdelený na segmenty podľa tematických oblastí.
Teraz, keď sa posunieme od sémantiky a dát, môžeme prejsť k diskusii o druhom prívlastku Webu 3.0 – „decentralizovaný“ – teda k popisu siete. A je zrejmé, že štruktúra siete a jej protokoly by mali byť diktované tou istou sémantikou. V prvom rade, keďže používateľ je generátorom a spotrebiteľom obsahu, je logické, že používateľ, alebo skôr používateľovo zariadenie, by malo byť uzlom siete. Web 3.0 je teda peer-to-peer sieť, ktorej uzlami sú používateľove zariadenia.
Na uloženie údajov do grafu, napríklad popisu jednotlivca, musí používateľ vygenerovať sieťovú transakciu na základe existujúceho konceptuálneho modelu. Údaje sú uložené na zariadení používateľa a na uzloch ostatných používateľov, ktorí sú prihlásení k odberu tohto modelu. Výmenou transakcií v rámci pevnej sady modelov, na ktorých je implementovaná ich spoločná činnosť, teda účastníci tejto činnosti tvoria viac či menej autonómny klaster. Celý globálny sémantický graf je teda uložený distribuovane v rámci predmetových klastrov a decentralizovane v rámci klastrov. Každý uzol, pracujúci s určitými modelmi, môže patriť do viacerých klastrov.
Pri popise sieťovej vrstvy je potrebné stručne rozobrať konsenzus – princípy overovania a synchronizácie údajov medzi rôznymi uzlami, ktoré sú nevyhnutné pre fungovanie decentralizovanej siete. Je zrejmé, že tieto princípy nemusia byť rovnaké pre všetky klastre a všetky údaje, pretože transakcie v sieti môžu byť právne významné aj čisto servisné. Sieť preto implementuje niekoľko vrstiev konsenzuálnych algoritmov a výber vhodného z nich je určený transakčným modelom.
Ešte pár slov o používateľskom rozhraní, sémantickom prehliadači. Jeho funkcie sú triviálne: (1) navigácia v grafoch (podľa predmetových klastrov), (2) vyhľadávanie a zobrazovanie údajov na základe doménových modelov, (3) vytváranie, úprava a odosielanie sieťových transakcií na základe zodpovedajúcich modelov, (4) písanie a vykonávanie dynamických akčných modelov a samozrejme (5) ukladanie fragmentov grafov. Tento stručný popis funkcií sémantického prehliadača odpovedá na otázku: kde sa nachádzajú webové stránky? Jediné miesto, ktoré používateľ v sieti Web 3.0 „navštívi“, je jeho sémantický prehliadač, ktorý je nástrojom na zobrazovanie aj vytváranie akéhokoľvek obsahu a akýchkoľvek údajov vrátane modelov. Používateľ určuje hranice a formu zobrazenia svojho online sveta, ako aj hĺbku prenikania do sémantického grafu.
To je pochopiteľné, ale kde sú tie webové stránky? Kam mám ísť, akú adresu mám zadať do toho „sémantického prehliadača“, aby som sa dostal na Facebook? Ako nájdem webovú stránku firmy? Kde si môžem kúpiť tričko alebo pozrieť video kanál? Skúsme to zistiť na konkrétnych príkladoch.
Prečo potrebujeme Facebook alebo inú sociálnu sieť? Samozrejme, na komunikáciu: aby sme sa podelili o niečo o sebe, čítali a videli, čo uverejňujú ostatní, a vymieňali si komentáre. Je však kľúčové, aby sme nepísali každému alebo nečítali všetko – komunikácia je vždy obmedzená na desiatky, stovky alebo dokonca tisíce virtuálnych priateľov. Čo je potrebné na organizáciu takejto komunikácie v rámci opísanej decentralizovanej konfigurácie siete? Správne: vytvoriť komunitný klaster so sadou štandardných akčných modelov (uverejniť príspevok, poslať správu, komentovať, dať lajk atď.), nakonfigurovať prístupové práva k týmto modelom a pozvať ostatných používateľov, aby sa prihlásili na odber tejto sady. To je pre nás Facebook. Nie globálny Facebook diktujúci podmienky každému, ale prispôsobiteľná lokálna sociálna sieť, ktorá je úplne k dispozícii členom klastra. Používateľ odošle transakciu do siete prostredníctvom jedného z komunitných modelov, povedzme komentár. Členovia klastra prihlásení na odber tohto modelu dostanú text komentára a uložia ho do svojho úložiska (pridajú ho k fragmentu grafu domény) a zobrazia ho vo svojich sémantických prehliadačoch. Inými slovami, máme decentralizovanú sociálnu sieť (klaster) pre skupinovú komunikáciu, pričom všetky údaje sú uložené na zariadeniach používateľov. Môžu byť tieto údaje viditeľné pre používateľov mimo klastra? Toto je otázka nastavení prístupu. Ak je udelené povolenie, obsah členov komunity môže čítať softvérový agent a prezentovať sa v prehliadači kohokoľvek, kto prehľadáva graf. Treba tiež poznamenať, že počet a zložitosť modelov klastrov sú neobmedzené – ktokoľvek si môže komunitu prispôsobiť potrebám akejkoľvek aktivity. A samozrejme, používatelia môžu byť členmi ľubovoľného počtu klastrov, buď ako aktívni účastníci, alebo jednoducho prihlásením sa na odber jednotlivých modelov iba na čítanie.
Teraz si poďme odpovedať na otázku: ako nájdeme webovú stránku spoločnosti? Odpoveď je jednoduchá: miesto, kde sa nachádzajú komplexné údaje o všetkých spoločnostiach, je zodpovedajúci sektor sémantického grafu. Na toto miesto sa dá dostať pomocou navigácie v prehliadači alebo vyhľadávaním podľa názvu spoločnosti. Odtiaľ je na používateľovi, aby sa rozhodol, ktoré modely zobrazenia údajov požaduje: stručnú prezentáciu, úplné informácie, zoznam služieb, zoznam voľných pracovných miest alebo formulár správy. Inými slovami, na reprezentáciu spoločnosti v sémantickom grafe by mala použiť sadu štandardných modelov na odosielanie transakcií do siete a jej údaje budú okamžite k dispozícii na vyhľadávanie a zobrazenie. Ak potrebujete prispôsobiť a rozšíriť online prezentáciu spoločnosti, môžete si vytvoriť vlastné modely vrátane vlastných. Neexistujú tu žiadne obmedzenia, okrem jedného: nové modely musia byť integrované do jedného stromu, aby sa zabezpečila súdržnosť údajov v predmetovom grafe.
Pre elektronický obchod je možné aj triviálne riešenie. Každý produkt (mobilný telefón, tričko) má jedinečný identifikátor a výrobca zadá údaje o produkte do siete. Prirodzene, urobí to iba raz a údaje podpíše svojím súkromným kľúčom. Spoločnosť, ktorá je ochotná tento produkt predať, umiestni do sémantického grafu niekoľko vyhlásení o cene a dodacích podmienkach, vytvorených pomocou štandardného modelu. Každý používateľ sa potom sám rozhodne, či bude vyhľadávať medzi produktmi dostupnými od známeho predajcu, alebo porovná podobné produkty od rôznych výrobcov a až potom si vyberie vhodného dodávateľa. Takže opäť miestom, kde dochádza k výberu a nákupu produktu, je sémantický prehliadač používateľa, nie webová stránka nejakého výrobcu alebo predajcu. Samozrejme, výrobca aj predajca majú možnosť vytvoriť si vlastné modely zobrazenia produktu, ktoré môže kupujúci použiť, ak sa mu to páči, ak to považuje za vhodné. Inak môžu všetko robiť pomocou štandardných modelov vyhľadávania a zobrazenia údajov.
Za zmienku stojí reklama a jej miesto v sémantickej sieti. Jej umiestnenie zostáva tradičné: buď priamo v obsahu (napríklad vo videách), alebo v modeloch zobrazenia obsahu. Eliminuje sa však sprostredkovateľ medzi inzerentmi a vlastníkmi obsahu alebo modelu zobrazenia v podobe vlastníka webovej stránky.
Schéma fungovania sémantickej decentralizovanej siete, prezentovaná z pozície používateľa, je teda mimoriadne unifikovaná: (1) všetok obsah je umiestnený v jednom globálnom sémantickom grafe, (2) zaznamenávanie, vyhľadávanie a zobrazovanie obsahu prebieha podľa modelov konceptov, ktoré zabezpečujú sémantickú koherenciu údajov, (3) aktivita používateľa sa realizuje podľa dynamických modelov, (4) jediným miestom, kde k aktivite dochádza, je sémantický prehliadač používateľa.
Zdroj: hab.com
