

Iskanje funkcionalnih odvisnosti v podatkih se uporablja v različnih področjih analize podatkov: upravljanje z bazo podatkov, čiščenje podatkov, reverzno inženirstvo baz podatkov in raziskovanje podatkov. O samih odvisnostih smo že objavili Anastazije Birillo in Nikite Bobrova. Tokrat Anastazija — letošnja diplomantka Computer Science Center — deli napredovanje te naloge v okviru NIR, ki jo je zagovarjala v centru.
Izbira naloge
Med študijem v CS centru sem začela poglobljeno raziskovati baze podatkov, zlasti iskanje funkcionalnih in razlikovnih odvisnosti. Ta tema je bila povezana z temo moje seminarske naloge na univerzi, tako da sem med delom na seminarski začela brati članke o različnih odvisnostih v bazah podatkov. Napisala sem pregled tega področja — eno svojih prvih v angleščini in jo predložila na konferenco SEIM-2017. Bila sem zelo vesela, ko sem izvedela, da so jo sprejeli, in sem se odločila poglobiti v to temo. Sama koncept ni nov — začeli so ga uporabljati že v devetdesetih letih, a se še danes uporablja na mnogih področjih.
V drugem semestru študija v centru sem začela znanstveno-raziskovalni projekt za izboljšanje algoritmov iskanja funkcionalnih odvisnosti. Na njem sem delala skupaj s podiplomskim študentom SPbGU Nikito Bobrovim na osnovi JetBrains Research.
Računska zahtevnost iskanja funkcionalnih odvisnosti
Glavni problem — računska zahtevnost. Število možnih minimalnih in netrivialnih odvisnosti je zgoraj omejeno z vrednostjo  , gde
 — število atributov tabele. Čas delovanja algoritmov se ne meri le glede na število atributov, temveč tudi glede na število vrstic. V devetdesetih letih so algoritmi za iskanje FZ na običajnih namiznih računalnikih lahko obdelovali podatkovne nize, ki vsebujejo do 20 atributov in deset tisoč vrstic, do več ur. Sodobni algoritmi, ki delujejo na večjedrnih procesorjih, odkrivajo odvisnosti za podatkovne nize, sestavljene iz stotin atributov (do 200) in stotin tisoč vrstic, približno v istem času. Kljub temu to ni dovolj: tak čas je nesprejemljiv za večino realnih aplikacij. Zato smo razvijali pristope za pospeševanje obstoječih algoritmov.
Sheme predpomnjenja za presečišča particij
V prvem delu dela smo razvili sheme predpomnenja za razred algoritmov, ki uporabljajo metodo preseka particij. Particija za atribut predstavlja niz seznamov, kjer vsak seznam vsebuje številke vrstic z enakimi vrednostmi za dani atribut. Vsak tak seznam se imenuje klaster. Mnogi sodobni algoritmi uporabljajo particije za določanje, ali se odvisnost ohranja ali ne, in sicer sledijo tezi: Odvisnost  se ohranja, če
 . Tukaj
 je označena particija in uporablja se pojem velikosti particije — število klastrov v njej. Algoritmi, ki uporabljajo particije, ob kršenju odvisnosti dodajajo dodatne atribute v levo stran odvisnosti, po čemer ponovno izračunajo, pri čemer izvajajo operacijo preseka particij. Takšna operacija se v člankih imenuje specializacija. Vendar smo opazili, da se lahko particije za odvisnosti, ki bodo ohranjene šele po več krogih specializacije, aktivno ponovno uporabijo, kar lahko znatno zmanjša čas delovanja algoritmov, saj je operacija preseka draga.
Zato smo predlagali heuristiko, ki temelji na Shannonovi entropiji in Ginijevi negotovosti, ter naši metriki, ki smo jo poimenovali Obračuna Entropija. Ta predstavlja nepomembno modifikacijo Shannonove entropije in narašča, ko narašča edinstvenost nabora podatkov. Predlagana heuristika izgleda takole:

Tukaj  — stopnja edinstvenosti nedavno izračunane particije
 , a
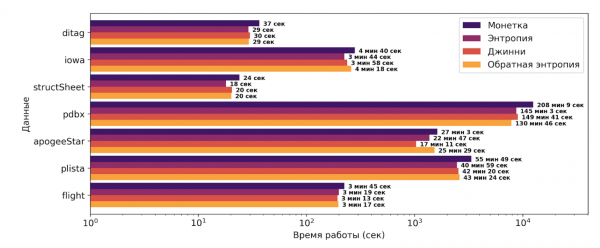
 je mediane stopnje edinstvenosti za posamezne atribute. V kot metrika edinstvenosti so bile preizkušene vse tri metrike, opisane zgoraj. Prav tako je opaziti, da v heuristiki obstajata dva modifikatorja. Prvi označuje, kako blizu je trenutna particija k primarnemu ključu in omogoča večje predpomnjenje tistih particij, ki so oddaljene od potencialnega ključa. Drugi modifikator omogoča sledenje zasedenosti predpomnilnika in s tem stimulira dodajanje večjega števila particij v predpomnilnik, ko je na voljo prost prostor. Uspešno reševanje te naloge je omogočilo pospešitev algoritma PYRO za 10-40% glede na nabor podatkov. Omeniti je treba, da je algoritem PYRO najbolj uspešen na tem področju.
Na spodnji sliki so prikazani rezultati uporabe predlagane heuristike v primerjavi z osnovnim pristopom k predpomnjenju, ki temelji na metodi vrženja kovančka. Os X je logaritmična.
Alternativen način shranjevanja particij
Nato smo predlagali alternativen način shranjevanja particij. Particije predstavljajo niz grozdov, v katerih so shranjene številke tupljev z enakimi vrednostmi za določene atribute. Ti grozdi lahko vsebujejo dolge zaporedja številk tupljev, na primer, če so podatki v tabeli razporejeni. Zato smo predlagali shemo stiskanja za shranjevanje particij, in sicer intervalno shranjevanje vrednosti v grozdih particij:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Prvi~interval}, underbrace{7, 8}_{Drugi~interval}, 10}}\ downarrow{Stiskanje}\ pi(X) = {{underbrace{$, 1, 5}_{Prvi~interval}, underbrace{7, 8}_{Drugi~interval}, 10}}$$display$$
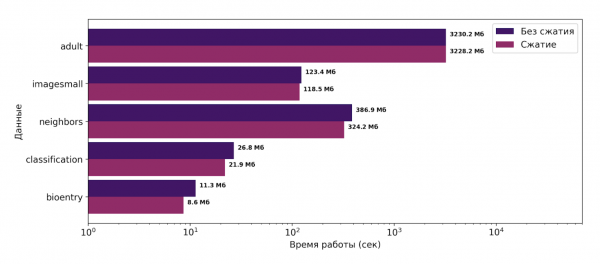
Ta metoda je lahko zmanjšala porabo pomnilnika med delovanjem algoritma TANE za 1 do 25%. Algoritem TANE je klasičen algoritem za iskanje FZ, ki med delovanjem uporablja particije. V okviru praktikum je bil izbran prav algoritem TANE, saj je bilo veliko lažje v njega vključiti intervalno shranjevanje kot na primer v PYRO, da bi ocenili, ali predlagani pristop deluje. Pridobljeni rezultati so prikazani na spodnji sliki. Os X je logaritmična.
Konferenca ADBIS-2019
Na podlagi raziskave septembra 2019 sem nastopila s člankom na konferenci 23. Evropska konferenca o naprednih podatkovnih in informacijskih sistemih (ADBIS-2019). Med nastopom je delo pohvalil Bernhard Thalheim, pomembna oseba na področju podatkovnih baz. Rezultati raziskav so postali osnova moje magistrske naloge na matematično-fizikalni fakulteti Univerze v Sankt Peterburgu, v okviru katere sta bila oba predlagana pristopa (predpomnjenje in stiskanje) vključen v oba algoritma: TANE in PYRO. Rezultati so pokazali, da sta predlagana pristopa univerzalna, saj je bilo pri obeh algoritmih pri obeh pristopih opazno znatno zmanjšanje porabe pomnilnika ter znatno skrajšanje časa delovanja algoritmov.
Izvor: habr.com
