

Otázka "ako zaviesť devops" sa rieši už niekoľko rokov, ale dobrých materiálov nie je veľa. Niekedy sa stanete obeťou reklamy nie až tak inteligentných konzultantov, ktorí potrebujú predať svoj čas, bez ohľadu na to, ako. Niekedy sú to nejasné, veľmi všeobecné slová o tom, ako lode megakorporácií brázdia nekonečné moria. Vzniká otázka: a čo nám z toho vyplýva? Vážený autor, môžete jasne formulovať svoje myšlienky v zozname?
Všetko to pochádza z toho, že skutočnej praxe a porozumenia výsledku transformácie kultúry spoločnosti nazbieralo nie tak veľa. Zmeny v kultúre sú dlhodobé veci, ktorých výsledky sa neprejavia do týždňa či do mesiaca. Potrebujeme niekoho dostatočne skúseného, kto videl, ako sa spoločnosti vytvárali a rozpadali počas mnohých rokov.
John Willis — jeden z otcov DevOps. Na pleciach Johna sú desiatky rokov práce s obrovským množstvom spoločností. V poslednej dobe sa John začal sám trápiť špecifickými vzormi, ktoré sa prejavujú pri práci s každou z nich. Používaním týchto archetypov John usmerňuje spoločnosti na pravú cestu DevOps transformácie. Podrobnejšie o týchto archetypoch - v preklade jeho prednášky z konferencie DevOops 2018.
O rečníkovi:
Viac ako 35 rokov v IT manažmente, zúčastnil sa na vytvorení predchodcu OpenCloud v Canonical, podieľal sa na 10 startupoch, z ktorých dva predal spoločnostiam Dell a Docker. Teraz je viceprezidentom pre DevOps a digitálne praktiky v SJ Technologies.
Ďalej - rozprávanie z pohľadu Johna.
Volám sa John Willis a najjednoduchšie ma nájdete na Twitteri, . Ten istý pseudonym mám na Gmaile a GitHube. A môžete nájsť videonahrávky mojich prednášok a prezentácií k nim.
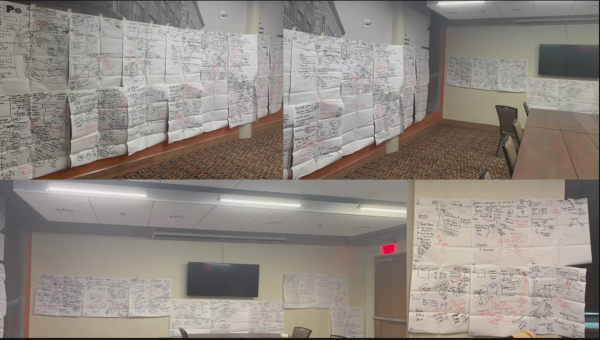
Imam veliko sestankov z CIO-ji različnih velikih podjetij. Pogosto se pritožujejo, da ne razumejo, kaj je DevOps, in vsi, ki jim to poskušajo razložiti, govorijo o nečem svojem. Druga pogosta pritožba je, da DevOps ne deluje, čeprav se zdi, da direktorji vse delajo tako, kot so jih poučili. Govorimo o velikih podjetjih, starosti več kot sto let. Po pogovorih z njimi sem prišel do zaključka, da za mnoge težave bolj ustrezajo ne visoke tehnologije, ampak razmeroma nizkotehnološke rešitve. Tedne sem se preprosto pogovarjal z ljudmi iz različnih oddelkov. To, kar vidite na prvi sliki v objavi, je moj zadnji projekt; prostor je tako izgledal po treh dneh dela.
Kaj je DevOps?
Dejansko, če vprašate 10 različnih ljudi, bodo dali 10 različnih odgovorov. A kaj je zanimivo: vsi ti odgovori bodo pravilni. Napačnega odgovora tukaj ni. Dolgo sem se ukvarjal z DevOps, približno 10 let, in bil prvi Američan na prvem DevOpsDay. Ne bom rekel, da sem pametnejši od vseh, ki se ukvarjajo z DevOps, vendar verjetno ni nikogar, ki bi porabil toliko truda. Menim, da DevOps nastane, ko se združita človeški kapital in tehnologija. Pogosto pozabimo na človeški vidik, čeprav veliko govorimo o raznih kulturah.
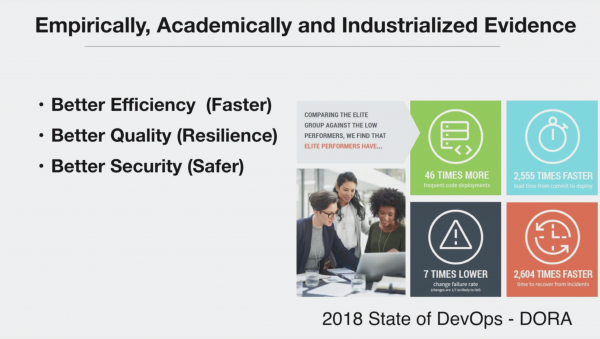
Zdaj imamo na voljo veliko podatkov, pet let akademskih raziskav, preverjanje teorij pa je vzpostavljeno v industrijskem merilu. Te raziskave nam pravijo naslednje: če v organizacijski kulturi združimo nekatere vedenjske vzorce, lahko dosežemo pospešek do 2000-krat. Ta pospešek ustreza enakemu izboljšanju v odpornosti. To je kvantitativno merjenje tiste prednosti, ki jo lahko DevOps prinese kateremu koli podjetju. Pred nekaj leti sem govoril o DevOps generalnemu direktorju podjetja iz seznama Fortune 5000. Ko sem se pripravljal na predstavitev, sem bil zelo nervozen, ker sem moral v 5 minutah strniti svoje dolgoletne izkušnje.
Na koncu sem dal naslednjo definicijo DevOps: to je niz praks in vzorcev, ki omogočajo pretvorbo človeškega kapitala v visoko učinkoviti organizacijski kapital. Primer: to, kako Toyota deluje zadnjih 50 ali 60 let.
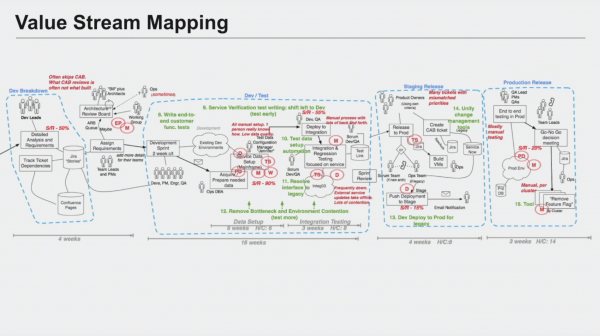
(Tukaj in nadalje so takšne sheme predstavljene ne kot referenčni material, temveč kot ilustracija. Njihova vsebina se bo razlikovala za vsako novo podjetje. Kljub temu pa si je sliko mogoče posebej ogledati in povečati
Ena izmed najbolj uspešnih takih praks je — mapiranje vrednostnega toka. O tem je napisanih nekaj dobrih knjig, najbolj uspešna avtorica med njimi je Karen Martin. Vendar sem v preteklem letu prišel do zaključka, da je tudi ta pristop preveč visoko tehnološki. Ne glede na to, da ima številne prednosti, sem ga veliko uporabljal. Toda ko generalni direktor vpraša, zakaj njegovo podjetje ne more preiti na nove tirnice, o mapiranju vrednostnega toka še ni čas za pogovor. Obstaja veliko precej bolj temeljnih vprašanj, na katera je treba najprej najti odgovore.
Zdi se mi, da je napaka mnogih mojih kolegov ta, da preprosto podajo podjetju vodnik s petimi točkami in se nato vrnejo čez šest mesecev in pogledajo, kaj se je zgodilo. Tudi dobra shema, kot je mapiranje vrednostnega toka, ima, recimo temu, mrtve cone (blind spots). Po stotinah intervjujev z različnimi podjetniškimi direktorji sem razvil določen vzorec, ki omogoča razdelitev problema na sestavne dele, in zdaj bomo posebej obravnavali vsako od teh komponent. Preden uporabim kakršna koli tehnološka rešitev, uporabljam ta vzorec, in rezultat so stene, polne shem. Nedavno sem delal z enim vzajemnim skladom, in na koncu sem imel 100-150 takšnih shem.
Slaba kultura poje dobre pristope za zajtrk
Glavna misel je takšna: nobeni Lean, Agile, SAFE in DevOps ne bodo pomagali, če je sama kultura organizacije slaba. To je tako, kot bi potapljal v globino brez jeklenke ali operiral brez rentgenskega posnetka. Z drugimi besedami, parafrazirajoč Druckerja in Deminga: slaba poslovna kultura bo požrla vsak dober sistem in se ne zadušila.
Da bi rešili ta glavni problem, je treba sprejeti naslednje korake:
- Oscirajte vso delo: je treba vso delo vidno. Ne v smislu, da mora biti nujno prikazano na kakšnem ekranu, temveč v smislu, da mora biti opazno.
- Konsolidirajte sisteme upravljanja dela: potrebno je konsolidirati menadžerske sisteme. U problemu 'plemenskog' znanja i institucionalnog znanja u 9 od 10 slučajeva usko mesto su ljudi. U knjizi problem je bio u jednom jedinom čoveku, Brentu, zbog koga je projekat bio u zaostatku od tri godine. I na takve 'Brente' naiđem svuda. Za razrešenje ovih uskih mesta koristim sledeće dve tačke u našem spisku.
- Theory of Constraints Methodology: teorija ograničenja.
- Collaboration hacks: hackovi saradnje.
- Toyota Kata (): o Toyota Kata neću mnogo govoriti. Ako vas zanima, na mom GitHubu gotovo o svakoj od ovih tema.
- Market Oriented Organization: organizacija orijentisana na tržište.
- Shift-left auditors: audit u ranim fazama ciklusa.
Početak rada s organizacijom je veoma jednostavan: idem u kompaniju i razgovaram s zaposlenima. Kao što vidimo, nema visokih tehnologija. Sve što je potrebno je da imam na čemu da pišem. Okupljam nekoliko timova u jednoj sobi i analiziram ono što mi govore, iz perspektive mojih 7 arhetipova. Zatim im dajem marker i molim ih da izlože na tabli sve što su do sada govorili naglas. Obično naovakvim sastancima postoji jedna osoba koja sve beleži, i u najboljem slučaju ona uspe da zabeleži 10% diskusije. Mojom metodom ovaj procenat uspevam da podignem na otprilike 40%.
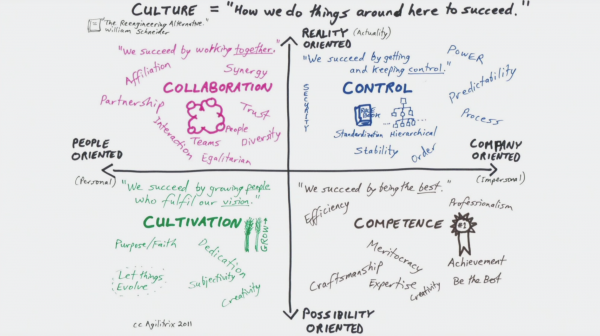
(Ovu ilustraciju možete )
Moj pristup se zasniva na radu Williama Schneidera (William Schneider, ). U osnovi pristupa je misao da svaku organizaciju možemo razložiti na četiri kvadrata. Ova šema mi obično predstavlja rezultat rada s onih stotinama drugih šema koje se javljaju prilikom analize organizacije. Pretpostavimo da imamo organizaciju s visokim nivoom kontrole, ali sa niskom kompetencijom. Ovo je izuzetno neželjena situacija: kada svi hodaju po čeličnim žicama, ali niko ne zna šta treba da radi.
Malce boljša izbira s visokim nivojem nadzora in kompetenc. Če ima podjetje dobiček, morda DevOps sploh ni potreben. Najbolj zanimivo je delati s podjetjem, ki ima visok nivo nadzora, nizko kompetenco in sodelovanje, ob tem pa visoko kulturo (cultivation). To pomeni, da je v podjetju veliko ljudi, ki radi delajo tam, fluktuacija delovne sile je nizka.
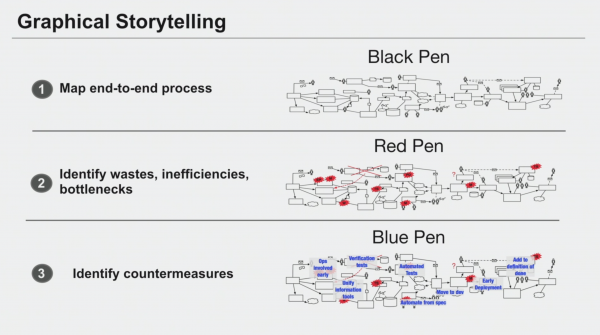
(Ovu ilustraciju možete )
Zdi se mi, da metode z strogimi priporočili na koncu otežijo dosego resnice. Zlasti pri vrednostnem toku je veliko pravil o tem, kako naj bo struktura informacij. V zgodnjih fazah dela, o katerih govorim, ta pravila nikomur niso potrebna. Če oseba z markerjem v roki opisuje na tabli dejansko stanje v podjetju – to je najboljši način, da razumemo položaj. Te informacije ne pridejo do direktorjev. V tem trenutku je nesmiselno prekinjati osebo in reči, da je narobe narisala puščico. V tej fazi je bolje uporabiti preprosta pravila, na primer: večstopenjsko abstrakcijo lahko ustvarimo, preprosto z uporabo barvnih markerjev.
Ponovno ponavljam, nobenih visokih tehnologij. Z črnim markerjem je prikazana objektivna realnost, kako vse deluje. Z rdečim markerjem ljudje označujejo, kaj jim v obstoječem stanju ni všeč. Pomembno je, da to pišejo oni, ne jaz. Ko po sestanku grem k direktorju za informacijske tehnologije, ne ponujam seznama 10 stvari, ki jih je treba popraviti. Prizadevam si najti povezave med tem, kar govorijo ljudje iz podjetja, in obstoječimi potrjenimi vzorci. Končno, z modrim markerjem predlagamo možne rešitve problema.
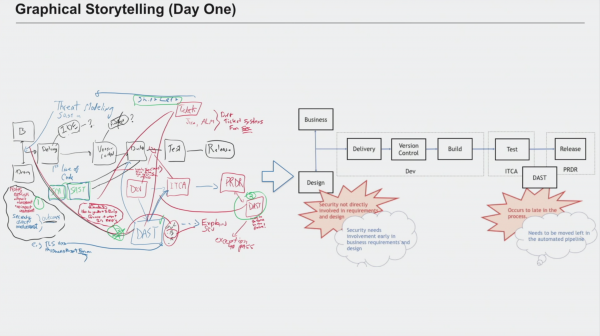
(Ovu ilustraciju možete )
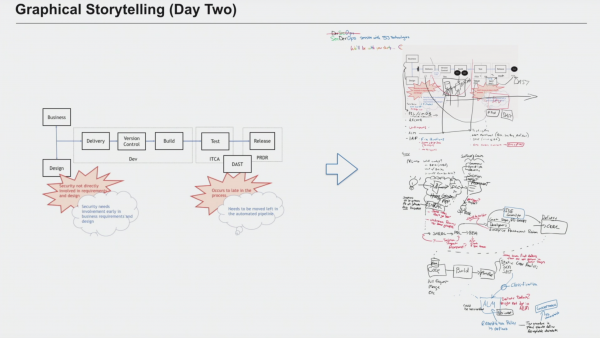
Primer takega pristopa je prikazan zgoraj. Na začetku tega leta sem delal z eno banko. Delavci iz oddelka za varnost so bili prepričani, da se ne smejo udeleževati pregledov zahtev in oblikovanja (design and requirement reviews).
(Ovu ilustraciju možete )
Potem smo se pogovorili z ljudmi iz drugih oddelkov in ugotovili, da so pred približno 8 leti razvijalci programske opreme izločili delavce za varnost, ker so upočasnjevali delo. In to se je spremenilo v prepoved, ki se je dojemala kot samoumevna. Čeprav v resnici ni bilo nobene prepovedi.
Naše srečanje je potekalo zelo zapleteno: približno tri ure je pet različnih ekip neuspešno poskušalo pojasniti, kaj se dogaja med kodo in zgradbo. To bi se lahko zdelo najpreprostejša stvar. Večina DevOps svetovalcev vnaprej predvideva, da je to že vsem znano.
Potem se je človek, odgovoren za upravljanje IT (IT governance), ki je štiri ure molčal, nenadoma oživil, ko smo prišli do njegove teme, in nas zaposlitil še zelo dolgo. Na koncu sem ga vprašal, kaj meni o srečanju, in nikoli ne bom pozabil njegovega odgovora. Rekel je: 'Včasih sem mislil, da imava v našem banki samo dva načina dobave programske opreme, zdaj pa vem, da jih je kar pet, in za tri sploh nisem slutil.'
(Ovu ilustraciju možete )
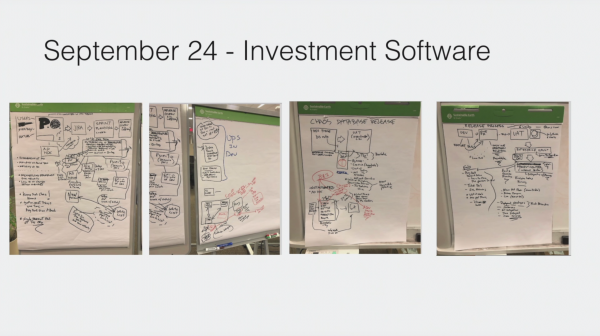
Zadnje srečanje v tej banki je bilo s ekipo, ki se ukvarja s programsko opremo za investicije. Ugotovili smo, da je boljše pisati sheme z markerjem na papirju kot na tabli, in celo boljše kot na pametni tablo.
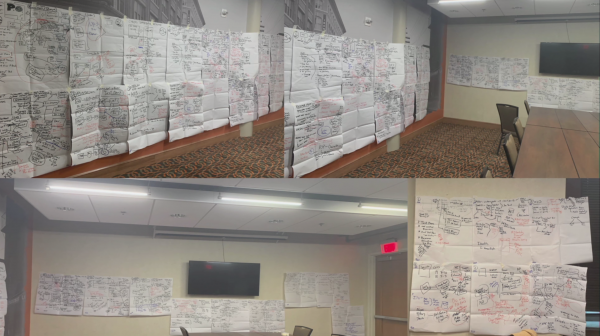
Fotografije, ki jih vidite, so to, kako je videti konferenčna soba hotela četrti dan našega srečanja. Te sheme smo uporabili za iskanje vzorcev, torej arhetipov.
Torej, postavljam vprašanja zaposlenim, oni zabeležijo odgovore zmarkerji treh barv (črna, rdeča in modra). Njihove odgovore analiziram z vidika arhetipov. Zdaj pa se pogovorimo o vseh arhetipih po vrsti.
1. Make All Work Visible: Naredite delo vidno
V večini podjetij, s katerimi delam, je zelo visok delež neznanega dela. Na primer, to se zgodi, ko en sodelavec pride do drugega in ga preprosto prosi, da nekaj naredi. V velikih organizacijah je lahko do 60 % nepovzetega dela. In do 40 % dela ni nikakor dokumentirano. Če bi to bil Boeing, se nikoli več ne bi usedel v njihov letalnik. Če je dokumentirana le polovica dela, ni jasno, ali je to delo opravljeno pravilno. Vse druge metode se izkažejo za neuporabne — ni smisla poskušati avtomatizirati, ker znanih 50 % morda predstavlja najusklajenejši in najjasnejši del dela, katerega avtomatizacija ne bo prinesla velikih rezultatov, medtem ko je vse najhujše v nevidni polovici. Brez dokumentacije je nemogoče najti razne hrošče in skrito delo, ne moremo najti ozkih grl, tistih . Ona razkriva pet različnih "uhanj časa" (thieves of time):
- Predolg delovni proces (WIP)
- Neznane odvisnosti
- Nepovzetno delo
- Konfliktne prioritete
- Zapostavljeno delo
To je zelo dragocena analiza, knjiga pa je odlična, vendar so vsi ti nasveti brez pomena, če so vidni le 50 % podatkov. Uporabljati metode, ki jih predlaga Dominica, je mogoče le, če je natančnost višja od 90 %. Govorim o situacijah, ko šef da podrejenemu nalogo, ki traja 15 minut, ta pa potrebuje tri dni; vendar šef v resnici ne ve, da je ta podrejeni še odvisen od štirih ali petih drugih ljudi.
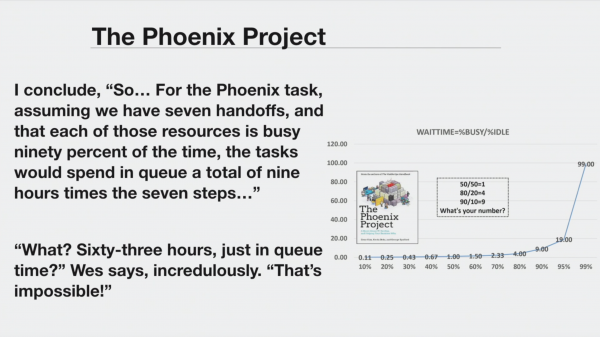
Phoenix Project je izjemna pripoved o projektu, ki je zamuja tri leta. Eden od junakov se zaradi tega sooča s potencialnim odpuščanjem in se sreča z drugim likom, predstavljenim kot nekakšen Sokrat. Ta mu pomaga razjasniti, kaj točno je šlo narobe. Ugotovi se, da je v podjetju en sistemski administrator po imenu Brent, in da skozi njega na tak ali drugačen način poteka vse delo. Na eni od sestankov enega od podrejenih vprašajo: zakaj vsaka polurni naloga traja teden dni? V odgovor sledi poenostavljena razlaga teorije vrst in Littlovo pravilo, kjer ugotovimo, da pri 90-odstotni zasedenosti vsak delovni ura traja 9 ur. Vsako nalogo je treba poslati sedmim drugim ljudem, zato se ta ura prelevi v 63 ur, 7 pomnoženo z 9. To govorim zato, da bi razumevanje Littlovega pravila ali kakršne koli kompleksne teorije vrst zahtevalo vsaj razpoložljive podatke.
Zato, ko govorim o vidnosti, ne mislim le na to, da bi bilo vse na zaslonu, temveč da bi vsaj imeli podatke. Ko ti podatki obstajajo, se pogosto izkaže, da je zelo veliko neplaniranega dela, ki nekako prihaja do Brenta, čeprav to ni potrebno. Brent je odličen fant, nikoli ne reče 'ne', a ob tem nikomur ne pove, kako opravlja svoje delo.
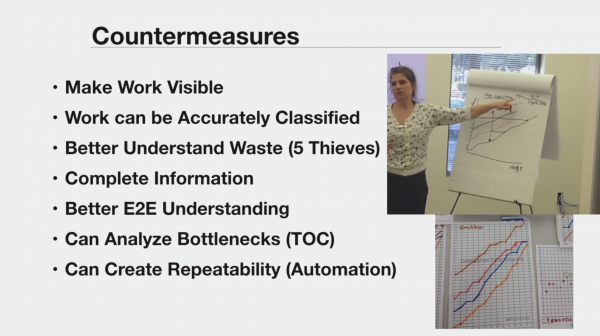
Ko je delo vidno, lahko natančno klasificiramo podatke (s tem se ukvarja Dominika na fotografiji), lahko uporabimo abstrakcijo petih uhajanj časa in avtomatiziramo.
2. Konsolidacija sistemov upravljanja dela: Upravljanje nalog
Arhetipi, o katerih govorim, predstavljajo nekakšno piramido. Če je prvi del pravilno opravljen, je drugi nekakšna nadgradnja. Mnogi od njih ne delujejo za začetnike, potrebno jih je upoštevati v primeru velikih podjetij, kot so tista, ki dosežejo seznam Fortune 5000. V zadnjem podjetju, kjer sem delal, je bilo 10 sistemov za sledenje napakam (sistem za obravnavo napak). V eni ekipi je bil Remedy, druga je napisala neko svojo rešitev, tretja je uporabljala Jiro, nekdo pa se je popolnoma oslanjal na elektronsko pošto. Istih težav ne moreš reševati, če podjetje ima 30 različnih procesov, ampak nimam časa, da bi razpravljal o vseh tovrstnih primerih.
Razgovaram s ljudima o tome kako se točno kreiraju tiket, što se s njima dalje događa i kako se izbjegavaju. Najzanimljivije je da ljudi na našim sastancima govore prilično iskreno. Pitao sam koliko ljudi postavlja "manje / nema utjecaja" za tikete koji su zapravo trebali imati "veliki utjecaj". Ispostavilo se da to radi gotovo svatko. Ne bavi se denunciranjem i nastojim ne otkrivati ljude. Kada mi se netko iskreno povjeri, ne otkrivam tu osobu. Ali kada gotovo svi zaobilaze sustav, to znači da je cijela sigurnost zapravo samo dekoracija. Stoga se iz podataka ovog sustava ne mogu donositi nikakvi zaključci.
Da biste riješili problem s tiketima, potrebno je odabrati jedan glavni sustav. Ako koristite Jira, neka to bude samo Jira. Ako postoji neka alternativa, neka to bude samo ona. Bit je u tome da tikete treba smatrati još jednim korakom u procesu razvoja. Svaka akcija treba imati tiket koji prolazi kroz razvojni tijek rada. Tiketi se šalju timu koji ih postavlja na storyboard i zatim preuzima odgovornost za njih.
To se odnosi na sve odjele, uključujući infrastrukturni i operativni. U tom slučaju može se stvoriti koliko-toliko uvjerljiva slika o stanju stvari. Kada je ovaj proces uspostavljen, iznenada se ispostavlja da se lako može utvrditi tko je odgovoran za svaku aplikaciju. Jer sada dobivamo ne 50%, već 98% novih usluga. Ako taj glavni proces funkcionira, točnost se povećava u cijelom sustavu.
Pipeline usluga
To je ponovno relevantno samo za velike korporacije. Ako ste nova firma u novom području — zasučite rukave i radite sa svojim Travis CI ili CircleCI. Što se tiče Fortune 5000 kompanija, ilustrativan je slučaj koji se dogodio u banci u kojoj sam radio. Došli su iz Google-a i pokazali im dijagrame sa starim IBM sistemima. Ljudi iz Google-a su s čuđenjem pitali — gdje je izvorni kod za to? A nema nikakvog izvornog koda, nema čak ni GUI-a. To je stvarnost s kojom velike organizacije moraju raditi: 40-godišnji bankovni zapisi na drevnom mainframeu. Jedan od mojih klijenata koristi Kubernetes kontejnere s Circuit Breaker obrascima, plus Chaos Monkey, sve to za aplikaciju KeyBank. No, ovi kontejneri se na kraju povezuju s aplikacijom na COBOL-u.
Ljudi iz Google-a su bili uvjereni da će riješiti sve probleme mog klijenta, a zatim su počeli postavljati pitanja: što je IBM datapipe? Odgovaraju im: to je konektor. K čemu se povezuje? Na sistem Sperry. A što je to? I tako dalje. Na prvi pogled izgleda: kakav DevOps tu može postojati? Ali zapravo, to je moguće. Postoje sistemi isporuke koji omogućavaju prenošenje radnog procesa timovima koji se bave isporukom.
3. Teorija ograničenja: Teorija ograničenja
Prelazimo na treći arhetip: institucionalno / „plemensko“ znanje. Obično, u svakoj organizaciji postoji nekoliko ljudi koji znaju sve i svima upravljaju. To su oni koji su najduže u organizaciji i koji poznaju sve zaobilaznice.
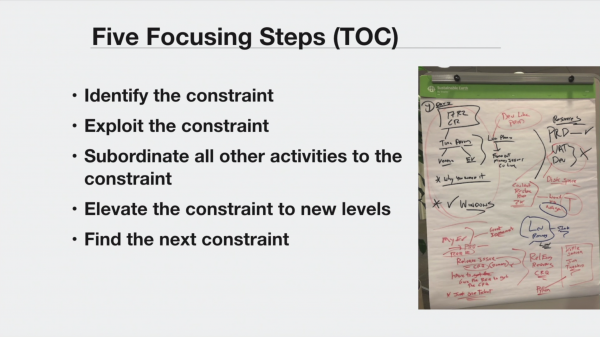
Kada se to otkrije na dijagramu, ja posebno obeležavam takve ljude markerom: na primjer, ispostavlja se da je neki Lou prisutan na svim sastancima. I za mene je jasno: to je lokalni Brent. Kada direktor za informacione tehnologije bira između mene u majici i patikama i momka iz IBM-a u odijelu, mene biraju zato što mogu reći direktoru stvari koje drugi momak ne može reći i koje bi direktoru mogle biti neugodne za čuti. Govorim im da u njihovoj firmi postoji usko grlo, to je neko po imenu Fred i neko po imenu Lou. To usko grlo treba razvezati, njihovo znanje treba na neki način izvući od njih.
Da bi rešili ovaj problem, mogu, na primer, predložiti korišćenje Slack-a. Snalažljivi direktor bi pitao — zašto? Obično u takvim slučajevima DevOps konsultanti odgovaraju: zato što to svi rade. Ako je direktor zaista snalažljiv, reći će: pa i šta. I tu će se dijalog završiti. A ja na to odgovaram: zato što u kompaniji postoje četiri uska grla, Fred, Lu, Suzi i Džejn. Da bi se njihovo znanje institucionalizovalo, prvo je potrebno uvesti Slack. Sve vaše viki stranice su potpuna glupost, jer niko ne zna za njihovo postojanje. Ako se tim inženjera bavi spoljnim i unutrašnjim razvojem, svi moraju znati da se mogu obratiti timu spoljnog razvoja ili timu infrastrukture sa pitanjima. U tom trenutku, verovatno će Lu ili Fred imati vremena da se povežu sa viki. A onda će neko na Slack-u pitati zašto ne funkcioniše, recimo, korak 5. I tada će Lu ili Fred ispraviti uputstvo u viki. Ako se ovaj proces uspostavi, mnogo toga će se samo od sebe posložiti.
Ovo je moja osnovna misao: da biste preporučili neku visoku tehnologiju, prvo treba da dovedete u red temelje za nju, a to se može uraditi prethodno opisanim niskotehnološkim rešenjima. Ako počnete sa visokim tehnologijama i ne objasnite zašto su potrebne, obično to ne završava dobro. Jedan od naših klijenata koristi Azure ML, veoma jeftino i jednostavno rešenje. Negde oko 30% pitanja je već odgovarala sama mašina koja se samoobučava. A ovo su napisali operateri koji se nisu bavili podacima, statistikama ili matematikom. To je značajno. Cena takvog rešenja je minimalna.
4. Hekovanje saradnje: Hackovi za saradnju
Četrti arhetip se nanaša na boj proti izolaciji. Večina ljudi to že ve: izolacija povzroča sovražnost. Če so vsi oddelki na svojem nadstropju in se ljudje med seboj ne srečujejo razen v dvigalu, se sovražnost med njimi zelo enostavno razvije. Če pa so ljudje nasprotno v istem prostoru, ta sovražnost takoj izgine. Ko nekdo izreče skupno obtožbo, na primer, da določen vmesnik nikoli ne deluje, je zelo enostavno to obtožbo razčleniti. Programerjem, ki so napisali vmesnik, zadostuje, da začnejo postavljati konkretna vprašanja in kmalu bo razkrito, da je uporabnik preprosto napačno uporabil orodje.
Obstaja veliko načinov za premagovanje izolacije. Nekaj časa so me prosili, da svetujem banki v Avstraliji, a sem to zavrnil, ker imam dva otroka in ženo. Edina stvar, s katero sem jim lahko pomagal, je, da sem jim priporočil grafično pripovedovanje. To je nekaj, kar dokazano deluje. Drug zanimiv način so srečanja v formatu lean coffee. V veliki organizaciji je to odlična možnost za širjenje znanja. Poleg tega lahko organiziramo notranje devops dneve, hackathone in podobno.
5. Coaching Kata
Kot sem že opozoril na začetku, o tem danes ne bom govoril. Če vas zanima, lahko pogledate .
Obstaja tudi dobra predstavitev na to temo od Mikea Rotherja:
6. Market Oriented: organizacija usmerjena na trg
Obstajajo različni problemi. Na primer, ljudje ‘I’, ljudje ‘T’ in ljudje ‘E’. Ljudje ‘I’ so tisti, ki se ukvarjajo samo z enim področjem. Običajno obstajajo v organizacijah z izoliranimi oddelki. ‘T’ pomeni, da oseba dobro pozna eno stvar, hkrati pa uspeva tudi na nekaterih drugih področjih. ‘E’ ali celo ‘škarje’ pa pomeni, da ima oseba veliko veščin.
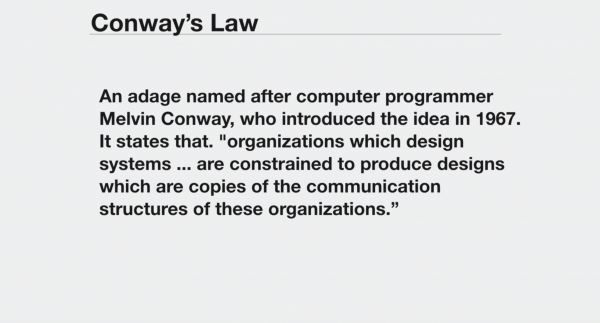
Tukaj velja Conwayev zakon (), ki ga lahko v zelo poenostavljeni obliki strnemo takole: če se tri ekipe ukvarjajo s kompajlerjem, bo na koncu dobil tri dele. Zato, če znotraj organizacije obstaja visok nivo izolacije, bo celo Kubernetes, Circuit breaker, API extensibility in druge modne stvari v tej organizaciji strukturirane tako, kot je sama organizacija. Tudi v skladu s Conwayem in kljub vsem vam, mladi geek.
Rešitev tega problema je bila opisana že večkrat. Na voljo so organizacijski arhetipi, ki jih je opisal Fernando Fernandez. Tista problematična arhitektura, o kateri sem pravkar govoril, z izolacijo — je funkcionalno usmerjena arhitektura. Druga vrsta — slabša, je matrična arhitektura, kjer je zmeda dveh drugih. Tretja — je tisto, kar opazimo v večini zagonskih podjetij, velike družbe pa se tudi trudijo, da bi se ujemale s to vrsto. To je organizacija, usmerjena na trg. Tukaj se optimizira za dosego najhitrejšega odziva na zahteve strank. Včasih se to imenuje ravna organizacija.
To strukturo mnogi opisujejo različno, meni je všeč ta izraz build/run teams, v Amazonu to imenujejo two pizza teams. V tej strukturi se vsi ljudje tipa „I“ združujejo okoli enega servisa in postopoma postanejo bližji tipu „T“, če pa je upravljanje pravilno urejeno, lahko postanejo celo „E“. Prvi nasprotujoči argument tukaj je — v taki strukturi so odveč elementi. Zakaj potrebujemo testnika v vsakem oddelku, če lahko imamo poseben oddelek testiranja? Na kar odgovorim: odvečni stroški v tem primeru so cena, da postane celotna organizacija v prihodnosti tip „E“. V taki strukturi testnik postopoma spozna o omrežjih, arhitekturi, načrtovanju itd. Na koncu je vsak udeleženec organizacije popolnoma obveščen o vsem, kar se v organizaciji dogaja. Če želite izvedeti, kako ta shema deluje v industriji, preberite .
7. Shift-left auditors: revizija v zgodnjih fazah cikla. Izpolnjevanje varnostnih pravil na očeh javnosti.
To je trenutek, ko vaša dejanja ne prestanejo preverjanja. Ljudje, ki delajo za vas, niso neumni. Če so, kot v zgornjem primeru, povsod navajali minor/no impact, to je trajalo tri leta, in nihče ni opazil, potem vsi dobro vedo, da sistem ne deluje. Drug primer je svetovalni odbor za spremembe (change advisory board), kamor morate vsako sredo predložiti poročila. Tam dela skupina ljudi (mimogrede, slabo plačanih), ki naj bi teoretično vedeli, kako deluje sistem kot celota. In verjetno ste v zadnjih petih letih opazili, da so naši sistemi izjemno zapleteni. In pet do šest ljudi naj bi sprejelo odločitev o spremembi, ki je niso predlagali in o kateri nič ne vedo.
Seveda tak pristop ne deluje. Moram se znebi takšnih stvari, ker ti ljudje ne varujejo sistema. Odločitev mora sprejeti sama ekipa, ker mora biti ekipa odgovorna zanjo. V nasprotnem primeru nastane paradoksalna situacija, ko manager, ki nikoli v življenju ni napisal kode, sporoči programerju, koliko časa bi moralo zasedanje kode trajati. V eni podjetju, v katerem sem delal, je bilo 7 različnih odborov, ki so obravnavali vsako spremembo, vključno z arhitekturnim odborom, odborom za izdelke itd. Obstajal je celo obvezen čakalni čas, čeprav mi je en zaposleni povedal, da v desetih letih dela nihče ni nikoli zavrnil sprememb, ki jih je predlagal ta oseba, med tem obveznim čakalnim časom.
Auditorji morajo biti povabljeni, ne pa od njih bežati. Povejte jim, da razvijate neoporečne binarne kontejnere, ki, če prestanejo vse teste, ostanejo nespremenjeni za vedno. Povejte jim, da imate pipeline kot kodo in pojasnite, kaj to pomeni. Pokažite jim naslednjo shemo: neoporečen binarni dogodek samo za branje v kontejnerju, ki prestane vse teste ranljivosti; in ne le, da se ga nihče ne dotika — tudi sistem, ki ustvari pipeline, se ne dotika, saj je tudi ta dinamično ustvarjen. Imate stranke, kot je Capital One, ki z uporabo Vault ustvarjajo nekaj podobnega blockchainu. Revizorju lahko ne pokažete 'receptov' iz Chefa, dovolj je prikazati blockchain, iz katerega je razvidno, kaj se je zgodilo s Jira nalogo v produkciji in kdo je odgovoren zanj.
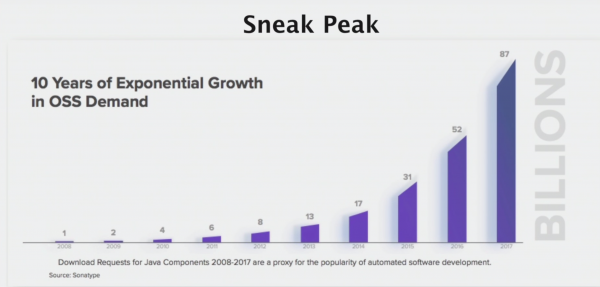
Po , ki ga je leta 2018 ustvaril Sonatype, je bilo leta 2017 87 milijard prenosov OSS.
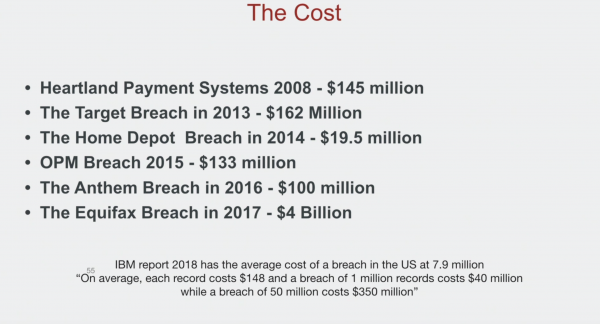
Izgube, ki nastanejo zaradi ranljivosti, so izjemno visoke. In številke, ki jih zdaj vidite zgoraj, ne vključujejo alternativnih stroškov. Na kratko o tem, kaj je DevSecOps. Takoj moram povedati, da me ne zanimajo razprave o tem, kako uspešno je to ime. Smisel je v tem, da, ker so DevOps bili zelo uspešni, poskusimo dodati varnost k temu pipeline-u.
Primer takega zaporedja:
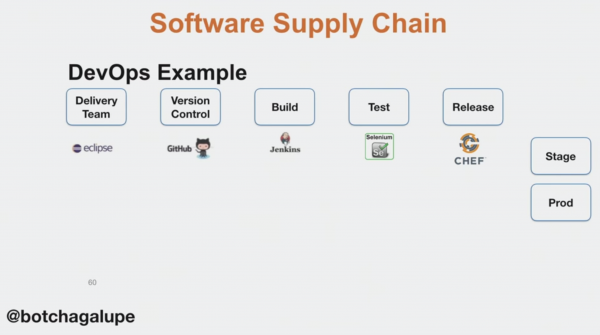
To ni priporočilo določenih izdelkov, četudi mi vsi ustrezajo. Pripravljen sem jih navedel kot primer, da pokažem, da DevOps, ki izhajajo iz industrijske organizacijske paradigme, omogoča avtomatizacijo vsakega koraka pri razvoju izdelka.
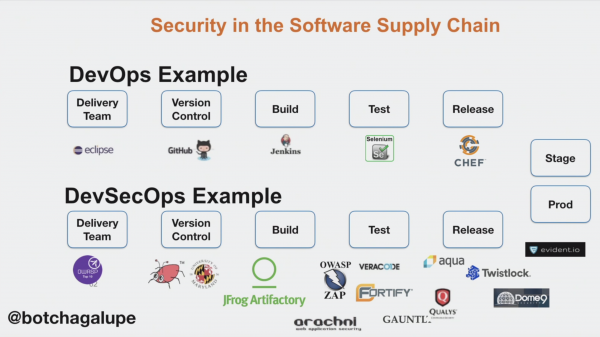
In ni nobenega razloga, zakaj ne bi mogli uporabiti istega pristopa za varnost.
Zaključek
Na koncu bom dal nekaj nasvetov za DevSecOps. V postopke oblikovanja vaših sistemov vključite revizorje in si vzemite čas za njihovo izobraževanje. S sodelovanjem z revizorji bodo izboljšali postopek. Poleg tega se je treba brez milosti boriti proti lažnim opozorilom. Tudi z najdražjimi orodji za skeniranje ranljivosti lahko razvijalci razvijejo zelo slabe navade, če nimate jasnega razumevanja razmerja med signalom in šumom. Razvijalci bodo preobremenjeni z dogodki in jih bodo preprosto začeli brisati. Če ste slišali zgodbo o Equifaxu, je tam do tega prišlo - spregledali so signal najvišje ravni nevarnosti. Poleg tega je treba ranljivosti razložiti tako, da bo jasno, kako vplivajo na poslovanje. Na primer, lahko rečete, da gre za isto ranljivost, kot je bila v zgodbi o Equifaxu. Ranljivosti, povezane z varnostjo, je treba obravnavati enako kot druge težave s programsko opremo, torej jih je treba vključiti v splošni DevOps proces. Z njimi je treba delati prek Jire, Kanbana itd. Razvijalci ne smejo misliti, da se bo s tem ukvarjal nekdo drug - nasprotno, vsi bi se morali aktivno s tem ukvarjati. Na koncu pa je treba vložiti trud v izobraževanje ljudi.
Koristne poveznice
Tukaj je nekaj poročil s konference DevOops, ki so vam lahko koristna:
- Sergej Berdnikov, Artyom Kaličkin — Zgodba o uspehu, oziroma 'Dev+DevOps+Ops' (, )
- Baruh Sadogurski, Leonid Igolnik — DevOps v obsegu: grška tragedija v treh dejanjih (, )
- Aleksander Titov, Kirill Tolkachev —
- Timothy Lister —
Zavirite u DevOops 2020 Moskva — tudi tam je veliko zanimivega.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish