

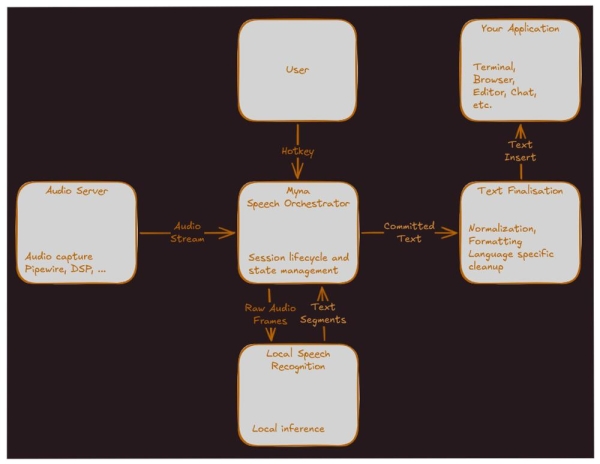
Canonical представила проект Myna — нову систему перетворення мови на текст для Ubuntu Desktop. Проект націлений на вбудоване диктування: користувач натискає гарячу клавішу, говорить, а розпізнаний текст з'являється в активному додатку. В анонсі наголошується, що Myna повинна відчуватися як природна частина робочого столу. Ubuntu і при цьому працювати з урахуванням приватності користувача. Список мов, що підтримуються, на момент публікації новини не оголошено.
Перша мета проекту Ubuntu 26.10. На цьому етапі Canonical не намагається зробити повноцінного голосового помічника або систему управління робочим столом голосом. Розробники навмисно обмежили область першої версії базовою, надійною диктовкою: натиснути клавіші, вимовити текст і отримати результат у поточному полі введення. Первинне середовище, що перевіряється. Ubuntu Desktop на Wayland з GNOME, але архітектуру планують залишити достатньо відкритою для майбутньої підтримки інших оточень.
Myna розрахована на локальне розпізнавання мови. Після встановлення необхідних моделей інтернет-з'єднання для роботи диктування не потрібно, мікрофон повинен використовуватися тільки після явної активації користувачем, аудіо обробляється в пам'яті і відкидається, а записи не відправляються в зовнішні сервіси. У проектній специфікації також зазначено, що рішення повинне уникати збереження аудіо за замовчуванням та не повинно непомітно перемикатися на хмарний сервіс.
Код та документація Myna опубліковані в репозиторії Canonical на GitHub. Проект описаний як легкий додаток speech-to-text для Ubuntu Desktop і розповсюджується під ліцензією GPL-3.0. При цьому проект знаходиться на ранній стадії: у репозиторії поки що немає опублікованих релізів, а архітектурна специфікація має статус Proposed.
Основні функції та особливості Myna
Push-to-talk диктування. Користувач утримує гарячу клавішу, що настроюється, говорить, а система вставляє розпізнаний текст у вибране поле введення. Диктування завершується після відпускання клавіші.
Локальне розпізнавання мови. Розпізнавання виконується на машині користувача через локальний стік. Це знижує залежність від хмари та дозволяє працювати без мережі після встановлення моделей.
Приватна обробка аудіо. Мікрофон активується лише під час користувальницької сесії диктування. Аудіо не повинно записуватися на диск за промовчанням, використовується обмежений буфер у пам'яті, який очищується після сесії.
Візуальний індикатор активності. Під час записування та транскрибації користувач повинен бачити зрозумілий індикатор стану. У специфікації згадуються стани на зразок Recording, Transcribing, Finalizing та Error.
Вставляє лише стабільний текст. У першій реалізації проміжні гіпотези розпізнавання нічого не винні підставлятися у додаток. У цільове поле надсилається лише підтверджений підсумковий текст.
Постобробка тексту. Сире розшифрування може проходити нормалізацію, розстановку пунктуації, капіталізацію, форматування та перетворення усних форм у письмові, наприклад “twenty two” → “22”.
Вибір мови диктування. Система повинна підтримувати мову диктування, що настроюється, за умовчанням орієнтуючись на мову інтерфейсу користувача, якщо для нього доступна відповідна модель.
Профілі якості моделі. У специфікації передбачені різні профілі моделей: легкий варіант із меншим споживанням ресурсів, збалансований профіль за замовчуванням та якісніший, але більш важкий варіант.
Безпечна робота з фокусом уведення. Ціль для вставки тексту вибирається на початку сесії. Якщо фокус вікна змінюється під час диктування, система не повинна мовчки надсилати текст до іншої програми.
Блокування у захищених полях. Диктування має блокуватися в password-полях, вікнах автентифікації та інших захищених місцях, якщо програма або тулкіт дозволяють це визначити.
Інтеграція з Wayland/GNOME. Перша версія орієнтована на Wayland та GNOME. Для початкової вставки тексту розглядається IBus, а в майбутньому планується нативніший Wayland-шлях через input-method/text-input протоколи.
Установки користувача. У планованому інтерфейсі налаштувань мають бути включення/вимкнення STT, вибір гарячої клавіші, мови диктування, мікрофона, профілю моделі, параметрів постобробки та індикатора активності.
У першій ітерації за рамками проекту залишаються пробудження за ключовою фразою, постійне фонове прослуховування, хмарне розпізнавання, голосовий асистент, голосові команди, управління робочим столом, переклад мови, визначення мовника, автоматичне визначення мови та історія диктувань. Іншими словами, Canonical починає не з "AI-асистента", а з більш приземленої функції: локального голосового введення тексту у звичайні програми Ubuntu.
Джерело: linux.org.ru
