

Деякі компанії, зокрема наш замовник, розвивають продукт через партнерську мережу. Наприклад, великі інтернет-магазини інтегровані зі службою доставки - ви замовляєте товар і невдовзі отримуєте трекінговий номер посилки. Інший приклад - разом з пересадкою ви купуєте страховку або квиток на аероекспрес.
Для цього використовується один API, який потрібно надати партнерам через API Gateway. Це завдання ми й вирішили. У цій статті розповімо подробиці.
Дано: екосистема та API-портал з інтерфейсом, де користувачі зареєстровані, отримують інформацію тощо. Нам потрібно зробити зручний та надійний API Gateway. У процесі нам потрібно було забезпечити
- реєстрацію,
- контроль підключення до API,
- моніторинг того, як користувачі використовують кінцеву систему,
- облік бізнес-показників.
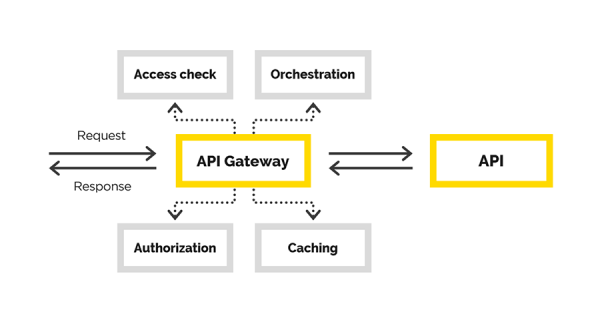
У статті ми розповімо про наш досвід створення API Gateway, під час якого ми вирішували такі завдання:
- автентифікація користувача,
- авторизація користувача,
- модифікація вихідного запиту,
- проксування запиту,
- постобробка відповіді.
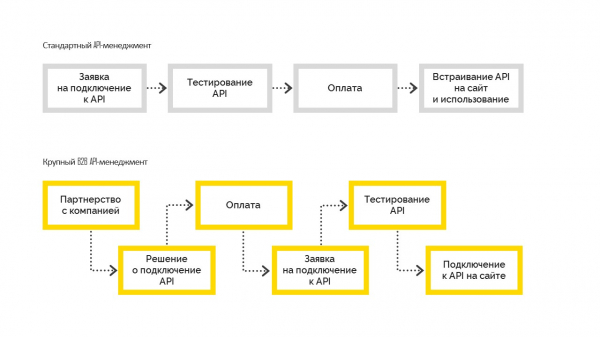
Є два види API-менеджменту:
1. Стандартний, який працює в такий спосіб. Перед підключенням користувач тестує можливості, потім оплачує та вбудовує на свій сайт. Найчастіше їм користуються у малому та середньому бізнесі.
2. Великий B2B API Management, коли компанія спочатку приймає рішення про підключення, стає партнером компанії з контрактним зобов'язанням, після чого підключається до API. І вже після залагодження всіх формальностей компанія отримує тестовий доступ, проходить тестування та виходить у прод. Але це неможливо без управлінського рішення щодо підключення.
наше рішення
У цій частині розповімо про створення API Gateway.
Кінцеві користувачі шлюзу, що створюється до API - партнери нашого замовника. Для кожного з них уже зберігаються необхідні контракти. Нам потрібно буде лише розширити функціональність, відзначаючи доступ до шлюзу. Відповідно, потрібен контрольований процес підключення та управління.
Безумовно, можна було взяти якесь готове рішення для вирішення завдання API Management та створення API Gateway зокрема. Наприклад, таким могло бути. Нам воно не підійшло, тому що в нашому випадку ми вже мали API-портал і величезну екосистему, побудовану навколо нього. Всі користувачі були зареєстровані, вони вже розуміли, де і як вони можуть отримати потрібну інформацію. В API-порталі вже існували потрібні інтерфейси, нам був необхідний API Gateway. Власне, його розробкою ми зайнялися.
Те, що ми називаємо API Gateway - свого роду проксі. Тут у нас знову був вибір – можна написати свій проксі, а можна вибрати щось готове. У цьому випадку ми пішли другим шляхом і вибрали зв'язку nginx+Lua. Чому? Нам потрібен був надійний, протестований software, що підтримує масштабування. Ми не хотіли після реалізації перевіряти і коректність бізнес-логіки та коректність роботи проксі.
Будь-який веб-сервер має конвеєр обробки запиту. У випадку nginx він виглядає так:
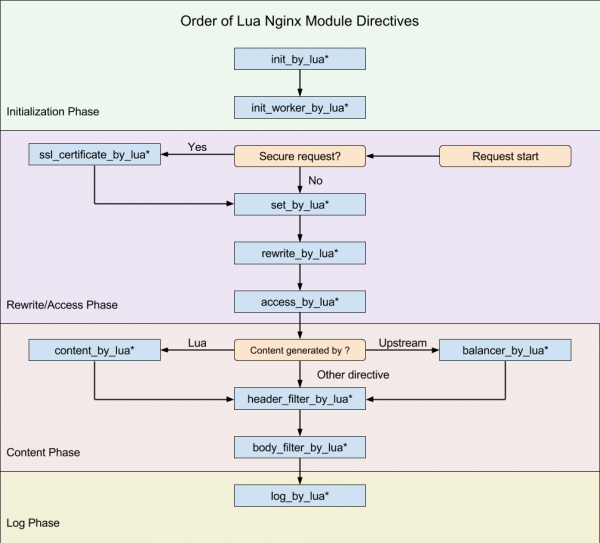
(схема з )
Нашою метою було вбудуватись у цей конвеєр у той момент, де ми можемо модифікувати вихідний запит.
Ми хочемо створити transparent proxy, щоб функціонально запит залишався таким, яким і надійшов. Ми лише контролюємо доступ до кінцевого API, допомагаємо запиту дістатися до нього. Якщо запит був некоректним, помилку повинен показати кінцевий API, але не ми. Єдина причина, чому ми можемо відхилити запит через відсутність доступу у клієнта.
Для nginx вже існує на . Lua — скриптова мова, вона дуже легковажна і легка в освоєнні. Таким чином, потрібну логіку ми реалізували за допомогою Lua.
Конфігурація nginx'a (аналогія route додатка), де й виконується вся робота, цілком зрозуміла. Примітна тут остання директива – post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Розглянемо, що відбувається у цій конфігурації:
more_clear_input_headers - Очищає значення вказаних після директиви хедерів.
lua_need_request_body — регулює, чи слід прочитати вихідне тіло запиту перед тим, як виконувати директиви rewrite/access/access_by_lua чи ні. За замовчуванням nginx не читає тіло запиту клієнта, і якщо вам необхідно отримати доступ до нього, то дана директива повинна мати значення on.
rewrite_by_lua_file шлях до скрипти, в якому описана логіка для модифікації запиту
access_by_lua_file — шлях до скрипту, в якому описано логіку, яка перевіряє наявність доступу до ресурсу.
proxy_pass — url, на який проксуватиметься запит.
body_filter_by_lua_file — шлях до скрипту, у якому описано логіку для фільтрації запиту перед поверненням клієнту.
І, нарешті, post_action - офіційно недокументована директива, за допомогою якої можна виконувати ще якісь дії після того, як відповідь віддана клієнту.
Далі розповімо по порядку, як вирішували свої завдання.
Авторизація/автентифікація та модифікація запиту
Авторизація
Авторизацію та аутентифікацію ми побудували за допомогою доступів за сертифікатом. Є кореневий сертифікат. Кожному новому клієнту замовника генерується особистий сертифікат, з яким він може отримати доступ до API. Цей сертифікат налаштовується в секції налаштувань nginx.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
модифікація
Може виникнути справедливе питання: що робити із сертифікованим клієнтом, якщо ми раптово захотіли відключити його від системи? Не перевипускати сертифікати для всіх інших клієнтів.
Так ми плавно і підійшли до наступного завдання – модифікація вихідного запиту. Початковий запит клієнта, взагалі кажучи, не є валідним для кінцевої системи. Одне із завдань полягає в тому, щоб дописати в запит частини, що бракують, щоб зробити його валідним. Сіль у тому, що дані, що бракують, — різні для кожного клієнта. Ми знаємо, що клієнт приходить до нас із сертифікатом, з якого ми можемо взяти відбиток та витягти з бази необхідні дані клієнта.
Якщо в якийсь момент потрібно відключити клієнта від нашого сервісу, його дані пропадуть із бази і він нічого не зможе робити.
Робота з даними клієнта
Нам потрібно було забезпечити високу доступність рішення, особливо як ми отримуємо дані клієнта. Складність у тому, що першоджерело цих даних — сторонній сервіс, який не гарантує безперебійну та високу швидкість роботи.
Тому нам потрібно було забезпечити високу доступність цих клієнтів. Як інструмент ми вибрали , який надає нам:
- швидкий доступ до даних,
- можливість організувати кластер із кількох нід з реплікованими на різних нодах даними.
Ми пішли за найпростішою стратегією доставки даних у кеш:
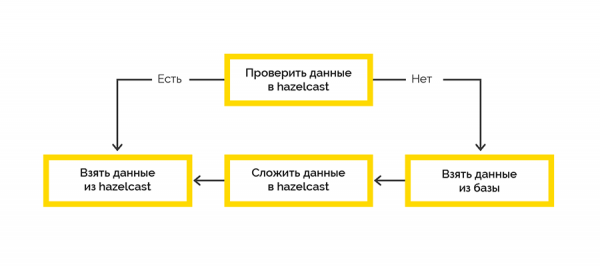
Робота з кінцевою системою відбувається в рамках сесій та є ліміт на максимальну кількість. Якщо клієнт не закрив сесію, це доведеться робити нам.
Дані про відкриту сесію надходять від кінцевої системи і спочатку обробляються на боці Lua. Ми вирішили використати Hazelcast для збереження цих даних джобіком, написаним на .NET. Потім з деякою періодичністю ми перевіряємо право на життя відкритих сесій та закриваємо протухлі.
Доступ до Hazelcast і з Lua, і з .NET
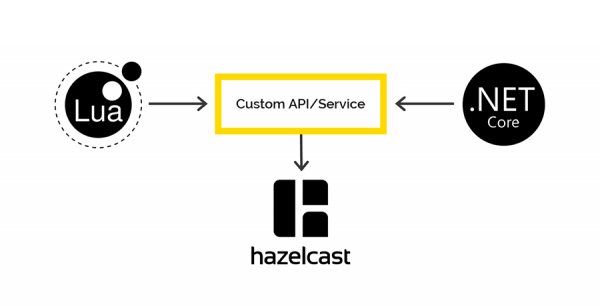
Клієнтів на Lua для роботи з Hazelcast немає, але Hazelcast має REST API, яким ми і вирішили скористатися. Для .NET є , через який ми планували отримати доступ до даних Hazelcast на стороні .NET. Але не тут було.
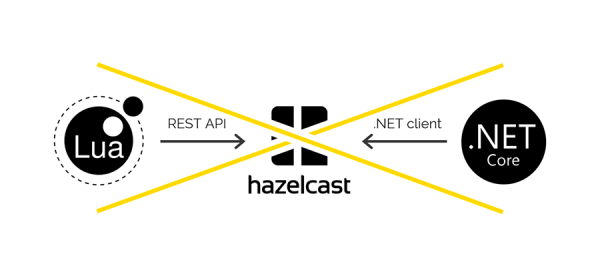
При збереженні даних через REST і вилучення через .NET клієнта використовуються різні серіалізатори. Тому неможливо покласти дані через REST, а дістати через .NET client і навпаки.
Якщо будуть зацікавлені, то розкажемо детальніше про цю проблему в окремій статті. Спойлер – на схемі.
Логування та моніторинг
Наш корпоративний стандарт для логування через .NET - Serilog, всі логи в результаті потрапляють до Elasticsearch, їх аналіз ведемо через Kibanа. Щось подібне хотілося зробити й у цьому випадку. Єдиний для роботи з Elastic Lua, який був знайдений, зламався на першому ж require. І ми використали Fluentd.
- Open source рішення для забезпечення єдиного шару логування програми. Дозволяє збирати логи з різних верств програми, а потім транслювати їх у єдине джерело.
API Gateway працює в K8S, тому ми вирішили додати контейнер з fluentd у ту саму поду, щоб писати логи в наявний відкритий tcp port fluentd.
Ми також досліджували, як буде поводитися fluentd, якщо у нього не буде зв'язку з Elasticsearch. Протягом двох діб у шлюз безперервно йшли запити, у fluentd відправлялися логи, але у fluentd був забанен IP Elastic. Після відновлення зв'язку fluentd відмінно перегнав всі логи в Elastic.
Висновок
Вибраний підхід до реалізації дозволив нам доставити реально працюючий продукт у бойове середовище лише за 2.5 місяці.
Якщо вам доведеться займатися подібними речами, радимо в першу чергу чітко зрозуміти, яке завдання ви вирішуєте і що з ресурсів у вас вже є. Будьте уважні до складнощів інтеграції з існуючими системами керування API.
Зрозумійте для себе, що саме ви збираєтеся розробляти лише бізнес-логіку обробки запитів або, як могло бути в нашому випадку, проксі цілком. Не забувайте, що все, що ви зробите самі, має бути ретельно протестовано.
Джерело: habr.com
