

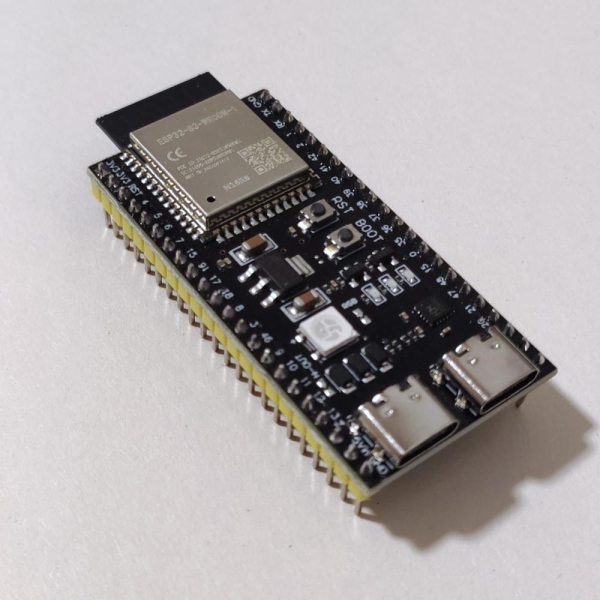
Nhà phát triển Vyacheslav Serbov, người có bút danh slvDev, chứng minh Việc tạo văn bản hoàn toàn cục bộ được thực hiện trên vi điều khiển ESP32-S3. Mô hình ngôn ngữ thu được chứa 28,9 triệu tham số và tạo ra khoảng 9,9 từ mỗi giây mà không cần truy cập máy chủ hoặc các tài nguyên tính toán bên ngoài khác. Các câu chuyện ngắn được tạo ra sẽ được hiển thị trên màn hình OLED được kết nối.
Dự án esp32-ai Đã thử nghiệm trên module ESP32-S3 N16R8 với 512 KB SRAM tích hợp, 8 MB PSRAM và 16 MB bộ nhớ flash. Mô hình lượng tử hóa 4 bit chiếm 14,9 MB. Kho lưu trữ này chứa mã nguồn C runtime, các công cụ huấn luyện và lượng tử hóa, firmware, các bài kiểm tra và các script để tải lên bo mạch.
Con số 28,9 triệu tham số được tuyên bố không nên được so sánh trực tiếp với số lượng tham số của các phần mềm LLM để bàn thông thường. Theo... báo cáo chi tiết của nhà phát triểnMô hình bao gồm một nhân tính toán dày đặc với khoảng 559 tham số, một lớp đầu ra với 3,1 triệu tham số và một bảng biểu diễn vectơ phân lớp với khoảng 25 triệu tham số. Phần cuối cùng này tạo nên phần lớn kích thước chính thức của mô hình, nhưng không được xử lý hoàn toàn khi tạo ra mỗi token.
Mô hình được lưu trữ trên ba cấp độ bộ nhớ. Dữ liệu được truy cập thường xuyên nhất nằm trong SRAM nội bộ, lớp đầu ra, bộ nhớ đệm KV và bộ đệm tạm thời nằm trong PSRAM, và bảng 25 triệu mục nằm trong bộ nhớ flash và có thể truy cập thông qua ánh xạ không gian địa chỉ. Đối với mỗi token, chỉ khoảng sáu hàng được đọc từ đó, tổng cộng khoảng 450 byte.
Thiết bị này dựa trên công nghệ Per-Layer Embeddings được Google sử dụng trong Gemma 3n. Theo... Tài liệu của GoogleCác tham số PLE có thể được lưu trữ bên ngoài bộ nhớ làm việc của mô hình và được thêm vào quá trình suy luận khi các lớp riêng lẻ được xử lý. Trong esp32-ai, phương pháp này được mở rộng đến hệ thống phân cấp bộ nhớ của vi điều khiển, nơi bộ nhớ SRAM tốc độ cao bị hạn chế đặc biệt.
Phiên bản đầu tiên hoạt động chính xác của môi trường chạy dựa trên C chỉ tạo ra 0,57 token mỗi giây. Sau khi đặt lớp đầu ra vào PSRAM, chuyển sang kích hoạt 8 bit, phân phối tính toán giữa hai lõi Xtensa LX7 và các tối ưu hóa khác, độ trễ đã giảm xuống còn 94,9 ms cho mỗi bước mô hình. Thông lượng đo được cuối cùng đạt 9,88 token mỗi giây, tính đến toàn bộ quá trình tạo. Giới hạn chính lúc này là băng thông PSRAM khi đọc lớp đầu ra.
Mô hình được huấn luyện trên một tập dữ liệu tổng hợp. Truyện nhỏNó bao gồm những câu chuyện đơn giản bằng tiếng Anh với vốn từ vựng hạn chế. Do đó, nó có thể tiếp tục câu và tạo ra những câu chuyện ngắn, mạch lạc, nhưng không được thiết kế để trả lời câu hỏi, làm theo hướng dẫn, lập trình hoặc tái tạo kiến thức thực tế. Nhà phát triển xem tác phẩm này chủ yếu như một minh chứng cho việc bố trí hiệu quả mô hình trong bộ nhớ vi điều khiển, hơn là một chatbot tự động hoàn chỉnh.
Trong tài liệu hiện tại, tác giả đặc biệt nhấn mạnh rằng esp32-ai là một dự án phát triển độc lập. llama2.c Công trình của Andrej Karpathy và việc ra mắt mô hình thứ 260 trên ESP32-S3 trước đó chỉ được cung cấp như những hướng dẫn và ví dụ về các công việc đã thực hiện: mã nguồn, các điểm kiểm tra và phương pháp luận không được sao chép trực tiếp từ chúng. Mã nguồn esp32-ai được phân phối theo giấy phép MIT.
Nguồn: linux.org.ru
