

作为 Qwenputer 项目的一部分,研究人员开发了 Qwen3.5-4B AI 模型的扩展版本。该模型实现了一个基于 RISC-V 架构(RV32IM)的完整 32 位 CPU 的嵌入式模拟器,支持 Zba 扩展,并配备了用于大数运算的大数协处理器。CPU 内核实现被编译成一组权重,并以 11 层 Transformer 的形式集成到一个更大的语言模型中,这些 Transformer 层位于 Qwen 主层之前。计算直接在神经网络的前向传播过程中执行,无需外部工具或插件。
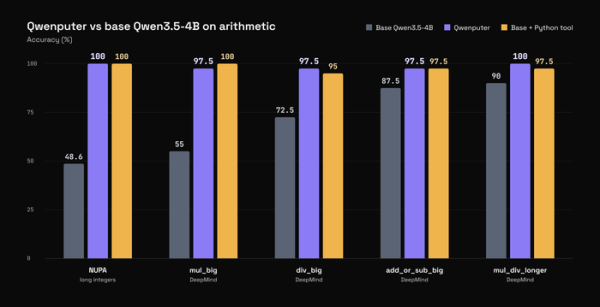
该实现成功通过了官方 riscv-tests 测试套件中的所有测试,并且能够执行编译后的 C 和 MicroPython 代码。在进行大数运算时,Qwenputer 的准确率达到 97.5%-100%,与使用外部 Python 解释器的基准模型 Qwen3.5 相当或更优。
为了模拟 RAM,该模型利用了独立的门控 DeltaNet 层(线性 RNN),这些层在标准的 Qwen AI 模型中用于在处理大型上下文窗口时保留修改后的状态。通过锁定门控状态并使用独热编码,每次写入请求都只会覆盖状态矩阵中的一行,从而允许将 DeltaNet 状态用作固定大小的可寻址内存,避免键值 (KV) 缓存随着上下文长度的增加而线性增长。该内存用于存储 CPU 寄存器、数据和可执行机器代码。
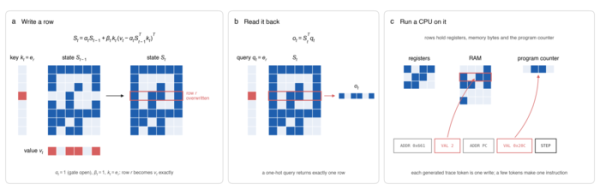
处理器指令,例如寄存器读取、算术运算和条件跳转,会被直接编译成Transformer层的权重。每条指令都与特殊的标记(ADDR、VAL、STEP)相关联,AI模型层会将这些标记解释为CPU逻辑。一个名为RvChat的小型外部驱动程序用于初始化CPU和加载固件,但机器代码本身完全在模型权重内部处理。
该项目的局限性包括:与原始 Qwen 模型相比,在保留状态切片(检查点)的情况下,其大小大约增加了一倍(18.8 GB),这主要是由于额外层增加了填充空间。此外,其计算速度也相对较低(在 L4 GPU 上每秒大约处理 3200 个 token),这意味着复杂的计算可能需要几秒钟而不是几毫秒。
此外,我们还使用实验性文件系统实现了该人工智能模型的一个变体,允许在人工智能模型的权重中存储多达 512 个文件,每个文件包含 53 个文本标记。与 RAM 实现类似,存储也是基于 DeltaNet 状态组织的,但不同之处在于,该文件系统提供持久存储,不会在会话之间丢失状态。
Qwenputer 的工作也为研究人工智能领域新的潜在安全问题奠定了基础。以 Qwenputer 为例,研究展示了如何通过对人工智能模型进行特殊修改,使其推理过程隐藏在循环神经网络 (RNN) 状态中,从而绕过模型推理监控机制(CoT,思维链)。此外,研究还展示了……
能够创建内置于 AI 模型权重中的安全控制和监控机制,而模型本身无法禁用或修改这些机制。
来源: opennet.ru
