

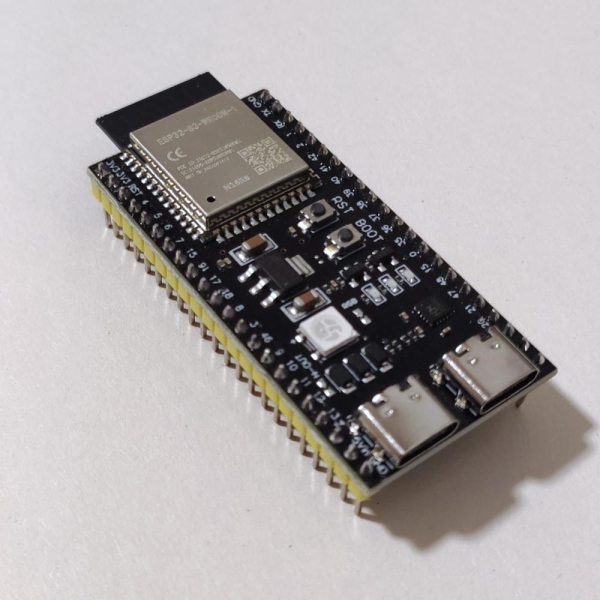
開發者 Vyacheslav Serbov,筆名 slvDev, 展示了 在 ESP32-S3 微控制器上實現完全本地文字生成。產生的語言模型包含 28,9 萬個參數,無需存取伺服器或其他外部運算資源,即可每秒產生約 9,9 個詞元。產生的短篇故事顯示在連接的 OLED 顯示器上。
項目 esp32-ai 該車型已在配備 512 KB 板載 SRAM、8 MB PSRAM 和 16 MB 快閃記憶體的 ESP32-S3 N16R8 模組上進行測試。 4 位元量化模型佔用 14,9 MB 空間。程式碼庫包含 C 執行時間原始程式碼、訓練和量化工具、韌體、測試案例以及用於將其上傳到開發板的腳本。
所聲稱的28,9萬個參數不應與傳統桌面LLM的參數數量直接比較。根據 詳細開發商報告該模型由一個包含約 559 個參數的密集計算內核、一個包含 3,1 萬個參數的輸出層以及一個包含約 25 萬個參數的分層向量表示表組成。後者構成了模型形式規模的大部分,但在產生每個詞元時並非全部都會被處理。
該模型使用三級記憶體進行儲存。最常存取的資料位於內部 SRAM 中,輸出層、鍵值快取和臨時緩衝區位於 PSRAM 中,而包含 25 萬筆記錄的表則位於快閃記憶體中,可透過位址空間映射進行存取。對於每個標記,僅從中讀取大約六行數據,總計約 450 個位元組。
該設備基於谷歌在Gemma 3n中使用的逐層嵌入技術。 Google 文件PLE參數可以儲存在模型工作記憶體之外,並在處理各個層時添加到推理過程中。在esp32-ai中,這種方法擴展到了微控制器的記憶體層次結構,而微控制器的高速SRAM資源尤其有限。
第一個正確的基於 C 語言的運行時版本每秒只能產生 0,57 個令牌。將輸出層置於 PSRAM 中,切換到 8 位元激活,將計算任務分配到兩個 Xtensa LX7 核心上,並進行其他最佳化後,延遲降低至每個模型步驟 94,9 毫秒。考慮到完整的生成過程,最終測得的吞吐量達到了每秒 9,88 個代幣。此時,讀取輸出層時的主要限制變成了 PSRAM 的頻寬。
該模型使用合成資料集進行訓練。 小故事它由詞彙量有限的簡單英語故事組成。因此,它可以接續句子並創造簡短連貫的故事,但它並非設計用於回答問題、執行指令、程式設計或複述事實性知識。開發者主要將這項工作視為展示如何有效地將模型儲存在微控制器記憶體中,而不是將其視為現成的、自主的聊天機器人。
在現有文件中,作者特別強調 esp32-ai 是一個獨立開發的專案。 llama2.c Andrej Karpathy 的工作以及先前在 ESP32-S3 上發布的第 260 萬個模型僅作為參考和前期工作的指導原則:程式碼、檢查點和方法論並非直接借鑒自他們。 esp32-ai 原始碼 本作品採用 MIT 許可證發布。.
來源: linux.org.ru
