

As deel van die Qwenputer-projek het navorsers 'n uitgebreide weergawe van die Qwen3.5-4B KI-model ontwikkel, wat 'n ingebedde simulator van 'n volwaardige 32-bis SVE implementeer gebaseer op die RISC-V-argitektuur (RV32IM), wat die Zba-uitbreiding ondersteun en toegerus is met 'n bignum-koverwerker vir grootgetal-rekenkunde. Die SVE-kernimplementering word saamgestel in 'n stel gewigte en geïntegreer in 'n groter taalmodel as 11 bykomende lae transformators wat bygevoeg word voor die hoof Qwen-lae. Berekeninge word direk uitgevoer tydens die voorwaartse deurgang van die neurale netwerk, sonder die behoefte aan eksterne gereedskap of inproppe.
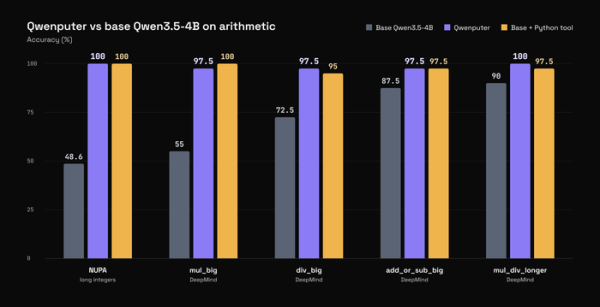
Die implementering slaag suksesvol alle toetse in die amptelike riscv-toetse-suite en is in staat om saamgestelde C- en MicroPython-kode uit te voer. Wanneer rekenkundige berekeninge met groot getalle uitgevoer word, bereik Qwenputer 'n akkuraatheid van 97.5-100%, wat vergelykbaar is met of beter is as die basislyn Qwen3.5-model met 'n eksterne Python-interpreteerder.
Om RAM te simuleer, gebruik die model aparte Gated DeltaNet-lae (lineêre RNN'e), wat in die standaard Qwen KI-model gebruik word om die gewysigde toestand te behou wanneer met groot konteksvensters gewerk word. Deur die hektoestand te sluit en een-warm kodering te gebruik, oorskryf elke skryfversoek presies een ry van die toestandsmatriks, wat toelaat dat die DeltaNet-toestand as 'n vaste-grootte adresseerbare geheue gebruik kan word, wat lineêre groei van die Sleutelwaarde (KV)-kas vermy soos die kontekslengte toeneem. Hierdie geheue akkommodeer SVE-registers, data en uitvoerbare masjienkode.
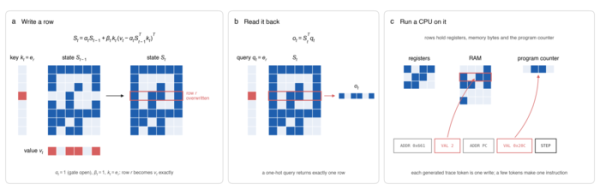
Verwerkerinstruksies, soos registerlesing, rekenkundige bewerkings en voorwaardelike spronge, word direk in die transformatorlaaggewigte saamgestel. Elke instruksie word geassosieer met spesiale tokens (ADDR, VAL, STEP), wat die KI-modellae as SVE-logika interpreteer. 'n Klein eksterne drywer, RvChat, word gebruik om die SVE te initialiseer en die firmware te laai, maar die masjienkode self word volledig binne die modelgewigte verwerk.
Die projek se beperkings sluit in 'n rofweg tweevoudige toename in grootte (18.8 GB) in vergelyking met die oorspronklike Qwen-model wanneer toestandssnitte (kontrolepunte) behoue bly, hoofsaaklik as gevolg van die bykomende opvulling van bykomende lae. 'n Relatief lae berekeningspoed word ook opgemerk (ongeveer 3 200 tokens per sekonde op 'n L4 GPU), wat beteken dat komplekse berekeninge sekondes eerder as millisekondes kan neem.
Daarbenewens is 'n variant van die KI-model geïmplementeer met 'n eksperimentele lêerstelsel, wat die berging van tot 512 lêers met 53 000 tekstokens binne die KI-model se gewigte moontlik maak. Soos met die RAM-implementering, word berging georganiseer gebaseer op DeltaNet-toestande, maar dit verskil deurdat die FS volgehoue berging bied wat nie toestand tussen sessies verloor nie.
Qwenputer se werk het ook die basis gevorm vir navorsing oor nuwe potensiële sekuriteitskwessies in KI. Deur Qwenputer as voorbeeld te gebruik, is gedemonstreer hoe 'n spesiaal gemodifiseerde KI-model sy redenasie in 'n RNN-toestand kan versteek en modelredenasiemoniteringsmeganismes (CoT, Chain-of-Thought) kan omseil. Daar is ook gedemonstreer
die vermoë om sekuriteitsbeheer- en moniteringsmeganismes te skep wat in die gewigte van die KI-model ingebou is, wat die model self nie kan deaktiveer of wysig nie.
Bron: opennet.ru
