

Neke kompanije, uključujući našeg klijenta, razvijaju svoj proizvod putem partnerske mreže. Na primjer, veliki internet-prodavači integrirani su sa uslugom dostave — naručujete proizvod i uskoro dobijate broj za praćenje paketa. Drugi primjer — zajedno sa avionskom kartom kupujete osiguranje ili kartu za aerodromski ekspres.
Za to se koristi jedan API, koji treba dodijeliti partnerima putem API Gateway-a. Ovu smo zadaću riješili. U ovom članku će biti detalji.
Dat je: ekosistem i API portal s sučeljem, gdje su korisnici registrirani, dobivaju informacije itd. Trebamo napraviti jednostavan i pouzdan API Gateway. U procesu smo morali osigurati
- registraciju,
- kontrolu povezivanja na API,
- praćenje kako korisnici koriste krajnji sustav,
- pratiti poslovne pokazatelje.
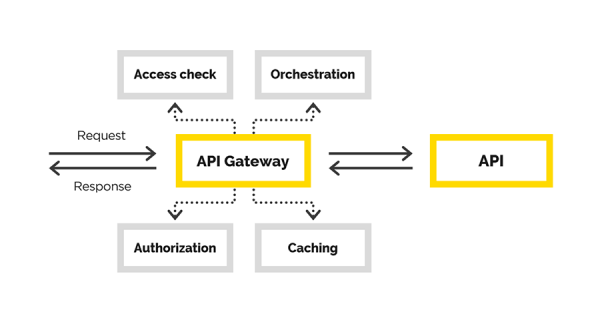
U članku ćemo govoriti o našem iskustvu u izradi API Gateway-a, tokom kojeg smo rješavali sljedeće zadatke:
- autentikacija korisnika,
- autorizacija korisnika,
- modifikacija izvorne prijave,
- proksiranje prijave,
- postobrada odgovora.
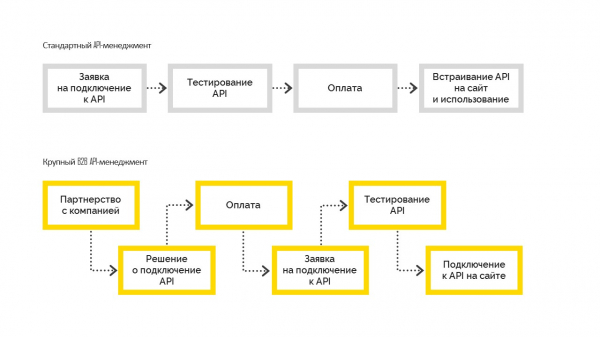
Postoje dva tipa upravljanja API-jem:
1. Standardni, koji funkcioniše na sljedeći način. Prije povezivanja korisnik testira mogućnosti, zatim plaća i ugrađuje na svoju web stranicu. Najčešće ga koriste mala i srednja preduzeća.
2. Veliko B2B upravljanje API-jem, kada kompanija prvo donosi poslovnu odluku o povezivanju, postaje partner kompanije sa ugovornim obvezama, nakon čega se povezuje na API. I tek nakon završetka svih formalnosti kompanija dobija probni pristup, prolazi testiranje i ulazi u proizvodnju. No, to nije moguće bez upravljačke odluke o povezivanju.
Naše rješenje
U ovom dijelu ćemo govoriti o izradi API Gateway-a.
Krajnji korisnici izrađenog API Gateway-a su partneri našeg klijenta. Za svakog od njih već imamo potrebne ugovore. Trebat ćemo samo proširiti funkcionalnost, označujući dodijeljeni pristup gateway-u. Prema tome, potreban je kontrolirani proces povezivanja i upravljanja.
Nesumnjivo je bilo moguće uzeti neko već spremno rješenje za rješavanje zadatka upravljanja API-jem i izradu API Gateway-a posebno. Na primjer, to bi moglo biti. Nije nam to odgovaralo jer smo u našem slučaju već imali API portal i ogromnu ekosistem izgrađenu oko njega. Svi su korisnici već bili registrovani, oni su već razumeli gde i kako mogu dobiti potrebne informacije. U API portalu su već postojali potrebni interfejsi, jedino nam je trebao API Gateway. I time smo se prvenstveno bavili.
Ono što zovemo API Gateway je zapravo neka vrsta proksija. Ponovo smo imali izbor — mogli smo napisati svoju proksiju ili odabrati nešto već dostupno. U ovom slučaju smo odabrali drugi put i izabrali kombinaciju nginx+Lua. Zašto? Potreban nam je bioPouzdan, testiran softver koji podržava skalabilnost. Nismo želeli da nakon implementacije proveravamo i tačnost poslovne logike i ispravnost rada proksija.
Svaki veb server ima konvejer za obradu zahteva. U slučaju nginx, on izgleda ovako:
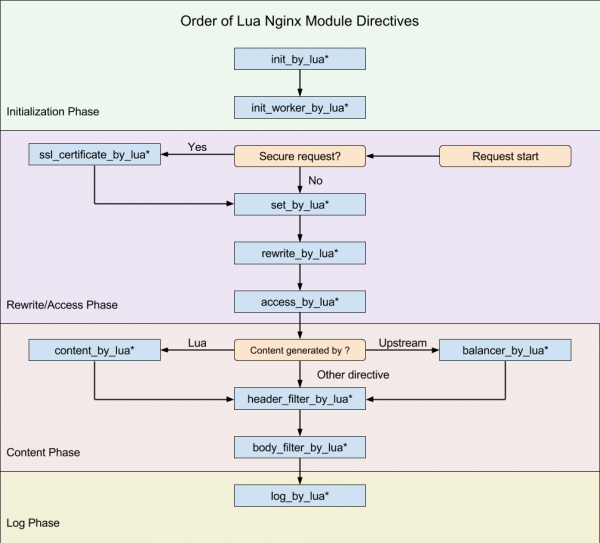
(shema iz )
Naš cilj je bio da se integrišemo u ovaj konvejer u trenutku kada možemo da modifikujemo izvorni zahtev.
Želimo da kreiramo transparentnu proksiju, tako da funkcionalno zahtev ostane onakav kakav je i stigao. Samo kontrolišemo pristup krajnjem API-ju, pomažemo zahtevu da dođe do njega. U slučaju da je zahtev bio neispravan, grešku treba da pokaže krajnji API, a ne mi. Jedini razlog zbog kojeg možemo odbiti zahtev je nedostatak pristupa klijenta.
Za nginx već postoji na . Lua je skriptni jezik, vrlo lagan i lak za učenje. Tako smo potrebnu logiku implementirali pomoću Lua.
Konfiguracija nginx-a (analogija rute aplikacije), gde se obavlja sav rad, je prilično razumljiva. Ovde je zanimljiva poslednja direktiva — post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Pogledajmo šta se događa u ovoj konfiguraciji:
more_clear_input_headers — čisti vrednost navedenih hedera nakon direktive.
lua_need_request_body — reguliše da li treba pročitati izvorno telo zahteva pre nego što se izvrše direktive rewrite/access/access_by_lua ili ne. Po defaultu nginx ne čita telo zahteva klijenta, a ako vam je potrebno da mu pristupite, ova direktiva treba da ima vrednost on.
rewrite_by_lua_file — putanja do skripte koja opisuje logiku za modifikaciju zahteva
access_by_lua_file — putanja do skripte koja opisuje logiku, koja proverava pristup resursu.
proxy_pass — url, na koji će zahtev biti proksiran.
body_filter_by_lua_file — putanja do skripte koja opisuje logiku za filtriranje zahteva pre nego što se vrati klijentu.
I na kraju, post_action — zvanično nedokumentovana direktiva koja omogućava izvršavanje dodatnih radnji nakon što je odgovor dat klijentu.
Sledeće ćemo objasniti redosledom kako smo rešavali svoje zadatke.
Autorizacija/ autentifikacija i modifikacija zahteva
Autorizacija
Autorizaciju i autentifikaciju postavili smo pomoću pristupa putem sertifikata. Postoji korenski sertifikat. Svakom novom klijentu naručioca generiše se lični sertifikat preko kojeg može dobiti pristup API-u. Ovaj sertifikat se konfiguriše u sekciji server podešavanja nginx-a.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modifikacija
Postavlja se opravdano pitanje: šta učiniti sa sertifikovanim klijentom ako naglo poželimo da ga isključimo iz sistema? Zar da ne izdamo nove sertifikate za sve ostale klijente.
Tako smo se polako približili sledećem zadatku — modifikaciji izvorne zahteve. Izvorni zahtev klijenta, uopšte govoreći, nije validan za krajnji sistem. Jedan od zadataka je da se doda ono što nedostaje, kako bi postao validan. Suština je u tome da su nedostatni podaci različiti za svakog klijenta. Znamo da klijent dolazi kod nas sa sertifikatom, sa kojeg možemo uzeti otisak i izvući potrebne podatke iz baze.
Ako u nekom trenutku bude potrebno isključiti klijenta iz naše usluge, njegovi podaci će nestati iz baze i on neće moći ništa da uradi.
Rad sa podacima klijenta
Morali smo osigurati visoku dostupnost rešenja, posebno u načinu na koji dobijamo podatke klijenta. Teškoća leži u tome što je izvor tih podataka — spoljni servis koji ne garantuje neprekidno i dovoljno visoku brzinu rada.
Zato smo morali obezbediti visoku dostupnost podataka klijenata. Kao alat odabrali smo , koji nam pruža:
- brzi pristup podacima,
- mogućnost organizovanja klastera od više čvorova sa replikovanim podacima na različitim čvorovima.
Odabrali smo najjednostavniju strategiju isporuke podataka u keš:
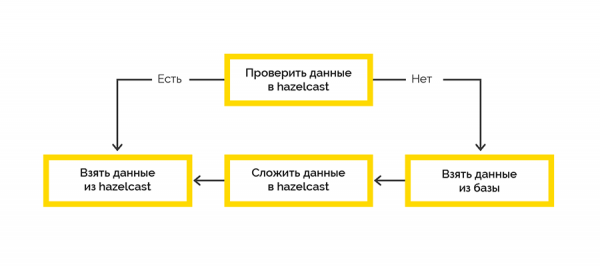
Rad sa krajnjim sistemom se odvija u okviru sesija i postoji limit na maksimalan broj. Ako klijent ne zatvori sesiju, to ćemo morati da uradimo mi.
Podaci o otvorenoj sesiji dolaze od krajnjeg sistema i prvo se obrađuju na strani Lua. Odlučili smo se za korišćenje Hazelcast-a za čuvanje ovih podataka radnim zadatkom napisanom u .NET-u. Potom, s određenim vremenskim intervalima, proveravamo pravo na život otvorenih sesija i zatvaramo iste.
Pristup Hazelcast-u i iz Lua, i iz .NET-a
Klijenata na Lua za rad sa Hazelcast-om nema, ali Hazelcast ima REST API koji smo odlučili da iskoristimo. Za .NET postoji , preko kojeg smo planirali da dobijemo pristup podacima Hazelcast-a na strani .NET-a. Ali nije bilo tako jednostavno.
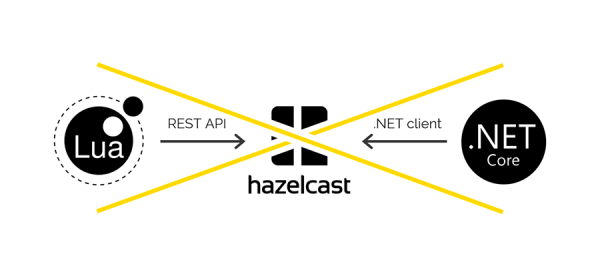
Pri čuvanju podataka putem REST-a i ekstrakciji putem .NET klijenta koriste se različiti serijalizatori i deseralizatori. Stoga nije moguće dodati podatke putem REST-a i izvući ih preko .NET klijenta, i obrnuto.
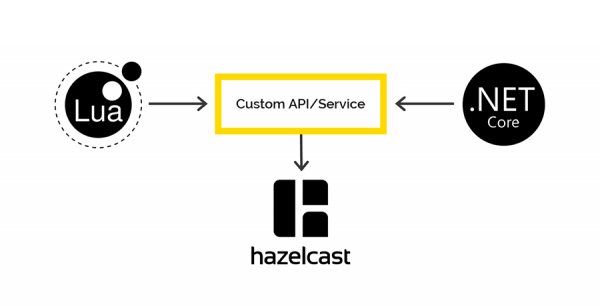
Ako bude zainteresovanih, detaljnije ćemo govoriti o ovom problemu u posebnom članku. Spoiler — na šemi.
Logovanje i nadzor
Naš korporativni standard za logovanje putem .NET-a je Serilog, svi logovi na kraju završe u Elasticsearch-u, a analizu vršimo putem Kibane. Nešto slično smo želeli da uradimo i u ovom slučaju. Jedini alat za rad sa Elastic-om na Lua, koji je pronađen, srušio se prilikom prve require. Tako smo koristili Fluentd.
— open source rešenje za obezbeđivanje jedinstvenog sloja logovanja aplikacije. Omogućava prikupljanje logova sa različitih slojeva aplikacije, a zatim njihovo preusmeravanje u jedinstveni izvor.
API Gateway radi u K8S, stoga smo odlučili da dodamo kontejner sa fluentd-om u istu podu, kako bismo pisali logove u postojeći otvoreni tcp port fluentd-a.
Takođe smo istražili kako će se fluentd ponašati ako ne bude veze sa Elasticsearch-om. Tokom dva dana, u pristupnik su bez prekida dolazili zahtevi, dok su logovi slati u fluentd, ali je fluentd-ov IP bio blokiran od strane Elastic-a. Nakon ponovnog uspostavljanja veze, fluentd je odlično prenio sve logove u Elastic.
Zaključak
Odabrani pristup implementaciji omogućio nam je isporuku funkcionalnog proizvoda u proizvodno okruženje za samo 2,5 meseca.
Ako ikada budete radili slične stvari, savetujemo vam da prvo jasno razumete koji problem rešavate i koje resurse već imate. Budite pažljivi prema teškoćama integracije s postojećim sistemima upravljanja API-jem.
Razumite za sebe šta tačno planirate da razvijate — samo poslovnu logiku obrade zahteva ili, kao što je to bio slučaj kod nas, ceo proxy. Ne zaboravite da sve što uradite sami mora kasnije biti temeljno testirano.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish