

Hallo zusammen, wir teilen mit euch den zweiten Teil des Artikels „Virtuelle Dateisysteme in Linux: Wozu sie gut sind und wie sie funktionieren?“ Den ersten Teil könnt ihr lesen. Wir erinnern daran, dass diese Artikelreihe an den Start eines neuen Kurses gebunden ist, der schon bald beginnt.
Wie man VFS mit den Tools eBPF und bcc überwacht
Der einfachste Weg zu verstehen, wie der Kernel mit Dateien umgeht sysfs ist, dies praktisch zu beobachten, und der einfachste Weg, ARM64 zu beobachten, ist die Verwendung von eBPF. eBPF (Abkürzung für Berkeley Packet Filter) besteht aus einer virtuellen Maschine, die im ausgeführt wird und von privilegierten Benutzern über die Kommandozeile abgefragt werden kann.queryDer Quellcode des Kernels informiert den Leser darüber, was der Kernel tun kann; die Ausführung von eBPF-Tools in einem belasteten System zeigt tatsächlich, was der Kernel macht.
Glücklicherweise ist der Einstieg in die Verwendung von eBPF mit den Tools, die als Pakete aus der allgemeinen Distribution verfügbar sind, recht einfach. Diese sind ausführlich dokumentiert . Die Tools bcc sind Python-Skripte mit kleinen C-Code-Einsprengseln, was bedeutet, dass jeder, der mit beiden Sprachen vertraut ist, sie leicht modifizieren kann. In bcc/tools gibt es 80 Python-Skripte, das bedeutet, dass der Entwickler oder Systemadministrator wahrscheinlich etwas Passendes zur Lösung des Problems finden kann.
Um zumindest einen oberflächlichen Eindruck davon zu bekommen, welche Arbeit VFS in einem laufenden System leisten, versucht vfscount oder vfsstat.Das zeigt beispielsweise, dass Dutzende von Aufrufen vfs_open() und seiner „Freunde“ buchstäblich jede Sekunde stattfinden.
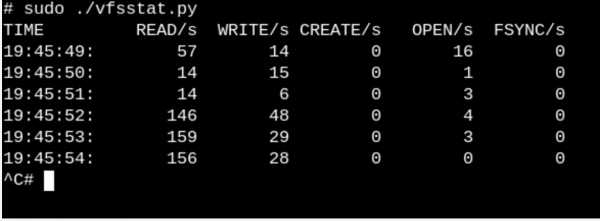
vfsstat.pyist ein Python-Skript mit C-Code-Einsprengseln, das einfach die Funktionsaufrufe von VFS zählt.
Lassen Sie uns ein trivialeres Beispiel anführen und sehen, was passiert, wenn wir einen USB-Stick an den Computer anschließen und das System ihn erkennt.
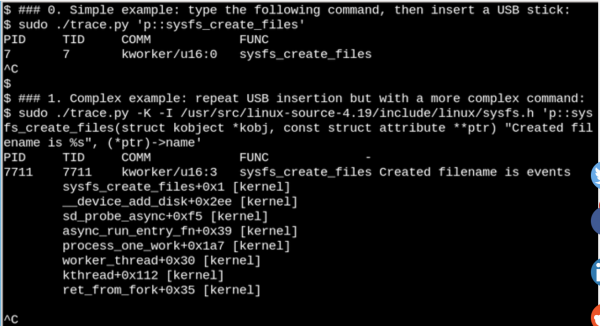
Mit eBPF kann man beobachten, was passiert,
/syswenn ein USB-Stick eingesteckt wird. Hier wird ein einfaches sowie ein komplexes Beispiel gezeigt.
Im obigen Beispiel bcc Tool gibt eine Nachricht aus, wenn der Befehl sysfs_create_files()ausgeführt wird. Wir sehen, dass sysfs_create_files() dies durch einen kworker-Thread als Reaktion auf das Einstecken des Sticks gestartet wurde, aber welche Datei wurde dabei erstellt? Das zweite Beispiel zeigt die gesamte Kraft von eBPF. Hier der Datenstrom als Reaktion darauf, dass der USB-Stick eingesteckt wurde, aber welche Datei dabei erstellt wurde? Das zweite Beispiel zeigt die gesamte Leistungsfähigkeit von eBPF. Hier trace.py gibt den Kernel-Backtrace (Option -K) und den Namen der erstellten Datei aus sysfs_create_files(). Die Einfügung in einfache Anführungszeichen ist C-Code, der eine leicht erkennbare Formatzeichenfolge enthält, die von einem Python-Skript bereitgestellt wird, das LLVM ausführt Just-in-time-Compiler. Diese Zeichenfolge wird kompiliert und in der virtuellen Maschine innerhalb des Kernels ausgeführt. Die vollständige Funktionssignatur sysfs_create_files () muss im zweiten Befehl reproduziert werden, damit sich die Formatzeichenfolge auf einen der Parameter beziehen kann. Fehler in diesem C-Code-Fragment führen zu erkennbaren Fehlern des C-Compilers. Wenn beispielsweise der Parameter -l fehlt, sehen Sie „Failed to compile BPF text.“ Entwickler, die mit C und Python vertraut sind, finden die Werkzeuge bcc einfach zu erweitern und zu ändern.
Wenn das USB-Laufwerk eingesteckt ist, zeigt der Kernel-Backtrace, dass PID 7711 der Thread ist kworker-Thread als Reaktion auf das Einstecken des Sticks gestartet wurde, aber welche Datei wurde dabei erstellt? Das zweite Beispiel zeigt die gesamte Kraft von eBPF. Hier, der die Datei erstellt hat "events" in sysfs. Dementsprechend zeigt der Aufruf von sysfs_remove_files() an, dass das Entfernen des Laufwerks zur Löschung der Datei führte, eventswas dem allgemeinen Konzept der Referenzzählung entspricht. Gleichzeitig zeigt die Betrachtung von sysfs_create_link () mit eBPF während des Einsteckens des USB-Laufwerks, dass mindestens 48 symbolische Links erstellt wurden.
Was ist also der Sinn der Datei events? Die Verwendung von zum Suchen von , zeigt, dass sie disk_add_events ()aufruft, und entweder "media_change", oder oder "eject_request"
können in die Ereignisdatei geschrieben werden. Hier informiert die Blockschicht des Kernels den Userspace über das Einlegen und Auswerfen der „Festplatte“. Beachten Sie, wie informativ dieser Forschungsansatz beim Einstecken des USB-Laufwerks ist, im Vergleich zu dem Versuch, herauszufinden, wie alles nur aus dem Quellcode funktioniert.
Schreibgeschützte Root-Dateisysteme ermöglichen integrierte Geräte Natürlich zieht niemand den Stecker aus der Steckdose, um einen Server oder Computer auszuschalten. Aber warum? Weil die gemounteten Dateisysteme auf physischen Speichermedien verzögerte Schreibvorgänge haben können, und die Datenstrukturen, die ihren Status aufzeichnen, möglicherweise nicht mit den Aufzeichnungen im Speicher synchronisiert sind. Wenn das passiert, müssen die Systembesitzer bis zum nächsten Booten warten, um das Dienstprogramm fsck filesystem-recovery zu starten, und im schlimmsten Fall Daten verlieren.
Dennoch wissen wir alle, dass viele IoT-Geräte sowie Router, Thermostate und Autos inzwischen unter Linux laufen. Viele dieser Geräte haben praktisch keine Benutzeroberfläche und es gibt keinen Weg, sie 'sauber' auszuschalten. Stellen Sie sich vor, Sie starten ein Auto mit einer leeren Batterie, wenn die Stromversorgung des Steuergeräts ständig hin und her schwankt. Wie kommt es, dass das System ohne eine lange fsck, wenn der Motor schließlich zu laufen beginnt? Die Antwort ist einfach. Eingebettete Geräte verlassen sich auf das Root-Dateisystem (kurz gesagt, ro-rootfs (read-only root filesystem)).
ro-rootfs bieten viele Vorteile, die weniger offensichtlich sind als die Unveränderlichkeit. Ein Vorteil besteht darin, dass Malware nicht in das /usr oder /lib, wenn kein Linux-Prozess dorthin schreiben kann. Ein weiterer Vorteil liegt darin, dass ein weitgehend unveränderliches Dateisystem entscheidend für die Unterstützung von entfernten Geräten im Feld ist, da das unterstützende Personal lokale Systeme verwendet, die nominell identisch mit den vor Ort eingesetzten Systemen sind. Möglicherweise ist der wichtigste (aber auch heimtückischste) Vorteil, dass ro-rootfs Entwickler zwingt, bereits in der Entwurfsphase zu entscheiden, welche systemrelevanten Objekte unveränderlich sein werden. Die Arbeit mit ro-rootfs kann unbequem und schmerzhaft sein, wie es oft mit const-Variablen in Programmiersprachen der Fall ist, aber ihre Vorteile überwiegen leicht die zusätzlichen Kosten.
Erstellen rootfs nur zum Lesen erfordert einige zusätzliche Anstrengungen von den Entwicklern eingebetteter Systeme, und hier kommt VFS ins Spiel. Linux erfordert, dass Dateien in /var schreibbar sind, und darüber hinaus werden viele beliebte Anwendungen, die eingebettete Systeme ausführen, versuchen, Konfigurations- dot-files in $HOMEzu erstellen. Eine Lösung für Konfigurationsdateien im Home-Verzeichnis besteht normalerweise darin, sie im Voraus zu generieren und in rootfs. Für /var einen möglichen Ansatz besteht darin, ihn in einem separaten schreibbaren Bereich zu mounten, während das eigentliche / nur schreibgeschützt gemountet wird. Eine weitere beliebte Alternative ist die Verwendung von bind- oder Overlay-Mounts.
Bindende und überlagernde Mounts, ihre Verwendung durch Container
Ausführung eines Befehls man mount – der beste Weg, um mehr über bindende und überlagernde Mounts zu erfahren, die Entwicklern und Systemadministratoren ermöglichen, ein Dateisystem unter einem Pfad zu erstellen und es dann unter einem anderen Pfad für Anwendungen bereitzustellen. Für eingebettete Systeme bedeutet dies die Möglichkeit, Dateien zu speichern in /var auf einem schreibgeschützten USB-Stick, aber die Überlagerung oder bindende Montage eines Pfades von tmpfs in /var beim Booten ermöglicht es Anwendungen, dort Notizen (scrawl) zu schreiben. Bei der nächsten Aktivierung gehen die Änderungen in /var verloren. Die Überlagerungsmontage erzeugt eine Verbindung zwischen tmpfs und dem zugrunde liegenden Dateisystem und ermöglicht es, angebliche Änderungen an vorhandenen Dateien in ro-tootf während bindende Mounts neue leere tmpfs Ordner sichtbar machen können, die in ro-rootfs den Pfaden verfügbar sind. Während overlayfs der richtige (proper) Typ des Dateisystems ist, wird bindende Montage im .
Basierend auf der Beschreibung der Überlagerungs- und bindenden Montage ist es nicht verwunderlich, dass sie aktiv nutzen. Lassen Sie uns beobachten, was passiert, wenn wir verwendet, um einen Container mit dem Tool zu starten mountsnoop. ab bcc.
Aufruf system-nspawn startet den Container, während mountsnoop.py.
Schauen wir uns an, was herausgekommen ist:
Starten mountsnoop. während des "Bootvorgangs" des Containers zeigt, dass die Ausführungsumgebung des Containers stark von der bindenden Montage abhängt (es wird nur der Anfang einer langen Ausgabe angezeigt).
Hier systemd-nspawn stellt ausgewählte Dateien von . Funktionen und sysfs dem Host im Container als Pfade in seiner rootfs. Neben MS_BIND Flag, das die bindende Montage setzt, bestimmen einige andere Flags im montierten System die Beziehung zwischen den Änderungen im Namespace des Hosts und des Containers. Zum Beispiel kann eine bindende Montage entweder Änderungen in /proc und /sys im Container übergehen oder sie je nach Aufruf verbergen.
Fazit
Das Verständnis der internen Struktur von Linux kann wie eine unlösbare Aufgabe erscheinen, da der Kernel selbst eine riesige Menge an Code enthält, ganz zu schweigen von den Anwendungen des Benutzerraums von Linux und den Systemaufrufschnittstellen in C-Bibliotheken, wie glibc. Eine Möglichkeit, Fortschritte zu erzielen, besteht darin, den Quellcode eines Teilsystems des Kernels zu lesen und sich auf das Verständnis von Systemaufrufen und Headern, die den Benutzerspeicher ansprechen, sowie der grundlegenden internen Schnittstellen des Kernels zu konzentrieren, zum Beispiel die Tabelle. file_operations. Dateioperationen entsprechen dem Prinzip "alles ist eine Datei", weshalb die Verwaltung dieser besonders angenehm ist. Die Quellcodes des Kernels in C befinden sich im oberen Verzeichnis. fs/ Sie stellen die Implementierung virtueller Dateisysteme dar, die als Schicht fungieren, die eine breite und relativ einfache Kompatibilität mit beliebten Dateisystemen und Speichergeräten bietet. Das Binden und Mappen über Linux-Namensräume ist das Geheimnis von VFS, das die Erstellung von Containern und von schreibgeschützten Root-Dateisystemen ermöglicht. In Kombination mit dem Studium des Quellcodes machen die eBPF-Kerneltools und ihre Schnittstelle bcc
die Untersuchung des Kernels einfacher als je zuvor.
Freunde, war dieser Artikel hilfreich für euch? Habt ihr irgendwelche Kommentare oder Anmerkungen? Und diejenigen, die sich für den Kurs "Linux-Administrator" interessieren, laden wir ein zu , der am 18. April stattfinden wird.
Quelle: habr.com
