

به عنوان بخشی از پروژه Qwenputer، محققان نسخه توسعهیافتهای از مدل هوش مصنوعی Qwen3.5-4B را توسعه دادند که یک شبیهساز تعبیهشده از یک پردازنده ۳۲ بیتی کامل مبتنی بر معماری RISC-V (RV32IM) را پیادهسازی میکند، از افزونه Zba پشتیبانی میکند و به یک کمکپردازنده bignum برای محاسبات اعداد بزرگ مجهز است. پیادهسازی هسته پردازنده به مجموعهای از وزنها کامپایل شده و در یک مدل زبان بزرگتر به صورت ۱۱ لایه اضافی از مبدلها که قبل از لایههای اصلی Qwen اضافه شدهاند، ادغام میشود. محاسبات مستقیماً در طول عبور رو به جلوی شبکه عصبی، بدون نیاز به ابزارها یا افزونههای خارجی انجام میشوند.
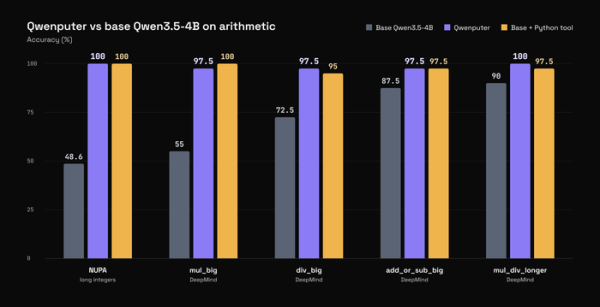
این پیادهسازی با موفقیت تمام تستهای موجود در مجموعه رسمی riscv-tests را پشت سر میگذارد و قادر به اجرای کد کامپایلشده C و MicroPython است. هنگام انجام محاسبات حسابی با اعداد بزرگ، Qwenputer به دقت ۹۷.۵ تا ۱۰۰٪ دست مییابد که قابل مقایسه یا بهتر از مدل پایه Qwen3.5 با یک مفسر پایتون خارجی است.
برای شبیهسازی RAM، این مدل از لایههای جداگانهی Gated DeltaNet (RNNهای خطی) استفاده میکند که در مدل استاندارد Qwen AI برای حفظ حالت اصلاحشده هنگام کار با پنجرههای متنی بزرگ استفاده میشوند. با قفل کردن حالت دروازه و استفاده از کدگذاری وان-هات، هر درخواست نوشتن دقیقاً یک ردیف از ماتریس حالت را رونویسی میکند و به حالت DeltaNet اجازه میدهد تا به عنوان حافظهی آدرسپذیر با اندازهی ثابت استفاده شود و از رشد خطی حافظهی نهان Key-Value (KV) با افزایش طول متن جلوگیری شود. این حافظه، رجیسترهای CPU، دادهها و کد ماشین اجرایی را در خود جای میدهد.
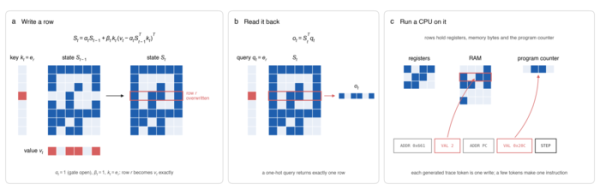
دستورالعملهای پردازنده، مانند خواندن رجیستر، عملیات حسابی و پرشهای شرطی، مستقیماً در وزنهای لایه ترانسفورماتور کامپایل میشوند. هر دستورالعمل با توکنهای ویژه (ADDR، VAL، STEP) مرتبط است که لایههای مدل هوش مصنوعی آنها را به عنوان منطق CPU تفسیر میکنند. یک درایور خارجی کوچک، RvChat، برای مقداردهی اولیه CPU و بارگذاری میانافزار استفاده میشود، اما خود کد ماشین کاملاً در وزنهای مدل پردازش میشود.
محدودیتهای این پروژه شامل افزایش تقریباً دو برابری حجم (۱۸.۸ گیگابایت) در مقایسه با مدل اصلی Qwen هنگام حفظ برشهای حالت (ایستگاههای بازرسی) است، که در درجه اول به دلیل لایهبندی اضافی لایههای اضافی است. سرعت محاسبه نسبتاً پایین نیز ذکر شده است (تقریباً ۳۲۰۰ توکن در ثانیه در یک پردازنده گرافیکی L4)، به این معنی که محاسبات پیچیده میتوانند به جای میلیثانیه، چند ثانیه طول بکشند.
علاوه بر این، نوعی از مدل هوش مصنوعی با یک سیستم فایل آزمایشی پیادهسازی شد که امکان ذخیرهسازی حداکثر ۵۱۲ فایل با ۵۳۰۰۰ توکن متنی را در وزنهای مدل هوش مصنوعی فراهم میکند. همانند پیادهسازی RAM، ذخیرهسازی بر اساس حالتهای DeltaNet سازماندهی میشود، اما تفاوت آن در این است که FS ذخیرهسازی پایداری را ارائه میدهد که حالتها را بین جلسات از دست نمیدهد.
کار Qwenputer همچنین پایه و اساس تحقیقات در مورد مسائل امنیتی بالقوه جدید در هوش مصنوعی را تشکیل داد. با استفاده از Qwenputer به عنوان مثال، نشان داده شد که چگونه یک مدل هوش مصنوعی اصلاحشده میتواند استدلال خود را در حالت RNN پنهان کند و مکانیسمهای نظارت بر استدلال مدل (CoT، Chain-of-Thought) را دور بزند. همچنین نشان داده شد
توانایی ایجاد مکانیزمهای کنترل و نظارت امنیتی که در وزنهای مدل هوش مصنوعی تعبیه شدهاند و خود مدل نمیتواند آنها را غیرفعال یا تغییر دهد.
منبع: opennet.ru
