

شرکت کانونیکال (Canonical) نسخه اولیهای از سیستم تشخیص گفتار Myna و ابزارهای تبدیل صدا به متن مبتنی بر آن را منتشر کرده است که با ... Ubuntuمجامع آماده برای تشکیل شده اند Ubuntu ۲۴.۰۴.۳ نسخه بلندمدت، Ubuntu ۲۲.۰۴ LTS و Ubuntu 26.10 در بستههایی برای معماریهای amd64 و amd64v3. پشتیبانی از دسکتاپهای GNOME با استفاده از پروتکل Wayland در دسترس است. برای تشخیص گفتار، میتوانید از بین مدلهای هوش مصنوعی Whisper، Parakeet یا Funasr یکی را انتخاب کنید که به صورت محلی اجرا میشوند و از چندین زبان پشتیبانی میکنند.
Myna Shell، یک افزونهی GNOME Shell، برای یکپارچهسازی با دسکتاپ توسعه داده شده است. ورودی صوتی با فشار دادن Super+J فعال میشود، پس از آن میتوانید متن را با صدای بلند دیکته کنید و دوباره Super+J را فشار دهید تا جلسه دیکته پایان یابد. متن دیکته شده با استفاده از ورودی صفحه کلید شبیهسازی شده در برنامه فعلی وارد میشود.
اکنون بخش پیکربندی شامل بخشی برای تنظیم ترکیب کلید فعالسازی، نشانگر شروع/توقف تشخیص، خاموش شدن خودکار پس از مدت زمان مشخصی از سکوت و حالت جایگزینی متن (هنگام صحبت یا بلافاصله پس از تکمیل دیکته) و همچنین انتخاب مدل هوش مصنوعی است. یک موتور تشخیص گفتار با شتابدهنده سختافزاری اکنون برای سیستمهایی با پردازندههای گرافیکی NVIDIA در دسترس است (سایر گزینههای شتابدهی بعداً در دسترس خواهند بود).
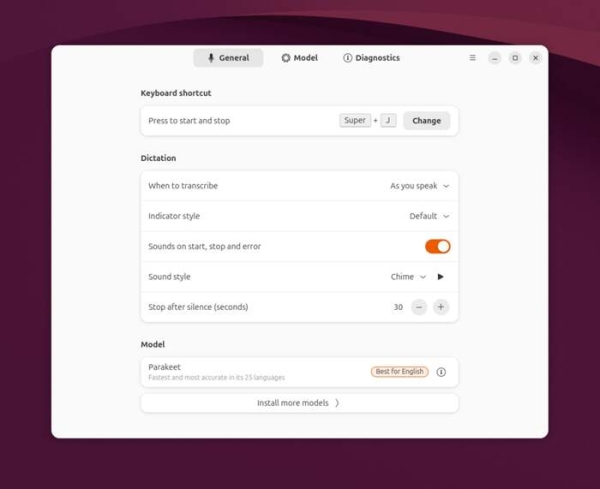
نصب از طریق مخزن PPA انجام میشود:
sudo add-apt-repository ppa:canonical-desktop-team/myna
دستور sudo apt install myna-config را اجرا کنید.
منبع: opennet.ru
