

Nous allons examiner les bases de la journalisation dans Docker et Kubernetes, puis nous étudierons deux outils que l'on peut utiliser en production : Grafana Loki et la pile EFK (Elasticsearch + Fluent Bit + Kibana).
Le contenu de l'article est un extrait de . Si vous êtes intéressé et qu'il y a une nécessité de production, vous pouvez suivre une formation complète - inscrivez-vous au cours sur .
Journalisation dans Docker
Au niveau de Kubernetes, les applications sont lancées dans des pods, mais à un niveau inférieur, elles fonctionnent généralement dans Docker. Il est donc nécessaire de configurer la journalisation de manière à collecter les journaux des conteneurs. Les conteneurs sont lancés par Docker — il faut donc comprendre comment la journalisation fonctionne au niveau de Docker.
J'espère que chaque lecteur sait que les journaux des applications doivent être écrits sur stdout/stderr, et non à l'intérieur du conteneur. Docker Daemon agrège les journaux, et il ne traite que ceux qui sont envoyés à stdout/stderr. De plus, enregistrer les journaux à l'intérieur du conteneur pose des problèmes : le conteneur gonfle en raison de la croissance des journaux (car il n'y a probablement pas de Logrotate dans le conteneur), et Docker Daemon n'est pas au courant de ce journal.
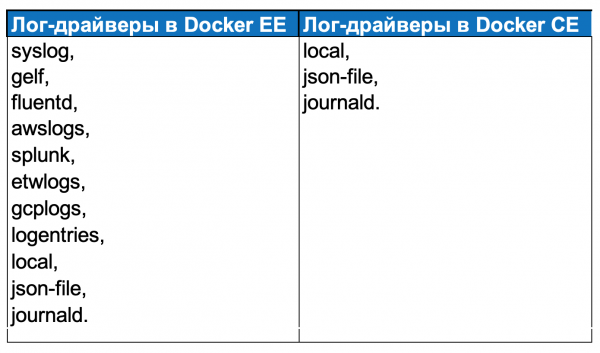
Docker dispose de plusieurs pilotes de journalisation ou plugins pour collecter les journaux des conteneurs. Dans la version gratuite, Docker Community Edition (CE), il y a moins de pilotes de journalisation que dans la version commerciale Docker Enterprise Edition (EE).
Je n'ai jamais utilisé Docker EE dans la pratique : chez Southbridge, nous essayons de nous en tenir à des solutions Open Source, et la plupart des fonctionnalités supplémentaires de Docker EE ne sont pas nécessaires pour les clients.
Pilotes de journalisation dans Docker CE :
local — enregistrement des journaux dans des fichiers internes de Docker Daemon ;
json-file — création d'un fichier json-log dans le dossier de chaque conteneur ;
journald — envoi des journaux vers journald.
Les paramètres de journalisation dans Docker se trouvent dans le fichier daemon.json.
Dans le champ « log-driver », on indique le plugin, et dans le champ « log-opts » — ses paramètres. L'exemple ci-dessus indique le plugin « json-file », la limite de taille des journaux — « max-size » : « 10m » ; la limite du nombre de fichiers (paramètres de rotation) — « max-file » : « 3 » ; ainsi que les valeurs qui seront ajoutées aux journaux.
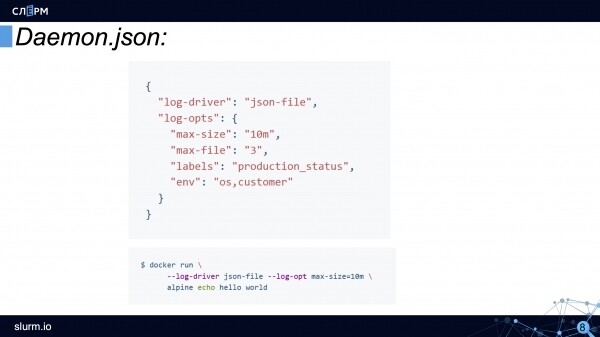
Certains paramètres du pilote de journalisation peuvent être définis via l'outil en ligne de commande. C'est pratique si un conteneur spécifique doit être lancé avec un autre pilote de journalisation.
Voici à quoi ressemble le schéma de journalisation dans Docker :
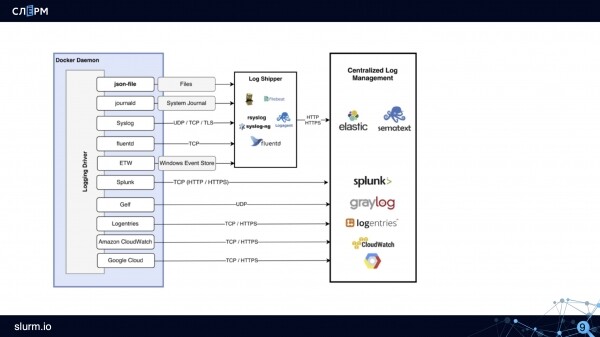
Comment le schéma fonctionne : le pilote de journalisation, par exemple json-file, crée des fichiers. Des collecteurs de journaux (Rsyslog, Fluentd, Logagent et d'autres) collectent ces fichiers et les transmettent pour stockage dans Elastic, Sematext ou d'autres systèmes de stockage.
Particularités de la journalisation dans Kubernetes
Schématiquement, la journalisation dans Kubernetes se présente ainsi : il y a un pod, à l'intérieur duquel un conteneur est en cours d'exécution, et le conteneur envoie les journaux vers stdout/stderr. Ensuite, Docker crée un fichier et enregistre les journaux, qui peuvent ensuite être tournés.
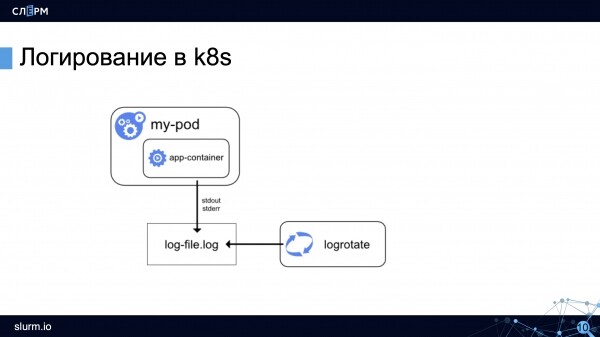
Examinons les particularités de la journalisation dans Kubernetes.
Conserver les journaux entre les déploiements. C'est une condition préalable pour une configuration correcte de la journalisation. Si les journaux ne sont pas conservés entre les déploiements, lors de la sortie d'une nouvelle version de l'application, les journaux précédents seront écrasés, et le redémarrage du conteneur entraînera également une perte de journaux. Kubernetes a une option —previous, permettant de consulter les journaux de l'application avant le dernier redémarrage du Pod, mais pas plus profondément.
Agrégé les journaux de toutes les instances. Si les microservices sont hébergés dans le cloud, le fournisseur cloud est responsable du contrôle du système. Si les microservices fonctionnent sur leur propre matériel, il est nécessaire de collecter les journaux des conteneurs ainsi que les journaux du système.
Auparavant, il n'y avait pas d'outils pratiques pour recueillir les journaux tant du système que des microservices. En général, un outil recueillait les journaux système (par exemple, Rsyslog), et un autre recueillait les journaux de Docker (comme journal-bit en configurant le pilote de journalisation Docker sur journald). Ils ont tenté d'utiliser journal-bit pour collecter les journaux des conteneurs (où le pilote de journalisation Docker spécifie d'écrire les journaux dans journald) et ceux du système (dans CentOS 7, systemd et journald sont déjà présents). La solution fonctionne, mais n'est pas idéale. Si les journaux sont nombreux, journal-bit commence à ralentir, des messages se perdent.
Les expériences ont continué - et une autre méthode a été trouvée. Dans CentOS 7, les principaux journaux système (messages, audit, secure) sont dupliqués dans var-log sous forme de fichiers. Dans Docker, il est également possible de configurer la sauvegarde des journaux dans des fichiers json. Par conséquent, ces fichiers de CentOS 7 et de Docker peuvent être collectés ensemble.
Avec le temps, la solution ELK Stack est devenue populaire. C'est une combinaison de plusieurs outils : Elasticsearch, Logstash et Kibana.
Elasticsearch stocke les journaux des conteneurs, Logstash collecte les journaux des instances, Kibana permet de traiter les journaux reçus et d'en tracer des graphiques. Pendant un certain temps, l'ELK Stack a été utilisé activement, mais à mon avis, son temps est révolu. Je vous expliquerai plus tard pourquoi.
Ajouter des métadonnées. Les pods, applications et conteneurs peuvent être exécutés n'importe où. De plus, une application peut avoir plusieurs instances. Les journaux sont enregistrés dans un format unique, et nous devons comprendre quelle réplique il s'agit, quel Pod les écrit et dans quel namespace il se trouve. C'est pourquoi il est nécessaire d'ajouter des métadonnées aux journaux.
Analyser les journaux. Il est amusant de constater que les coûts de maintenance des systèmes de journalisation et de surveillance peuvent dépasser ceux de l'application principale. Lorsque des dizaines et des centaines de milliers de journaux se produisent par seconde, cela semble logique, mais il est néanmoins essentiel de connaître les limites. Un moyen de trouver ces limites est l'analyse des journaux.
En général, il n'est pas nécessaire de collecter et de stocker tous les journaux, il faut envoyer au stockage uniquement une partie — par exemple, les journaux avec le statut « warning » ou « error ». S'il s'agit de journaux nginx ou de contrôleurs d'entrée, seuls ceux dont le statut est différent de 200 doivent être envoyés au stockage. Toutefois, ce n'est pas un conseil universel : si vous construisez des analyses basées sur les journaux Nginx, il est évident qu'il vaut la peine de les collecter.
Il est déconseillé de filtrer les journaux sans réflexion, car les données filtrées peuvent ne pas suffire pour une analyse normale. D'autre part, il est possible que l'analyse doive se faire non pas au niveau de la journalisation, mais au niveau de la collecte des métriques. Cela éviterait d'avoir à stocker des centaines de milliers de lignes avec le code 200. L'une des approches consiste à obtenir des informations sur le trafic et les erreurs à partir des métriques des contrôleurs d'entrée.
En général, il faut bien réfléchir à ce que vous souhaitez stocker et pendant combien de temps, sinon il y aura une situation où le système de journalisation consommera plus de ressources que le projet principal.
Il n'existe pas encore de solution standard pour la journalisation. Contrairement à la surveillance, où il y a une solution prédominante, Prometheus, il n'y a pas de norme en matière de journalisation.
Dans le cadre de cette conférence, nous examinerons deux outils : l'un populaire et l'autre en pleine croissance. En plus de ceux-ci, il en existe d'autres, mais nous ne les aborderons pas dans cet article.
Compte tenu de toutes les spécificités examinées ci-dessus, la journalisation dans Kubernetes peut maintenant être représentée sous la forme d'un schéma :
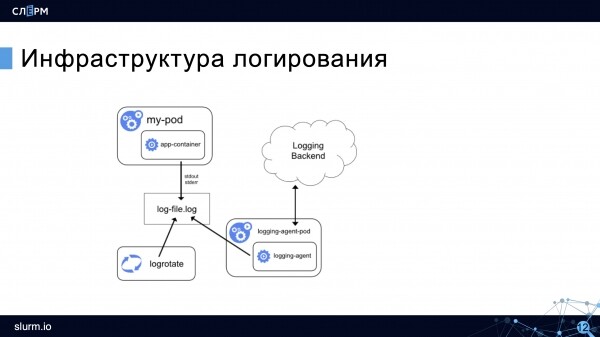
Il reste le journal du conteneur, la rotation, mais apparaît un agent collecteur qui recueille les journaux et les envoie au stockage (dans le schéma — vers le Logging Backend). L'agent fonctionne sur chaque nœud et est généralement exécuté dans Kubernetes.
Examinons maintenant les outils de journalisation.
Grafana Loki
est apparu récemment, mais il est déjà devenu assez connu. Ses avantages : installation facile, consommation minimale de ressources, pas besoin d'installer Elasticsearch, car il stocke les données dans une TSDB (base de données de séries temporelles). Dans l'article précédent, j'ai mentionné que Prometheus stocke des données dans ce type de base, et c'est l'une des nombreuses similitudes entre les deux produits. Les développeurs affirment même que Loki est le « Prometheus du monde de la journalisation ».
Une petite parenthèse sur la TSDB pour ceux qui n'ont pas lu. : La TSDB excelle dans la tâche de stockage d'un grand nombre de données, de séries temporelles, mais elle n'est pas conçue pour un stockage à long terme. Si, pour une raison quelconque, vous devez conserver les journaux plus de deux semaines, il est préférable d'organiser leur transfert vers une autre base de données.
Un autre avantage de Loki est que les données sont visualisées à l'aide de Grafana. C'est très pratique : dans Grafana, nous consultons les données de surveillance et là même, en connectant Loki, nous consultons les journaux. Des graphiques peuvent être construits à partir des journaux.
L'architecture de Loki ressemble à ceci :
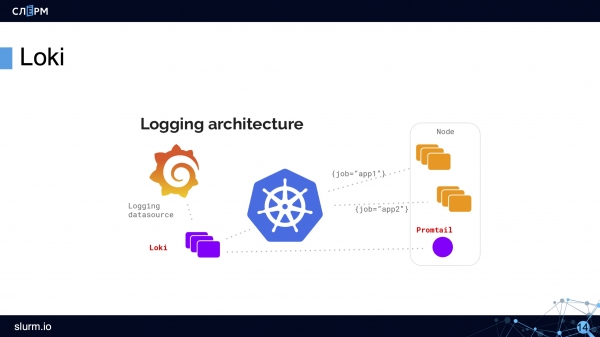
À l'aide de DaemonSet, un agent - Promtail ou Fluent Bit - est déployé sur tous les serveurs du cluster. L'agent collecte les journaux. Loki les récupère et les stocke dans la TSDB. Les journaux sont immédiatement complétés par des métadonnées, ce qui est pratique : il est possible de filtrer par Pods, namespaces, noms de conteneurs et même par labels.
Loki fonctionne dans une interface connue de Grafana. Loki a même son propre langage de requêtes, appelé LogQL - qui ressemble par son nom et sa syntaxe à PromQL dans Prometheus. L'interface de Loki propose des suggestions de requêtes, il n'est donc pas obligatoire de les connaître par cœur.
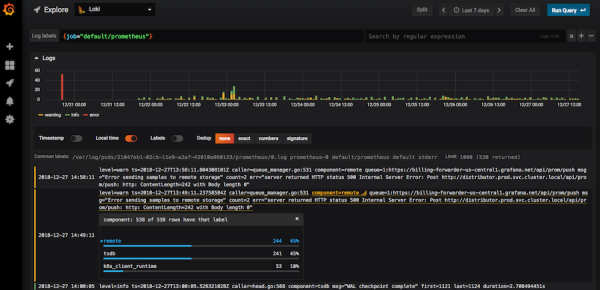
Loki dans l'interface Grafana
En utilisant des filtres, dans Loki, vous pouvez trouver des codes (« 400 », « 404 » et tout autre) ; consulter les journaux de l'ensemble du nœud ; filtrer tous les journaux contenant le mot « erreur ». Si vous cliquez sur un journal, une carte s'ouvrira avec toutes les informations sur l'événement.
Loki dispose de suffisamment d'outils pour extraire les journaux nécessaires, même si, honnêtement, techniquement, il pourrait y en avoir plus. Actuellement, Loki évolue rapidement et gagne en popularité.
Elastic + Fluent Bit + Kibana (EFK Stack)
La pile EFK est un outil de journalisation plus classique et tout aussi populaire.
Au début de l'article, nous avons mentionné l'ELK (Elasticsearch + Logstash + Kibana), mais cette pile est devenue obsolète en raison de Logstash, qui est peu performant et gourmand en ressources. À la place, on a commencé à utiliser Fluentd, plus léger et plus performant, et après un certain temps, il a été épaulé par — un agent de collecte encore plus léger et plus performant.
Selon les développeurs, Fluent Bit est plus de 100 fois meilleur en performance que Fluentd : « là où Fluentd consomme 20 Mo de RAM, Fluent Bit ne consommera que 150 Ko » — citation directe de la documentation. En tenant compte de cela, Fluent Bit a été utilisé plus fréquemment.
Fluent Bit a moins de fonctionnalités que Fluentd, mais il couvre les besoins fondamentaux, c'est donc ce que nous utilisons principalement.
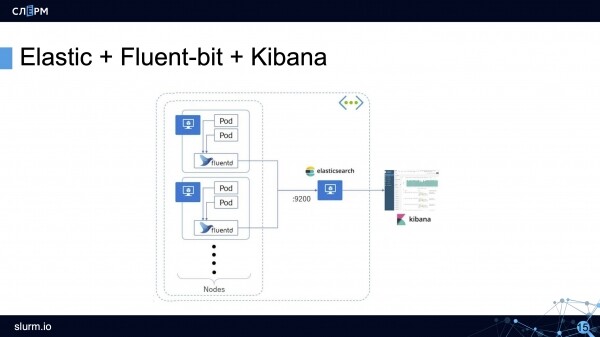
Le schéma de travail de la pile EFK : l'agent collecte les journaux de tous les pods (généralement, c'est un DaemonSet, lancé sur tous les serveurs du cluster) et les envoie à un stockage (Elasticsearch, PostgreSQL ou Kafka). Kibana se connecte au stockage et extrait toutes les informations nécessaires.
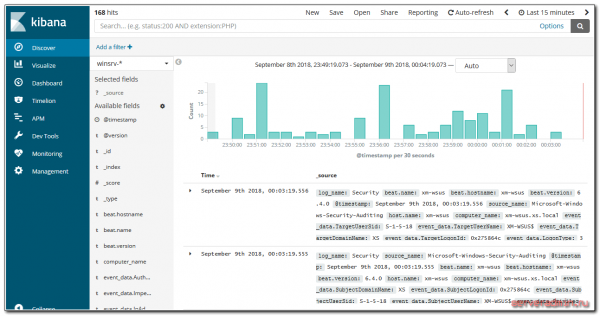
présente les informations dans une interface web conviviale. Il y a des graphiques, des filtres et bien plus encore.
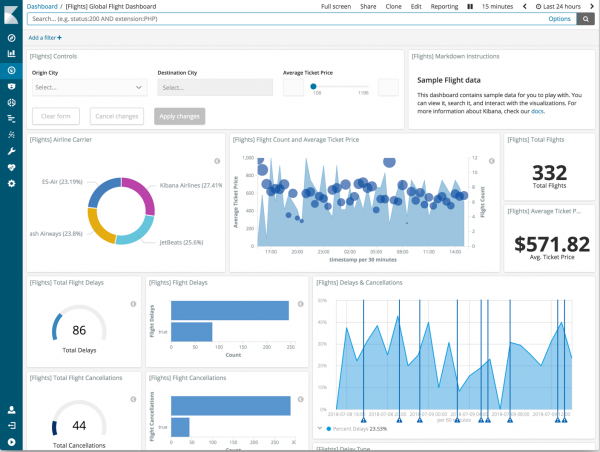
Il est possible de créer des tableaux de bord complets à partir des journaux.
Fonctionnalités de Fluent Bit
Étant donné que Fluent Bit est en général moins connu que Logstash, examinons-le un peu plus en détail. Fluent Bit peut être logiquement divisé en 6 modules, et certains modules peuvent être étendus avec des plugins qui augmentent les capacités de Fluent Bit.
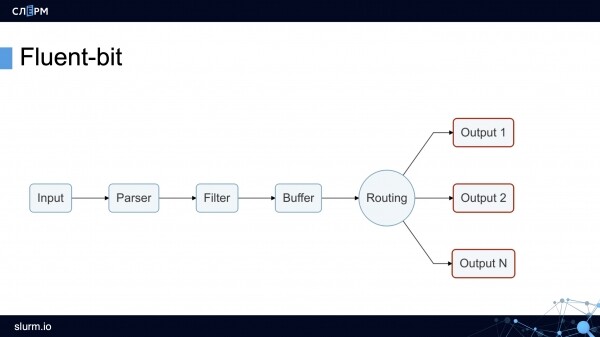
Module d'entrée collecte les journaux à partir de fichiers, de services systemd et même de tcp-socket (il suffit d'indiquer l'endpoint, et Fluent Bit commencera à s'y connecter). Ces fonctionnalités sont suffisantes pour collecter les journaux du système ainsi que des conteneurs.
En production, nous utilisons le plus souvent les plugins (il peut être dirigé vers un dossier contenant les journaux) et (il peut être configuré pour spécifier à partir de quels services collecter les journaux).
Module Parser met les journaux au format standard. Par défaut, les journaux Nginx se présentent sous forme de chaîne. Avec un plugin, cette chaîne peut être convertie en JSON : il est possible de définir des champs et leurs valeurs. Travailler avec du JSON est beaucoup plus simple qu'avec des journaux sous forme de chaîne, car cela offre des options de tri plus flexibles.
Module Filter. À ce niveau, les journaux inutiles sont filtrés. Par exemple, seuls les journaux avec la valeur "warning" ou avec certaines étiquettes sont envoyés au stockage. Les journaux sélectionnés sont mis en mémoire tampon.
Module Buffer. Fluent Bit dispose de deux types de mémoire tampon : un tampon en mémoire et un tampon sur disque. Le tampon est un espace de stockage temporaire pour les logs, utile en cas d'erreurs ou de pannes. Tout le monde souhaite économiser sur la RAM, c'est pourquoi on choisit généralement le tampon sur disque. Cependant, il faut garder à l'esprit que, avant d'être envoyés sur disque, les logs sont tout de même déchargés en mémoire.
Module Routing/Sortie contient des règles et des adresses pour l'envoi des logs. Comme mentionné précédemment, il est possible d'envoyer des logs vers Elasticsearch, PostgreSQL ou, par exemple, Kafka.
Il est intéressant de noter que les logs de Fluent Bit peuvent être envoyés à Fluentd. Étant donné que le premier est plus léger et moins fonctionnel, il peut collecter les logs et les envoyer à Fluentd, où, avec l'aide de plugins supplémentaires, ceux-ci peuvent être traités et envoyés vers des stockages.
Si vous envisagez d'utiliser Elasticsearch...
Enfin, deux conseils pour ceux qui prévoient d'utiliser Elasticsearch comme stockage de logs en production.
- Configurez des alertes avec . Ce programme extrait des messages importants du flux général des logs et envoie des alertes par email ou par d'autres canaux. Cependant, tout récemment, une .
- Faites tourner les logs à l'aide de l'application ou via l'API d'Elasticsearch. Elastic fait actuellement de grands pas vers la gestion de la durée de vie des index sans utiliser d'outils externes. En général, il n'a pas de sens de conserver les logs longtemps : il est peu probable qu'un log soit nécessaire après deux semaines — s'il est vraiment critique, il aura certainement été traité dans ce délai. En dernier recours, les anciens logs peuvent être archivés et envoyés quelque part pour un stockage à long terme. J'ai entendu parler de logs particuliers qui, selon la loi, doivent être conservés jusqu'à 5 ans. Personnellement, je ne me suis jamais retrouvé dans cette situation, mais je ne considérerais pas ce type d'information comme des logs ordinaires, et il est même possible que je les conserve séparément.
À suivre...
Auteur : Marsel Ibraev, administrateur Kubernetes certifié, ingénieur pratiquant chez , conférencier et développeur de cours .
Source : habr.com
