

Mikroservisna arhitektura, kao i sve ostalo, ima svoje prednosti i nedostatke. Neki procesi postaju jednostavniji, drugi složeniji. A kompromisi za brže promjene i bolju skalabilnost dolaze s kompromisima. Jedan od njih je povećana složenost analitike. Dok se u monolitu sva operativna analitika može svesti na SQL upite analitičkoj repliki, u multiservisnoj arhitekturi svaka usluga ima svoju bazu podataka i čini se da jedan upit nije dovoljan (ili možda jest?). Za one koje zanima kako smo riješili problem operativne analitike u našoj tvrtki i kako smo naučili živjeti s ovim rješenjem, dobrodošli.
Zovem se Pavel Sivash i u DomClicku radim u timu odgovornom za održavanje analitičkog skladišta podataka. Naš posao bi se mogao klasificirati kao podatkovno inženjerstvo, ali u stvarnosti je opseg zadataka puno širi. Pokrivamo standardno podatkovno inženjerstvo ETL/ELT, podršku i prilagodbu alata za analizu podataka te razvoj vlastitih alata. Konkretno, za operativno izvještavanje odlučili smo se "pretvarati da imamo monolit" i analitičarima dati jednu bazu podataka koja sadrži sve podatke koji su im potrebni.
Razmatrali smo razne opcije. Mogli smo izgraditi potpuno skladište - čak smo i to pokušali - ali, iskreno, nismo mogli uskladiti prilično česte promjene logike s prilično sporim procesom izgradnje i ažuriranja skladišta (ako je netko uspio, neka podijeli svoja razmišljanja u komentarima). Mogli smo reći analitičarima: "Dečki, naučite Python i radite na analitičkim replikama", ali to bi bio dodatni zahtjev za zapošljavanje i činilo se vrijednim izbjegavanja ako je moguće. Odlučili smo pokušati koristiti FDW (Foreign Data Wrapper) tehnologiju: u biti, to je standardni dblink, koji je dio SQL standarda, ali s vlastitim puno jednostavnijim sučeljem. Na temelju njega smo izgradili rješenje koje se na kraju privilo i to je ono za koje smo se odlučili. Njegovi detalji tema su zasebnog članka, a možda i više od jednog, jer toliko toga želimo pokriti: od sinkronizacije sheme baze podataka do upravljanja pristupom i anonimizacije osobnih podataka. Također je važno napomenuti da ovo rješenje nije zamjena za prave analitičke baze podataka i repozitorije; ono samo rješava određeni problem.
Na visokoj razini to izgleda ovako:
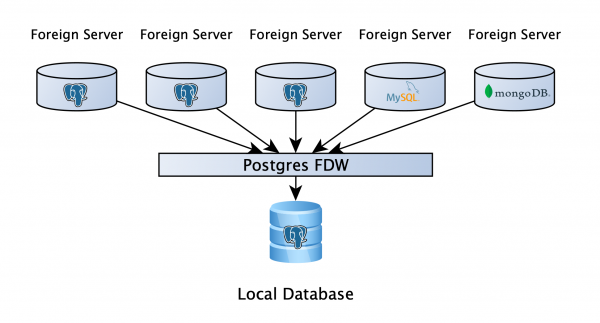
Postoji PostgreSQL baza podataka u koju korisnici mogu pohranjivati svoje radne podatke, a najvažnije je da su analitičke replike svih servisa povezane s ovom bazom podataka putem FDW-a. To vam omogućuje pisanje upita višestrukim bazama podataka, bez obzira na to što je to: PostgreSQL, MySQL, MongoDB ili bilo što drugo (datoteka, API ili, ako nema odgovarajućeg omotača, možete napisati vlastiti). Dakle, to je sve super! Idemo?
Da se sve tako brzo i lako završilo, možda ovaj članak ne bi postojao.
Važno je jasno razumjeti kako Postgres obrađuje upite prema udaljenim poslužiteljima. To se čini logičnim, ali se često zanemaruje: Postgres dijeli upit na dijelove koji se izvršavaju neovisno na udaljenim poslužiteljima, prikuplja te podatke, a zatim sam izvodi konačne izračune, tako da će brzina izvršavanja upita uvelike ovisiti o tome kako je napisan. Također vrijedi napomenuti: kada podaci stignu s udaljenog poslužitelja, više nemaju indekse, tako da nema ništa što bi pomoglo planeru, pa mu samo mi možemo pomoći i savjetovati ga. I to je upravo ono o čemu bih želio detaljnije raspravljati.
Jednostavan upit i plan s njim
Kako Postgres izvršava upit na tablici od 6 milijuna redaka na udaljenom računalu poslužitelja, pogledajmo jednostavan plan.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Korištenje VERBOSE naredbe omogućuje nam da vidimo upit koji će biti poslan udaljenom poslužitelju i čije ćemo rezultate primiti za daljnju obradu (RemoteSQL string).
Idemo malo dalje i dodajmo nekoliko filtera našem upitu: jedan po boolean polje, jedno po unosu vremenska oznaka u intervalu i jedan po jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Upravo je to točka koju treba riješiti prilikom pisanja upita. Filtri nisu proslijeđeni udaljenom poslužitelju, što znači da Postgres dohvaća svih 6 milijuna redaka za izvršavanje upita, zatim ih lokalno filtrira (redak "Filter") i agregira. Ključ uspjeha je pisanje upita tako da se filteri prosljeđuju udaljenom računalu, a mi dohvaćamo i agregiramo samo potrebne retke.
To je neka glupost
S logičkim poljima sve je jednostavno. U izvornom upitu problem je nastao zbog operatora isAko ga zamijenite s =, tada dobivamo sljedeći rezultat:
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=508010.14..508010.15 rows=1 width=8) (actual time=19064.314..19064.314 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (actual time=33.035..18951.278 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 3567989
        Remote SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Planning time: 0.834 ms
Execution time: 19064.534 ms
Kao što vidite, filter je premješten na udaljeni poslužitelj, a vrijeme izvršavanja je smanjeno s 27 na 19 sekundi.
Vrijedi napomenuti da operater is razlikuje se od operatera = koji može raditi s vrijednošću Null. To znači da nije istina ostavit će vrijednosti False i Null u filteru, dok != Točno ostavit će samo False vrijednosti. Stoga, prilikom zamjene operatora nije trebali biste proslijediti dva uvjeta filtru s operatorom OR, na primjer, GDJE (stupac != True) ILI (stupac je null).
Sada kada smo riješili logičku vrijednost, krenimo dalje. Za sada, vratimo logički filter u izvorno stanje kako bismo mogli neovisno ispitati učinak ostalih promjena.
vremenska oznakatz? hz
Općenito, često moram eksperimentirati s time kako ispravno napisati upit koji uključuje udaljene poslužitelje, a tek onda tražiti objašnjenje zašto se stvari događaju. Vrlo malo informacija o ovoj temi može se pronaći na internetu. Na primjer, u našim eksperimentima otkrili smo da filtar s fiksnim datumom savršeno funkcionira na udaljenom poslužitelju, ali kada želimo dinamički postaviti datum, na primjer, s now() ili CURRENT_DATE, to se ne događa. U našem primjeru dodali smo filtar tako da stupac created_at sadrži podatke za točno jedan mjesec u prošlosti (IZMEĐU CURRENT_DATE — INTERVAL '7 mjeseci' I CURRENT_DATE — INTERVAL '6 mjeseci'). Dakle, što smo učinili u ovom slučaju?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt <(SELECT CURRENT_DATE::timestamptz - INTERVAL '6 month')
AND meta->>'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
Zatražili smo od planera da unaprijed izračuna datum u podupitu i proslijedi unaprijed izračunatu varijablu filteru. Ovaj upit dao je izvrsne rezultate, a upit je postao gotovo šest puta brži!
Ponovno je važno biti oprezan: tip podataka u podupitu mora biti isti kao i polje po kojem filtriramo, inače će planer odlučiti da, budući da su tipovi različiti, prvo treba dohvatiti sve podatke i filtrirati ih lokalno.
Vratimo filter datuma na njegovu izvornu vrijednost.
Freddy protiv Jsonba
Općenito, logička polja i datumi već su znatno ubrzali naš upit, ali je još uvijek ostao jedan tip podataka. Bitka s filtriranjem po njemu, iskreno, još uvijek nije završena, iako je ovdje bilo nekih uspjeha. Dakle, evo kako smo uspjeli proći filter po jsonb polje na udaljeni poslužitelj.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 619961
        Remote SQL: SELECT created_dt, is_active FROM fdw_schema.table WHERE ((meta @> '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
Umjesto operatora filtriranja, potrebno je koristiti operator prisutnosti jsonb u drugom. 7 sekundi umjesto izvornih 29. Zasad je ovo jedina uspješna opcija za prijenos filtera jsonb na udaljeni poslužitelj, ali važno je imati na umu jedno ograničenje: koristimo verziju 9.6 baze podataka, ali planiramo dovršiti završna testiranja i migrirati na verziju 12 do kraja travnja. Nakon što nadogradimo, izvijestit ćemo o utjecaju, jer postoji dosta promjena koje s nestrpljenjem očekujemo: json_path, novo CTE ponašanje i pushdown (koji postoji od verzije 10). Stvarno se veselim isprobavanju.
Dokrajči ga
Testirali smo kako svaka promjena pojedinačno utječe na brzinu upita. Sada pogledajmo što se događa kada su sva tri filtra ispravno napisana.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt <(SELECT CURRENT_DATE::timestamptz - INTERVAL '6 month')
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone)) AND ((meta @> '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Da, upit izgleda složenije, što je nužan trošak, ali brzina izvršavanja je 2 sekunde, što je više od 10 puta brže! I to za jednostavan upit na relativno malom skupu podataka. U stvarnim upitima vidjeli smo povećanje performansi i do nekoliko stotina puta.
Ukratko: ako koristite PostgreSQL s FDW-om, uvijek provjerite jesu li svi filteri poslani na udaljeni poslužitelj i bit ćete zadovoljni... Barem dok ne dođete do spajanja tablica iz različitih poslužiteljiAli to je priča za neki drugi članak.
Hvala vam na pažnji! Voljela bih čuti vaša pitanja, komentare i priče o vašim iskustvima u komentarima.
Izvor: www.habr.com
