

Ova napomena će biti zanimljiva onima koji koriste biblioteku za obradu tabelarnih podataka za R — data.table, i možda će biti zadovoljni vidjevši fleksibilnost njene primene na raznim primerima.
Inspirisani dobrim primerom , i nadajući se da ste već pročitali njegov članak, predlažem da se dublje pozabavimo optimizacijom koda i performansama baziranim na data.table.
Uvod: odakle dolazi data.table?
Najbolje je započeti upoznavanje s bibliotekom malo šire, a to podrazumeva strukture podataka iz kojih može biti dobijen objekat data.table (dalje, DT).
Niz
Kod
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Jedna od takvih struktura je niz (?base::array). Kao i u drugim jezicima, nizovi ovde su višedimenzionalni. Međutim, zanimljivo je da, na primer, dvodimenzionalni niz počinje naslediti osobine od klase matrice (?base::matrix), a jednodimenzionalni niz, što je takođe važno, ne nasleđuje od vektora (?base::vector).
Pri tom treba imati u vidu da tip podataka koji se nalazi u nekom objektu treba proveriti funkcijom base::typeof, koja vraća unutrašnji opis tipa prema R Internals — opštem protokolu jezika koji se odnosi na prvobitni C.
Još jedna komanda za određivanje klase objekta, base::class, vraća u slučaju vektora vektorski tip (on se razlikuje nazivom od unutrašnjeg, ali takođe omogućava da se razume tip podataka).
Popis
Iz dvodimenzionalnog niza, koji je ujedno i matrica, može se preći na listu (?base::list).
Kod
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Pri tom se odjednom dešavaju nekoliko stvari:
- Smanjuje se druga dimenzija matrice, tako da dobijamo i listu i vektor.
- Lista, dakle, nasleđuje od ovih klasa. Treba imati na umu da odgovarajućem elementu liste odgovara jedna (skalara) vrednost iz ćelije matrice-niza.
Zahvaljujući tome što je lista takođe i vektor, na nju se mogu primeniti neke funkcije za vektore.
Dataframe
Iz liste, matrice ili vektora može se preći na dataframe (?base::data.frame).
Kod
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Šta je zanimljivo u njemu: dataframe nasleđuje od liste! Kolone dataframea su ćelije liste. To će biti važno kasnije kada budemo koristili funkcije primenjene na liste.
data.table
DT (?data.table::data.table) se može dobiti iz dataframea, liste, vektora ili matrice. Na primer, ovako (in place).
Kod
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Korisan je to što, kao i dataframe, DT nasleđuje osobine liste.
DT i memorija
Za razliku od svih drugih objekata u R bazi, DT se prenose po referenci. Ako je potrebno napraviti kopiju u novu memorijsku oblast, potrebna je funkcija data.table::copy ili je potrebno izvršiti odabir iz starog objekta.
Kod
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Ovim se uvod završava. DT je nastavak razvoja struktura podataka u R-u, koji se pretežno dešava putem proširenja i ubrzanja operacija nad objektima klase data.frame. Pri tome se zadržava nasleđivanje od drugih primitiva.
Nekoliko primera korišćenja svojstava data.table
Poput liste…
Iteriranje kroz redove data.frame-a ili DT-a nije najbolja ideja, jer je kod petlje na jeziku R znatno sporije C, dok je moguće prolaziti kroz kolone, kojih obično ima znatno manje. Dok prolazimo kroz kolone, imajte na umu da je svaka kolona element liste koji obično sadrži vektor. Operacije nad vektorima su dobro vektorizovane u osnovnim funkcijama jezika. Takođe se mogu koristiti operatori odabira svojstveni listama i vektorima: `[[`, `$`.
Kod
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizacija
Ako postoji potreba da se prođe kroz redove velikog DT-a, najbolje rešenje biće pisanje funkcije sa vektorizacijom. Ali ako to nije moguće, treba imati na umu da je petlja unutar DT-ova još uvek brža od petlje u R, jer se izvršava na C.
Pogledajmo na većem primeru sa 100K redova. Izvadićemo prvo slovo iz reči koje se nalaze u vektor-koloni w.
Ažurirano
Kod
library(magrittr)
library(microbenchmark)

## Veći primer ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizacija

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# drugi

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# treći

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Prvi prolaz sa iteracijom kroz redove:
Jedinična: milisekunde
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Drugi prolaz, gdje se vektorizacija vrši putem pretvaranja popisa u matricu i uzimanja elemenata na rezanju s indeksom 1 (to posljednje je zapravo vektorizacija). Ispravak: vektorizacija na razini funkcije. strsplit, koja može primati vektor kao ulaz. Ispostavlja se da je procedura pretvaranja popisa u matricu mnogo teža od same vektorizacije, ali i u tom slučaju puno brža od ne-vektorizirane verzije.
Jedinična: milisekunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Ubrzanje po medijani u 3 puta.
Trekći prolaz, gdje je promijenjena shema pretvaranja u matricu.
Jedinična: milisekunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Ubrzanje po medijani u 13 puta.
S tim treba eksperimentirati, što više — to će biti bolje.
Još jedan primjer s vektorizacijom, gdje je također tekst, ali je približen stvarnim uvjetima: različita duljina riječi, različit broj riječi. Potrebno je izvući prva 3 riječi. Ovako:
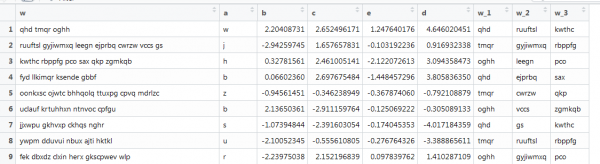
Ovdje već prethodna funkcija ne radi, jer su vektori različitih duljina, a mi smo postavili veličinu matrice. Preuredit ćemo to, pretražujući internet.
Kod
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Jedinična: milisekunde
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skripta je radila prosječnom brzinom od 1 sekunde. Nije loše.
Povezani jednom vezom…
S objektima DT može se raditi koristeći chaining. Izgleda kao dodavanje sintakse zagrada zdesna, u suštini, šećer.
Kod
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Teče kroz cijevi…
Iste operacije mogu se obaviti preko piping-a, izgleda slično, ali funkcionalno je bogatije, jer se mogu koristiti bilo koje metode, a ne samo DT. Izv bit ćemo koeficijenti logističke regresije za naše sintetičke podatke s nizom filtara na DT.
Kod
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistika, strojno učenje i slično unutar DT
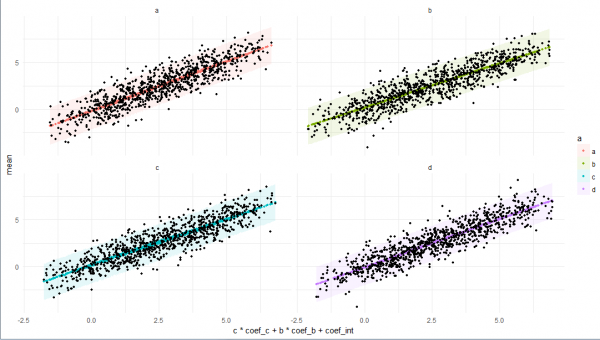
Možete koristiti lambda funkcije, ali ponekad je bolje stvoriti ih odvojeno, zapisati cijeli pipeline analize podataka, i naprijed — one rade unutar DT-a. Primjer je obogaćen svim gore navedenim značajkama, plus nekoliko korisnih stvari iz arsenala DT (kao što je pristup samom DT-u unutar DT-a putem linka, umetnutih ponekad neuzastopno, ali da bude).
Kod
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Zaključak
Nadam se da sam uspio stvoriti cjelovitu, ali naravno, ne i potpunu sliku objekta kao što je data.table, počevši od njegovih svojstava povezanih s nasljeđivanjem klasa R, pa sve do njegovih vlastitih značajki i okruženja od elemenata tidyverse. Nadam se da će vam ovo pomoći da bolje učite i primjenjujete ovu biblioteku za rad i zabavu.
Hvala!
Full code
Kod
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish
 Turkish