

Heisenberg határozatlansági elve azt állítja, hogy egy objektumnak a helyzetét és sebességét nem lehet egyszerre mérni. Ha az objektum mozgásban van, akkor nincs helyzete. Ha viszont van helyzete, akkor nincs sebessége.
A Red Hat OpenShift platformon (Kubernetes alatt) futó mikroszolgáltatások a megfelelő nyílt forráskódú szoftvernek köszönhetően egyszerre tudnak jelenteni a teljesítményükről és a hibamentességükről. Ez természetesen nem cáfolja Heisenbergot, de megszünteti a bizonytalanságot a felhőalkalmazások kezelésében. Az Istio lehetővé teszi, hogy könnyen nyomon követhessük és figyelemmel kísérhessük az ilyen alkalmazásokat, hogy minden a kontroll alatt maradjon.
Határozzuk meg a terminológiát
A nyomkövetés (Tracing) alatt a rendszeraktivitás naplózását értjük. Ez elég általánosan hangzik, de valójában az egyik alapvető szabály itt az, hogy nyomkövetési adatokat a megfelelő tárolóba kell küldeni, anélkül, hogy a formázásukkal foglalkoznánk. A keresés és az adatok elemzésének feladata a felhasználóra hárul. Az Istio a Jaeger nyomkövetési rendszert használja, amely megvalósítja az OpenTracing adatelméletet.
nyomvonalak (Traces, és itt a „nyomvonalak” kifejezést a „nyomok” értelemben használjuk, mint például a ballisztikai szakértésben) azokat az adatokat nevezzük, amelyek teljes mértékben leírják egy kérés vagy munka egységét az „elejétől a végéig”. Például mindaz, ami akkor történik, amikor a felhasználó megnyomja a gombot a weboldalon, és addig, amíg az adatok vissza nem térnek, beleértve az összes érintett mikroszolgáltatást. Azt lehet mondani, hogy egy nyomvonal teljes mértékben leírja (vagy modellezi) a kérés oda-vissza haladását. A Jaeger felületén a nyomvonalakat időrendben bontják le, ahogyan egy láncot is külön linkekre lehet szedni. Csak itt a nyomvonal nem linkekből, hanem úgynevezett span-ekből áll.
a kérést az Envoy sidecar megfogja, és létrejön egy 'gyermek' a span-ben (ezért látjuk a nyomokban), majd átirányítódik a konténerbe – ez az időtartam az egy munka egységének végrehajtásának kezdetétől a befejezéséig. Folytatva az analógiát, azt mondhatjuk, hogy minden span egy külön láncszemet képvisel. A span rendelkezhet (vagy nem rendelkezhet) egy vagy több gyermekszpan-nal. Ennek következtében a legfelső szintű span (root span) azonos időtartammal rendelkezik, mint ahhoz a nyomvonalhoz, amelyhez tartozik.
Monitorozás – ez valójában a rendszered megfigyelése, szemmel, a felhasználói felületen vagy automatizálási eszközökön keresztül. A megfigyelés alapja a nyomkövetési adatok. Az Istio megfigyelése a Prometheus eszközeivel valósul meg, és rendelkezik a megfelelő felhasználói felülettel. A Prometheus támogatja az automatikus megfigyelést figyelmeztetések és figyelmeztetési menedzserek használatával.
Megjegyzéseket fűzünk
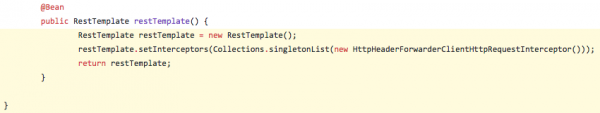
Ahhoz, hogy a nyomkövetés lehetséges legyen, az alkalmazásnak el kell készítenie a span-ok gyűjteményét. Azokat ezután exportálni kell a Jaegerbe, hogy az vizuális nyomkövetési képviselést hozhasson létre. Ezek a span-ok többek között az operáció nevét, valamint annak kezdeti és befejezési időbélyegeit jelölik. A span-ok átadása a Jaeger számára szánt HTTP-kérés fejléceinek átirányításával valósul meg a bejövő kérésekről a kimenő kérésekre. A használt programozási nyelvtől függően ez némi módosítást igényelhet az alkalmazások forráskódjában. Az alábbiakban egy Java kód példa látható (Spring Boot keretrendszer használatával), amely B3 (Zipkin-stílusú) fejléceket ad hozzá a kérésedhez a Spring konfigurációs osztályban:
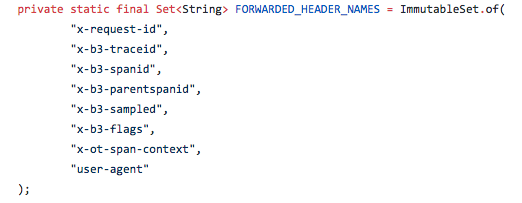
Az alábbi fejlécek beállításait használják:
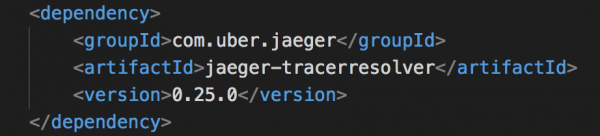
Ha Java-t használsz, akkor a kódot nem kell módosítani, csak néhány sort kell hozzáadni a POM-fájlhoz, és meg kell határozni a környezeti változókat. Íme, mit kell hozzáadni a POM.XML fájlhoz a Jaeger Tracer Resolver integrálásához:
A megfelelő környezeti változókat pedig a Dockerfile-ban kell megadni:
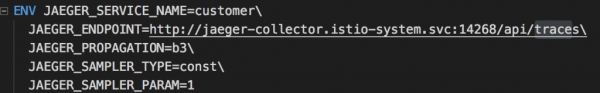
Most már minden be van állítva, és a mikroszolgáltatásaink elkezdik generálni a nyomkövetési adatokat.
Nézzük meg nagy vonalakban
Az Istio egy egyszerű irányítópultot tartalmaz, amely a Grafana alapjaira épül. Amikor minden fel van állítva és működik a Red Hat OpenShift PaaS platformján (példánk szerint a Red Hat OpenShift és a Kubernetes a minishift-en van telepítve), ezt a pultot a következő parancs futtatásával indíthatjuk:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
A Grafana pult lehetővé teszi a rendszer teljesítményének gyors értékelését. A pult egy részlete az alábbi képen látható:
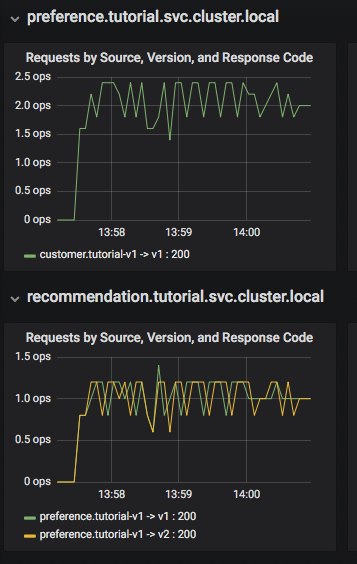
Itt látható, hogy a customer mikroszolgáltatás hívja a preference v1 mikroszolgáltatást, amely viszont a recommendation v1 és v2 mikroszolgáltatásokat hívja. A Grafana panelen található egy Dashboard Row blokk a magas szintű metrikák, például a globális kérések száma (Global Request Volume), a sikeres kérések aránya (success rates) és a 4xx hibák megjelenítésére. Ezenkívül itt van egy Server Mesh ábrázolás, amely grafikonokat mutat minden szolgáltatás számára, és egy Services Row blokk, ahol részletes információkat nézhetünk át minden konténerről, minden szolgáltatáshoz.
Most nézzünk mélyebbre
Jól konfigurált Istio nyomkövetéssel, mondhatni, dobozból kiindulva mélyebb elemzésre van lehetőség a rendszer teljesítményében. A Jaeger UI-n belül megnézhetjük a nyomvonalakat, és láthatjuk, mennyire messzire és mélyre nyúlnak, valamint vizuálisan lokalizálhatjuk a teljesítmény szűk keresztmetszeteit. A Red Hat OpenShift használatakor a minishift platformon a Jaeger UI elindításához a következő parancsot használjuk:
minishift openshift service jaeger-query --in-browser
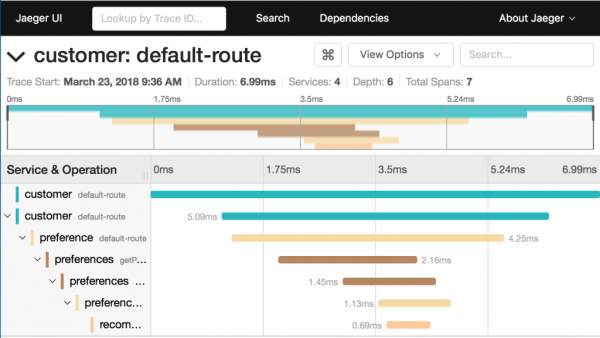
Mit mondhatunk a nyomkövetésről ezen a képernyőképen:
- Ez 7 span-ra oszlik.
- A teljes végrehajtási idő 6.99 ms.
- A recommendation mikroszolgáltatásra, amely a lánc végén található, 0.69 ms időt fordítunk.
Az ilyen típusú diagramok gyorsan segítenek megérteni a helyzetet, amikor egyetlen, nem működő szolgáltatás miatt a teljes rendszer teljesítménye szenved.
Most tegyük nehezebbé a feladatot, és indítsunk el két példányt a recommendation:v2 mikroszolgáltatásból az oc scale —replicas=2 deployment/recommendation-v2 paranccsal. Íme, milyen podjaink lesznek ezután:
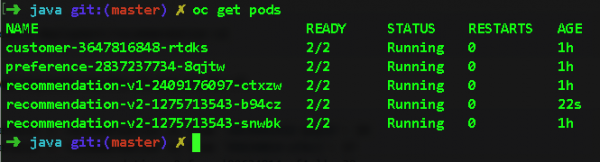
Ha most visszatérünk a Jaegerhez, és kibővítjük a recommendation szolgáltatás span-ját, láthatjuk, hogy hova irányítják a kéréseket. Ezzel egyszerűen lokalizálni tudjuk a lelassulásokat egy adott pod szinten. A node_id mezőre kell figyelnünk:
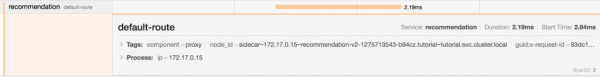
Hova és hogyan mennek el a kérések
Most lépjünk a Prometheus felületére, és teljesen várhatóan ott látjuk, hogy a kérések a recommendation második és első verziója között 2:1 arányban oszlanak meg, szigorúan a működő podok számának megfelelően. Ezen grafikon dinamikusan változni fog, amikor a podokat felfelé vagy lefelé skálázzuk, ami különösen hasznos lesz a Canary Deployment során (a következő alkalommal részletesebben megvizsgáljuk ezt a telepítési sémát).
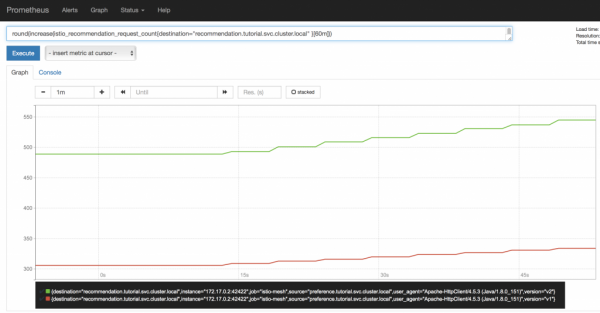
Mindez csak most kezdődik
Valójában ma csak egy kicsit érintettük a Jaeger, Grafana és Prometheus terén rejlő értékes információk tárházát. Ez volt a célunk – hogy elirányítsunk az összes szükséges helyre és bepillantást nyújtsunk az Istio lehetőségeibe.
Ne feledjétek, hogy mindez már be van építve az Istióba. Bizonyos programozási nyelvek (például Java) és keretrendszerek (például Spring Boot) használatával mindez megvalósítható úgy, hogy az alkalmazások kódját gyakorlatilag nem kell érinteni. Igen, a kódot kissé módosítani kell, ha más nyelveket használtok, elsősorban a Nodejs vagy C# esetében. De mivel a nyomon követhetőség (értsd: „tracing”) elengedhetetlen a megbízható felhőalapú rendszerek létrehozásához, úgyis módosítanotok kell a kódot, függetlenül attól, hogy van-e Istiótok vagy sem. Miért ne fektetnétek a fáradozásaitokba több értelmet?
Legalább azért, hogy 100%-os bizonyossággal mindig válaszolhassatok a „hol van?” és „milyen gyorsan?” kérdésekre.
Káosz mérnökség Istio-val: így volt tervezve
A dolgok összetörésének képessége segít abban, hogy ne törjenek el.
A szoftver tesztelése nemcsak bonyolult, hanem fontos is. Ugyanakkor a helyességi tesztelés (például hogy a függvény helyes eredményt ad-e) egy dolog, míg a megbízhatatlan hálózati körülmények között való tesztelés egy egészen más feladat (gyakran úgy gondolják, hogy a hálózat mindig problémamentesen működik, és ez a nyolc tévedés egyik legelsője a megosztott számításokról). Az egyik nehézség a probléma megoldásában az, hogy miként lehet szimulálni a rendszert érintő hibákat vagy szándékosan bevezetni azokat, a úgynevezett fault injection révén. Ezt megtehetjük az alkalmazás forráskódjának módosításával. De ekkor már nem az eredeti kódot teszteljük, hanem annak egy olyan verzióját, amely szándékosan szimulálja a hibákat. Ennek következtében kockázatot vállaltok, amely a fault injection halálos ölelésébe sodorhat, és geekes bugokkal – olyan hibákkal – találkozhattok, amelyek eltűnnek, ha megpróbáljátok őket felfedezni.
Most pedig megmutatjuk, hogyan segít az Istio megbirkózni ezekkel a nehézségekkel gyorsan és egyszerűen.
Hogyan néz ki minden, amikor minden rendben van.
Tekintsünk egy következő forgatókönyvet: van két podunk a recommendation mikroszolgáltatásunkhoz, amelyet az Istio útmutatójából vettünk. Az egyik pod a v1 címkét viseli, a másik pedig a v2-t. Mint látjuk, minden eddig tökéletesen működik:
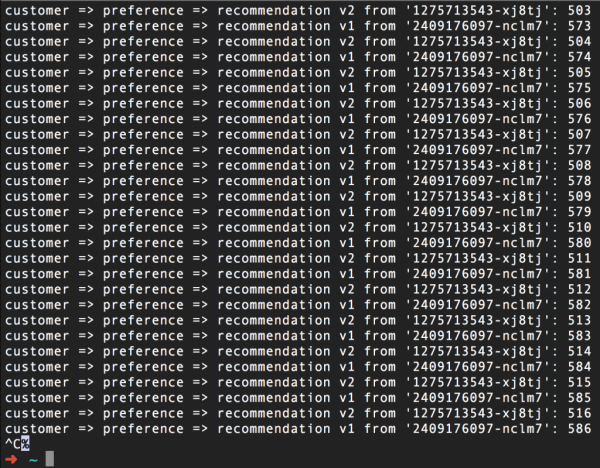
(Egyébként a jobb oldali szám csupán a hívások számlálója minden podhoz.)
De hát nekünk nem éppen ez kell, igaz? Nos, próbáljuk meg mindent tönkretenni anélkül, hogy a forráskódot megérintenénk.
Mikroszolgáltatás leállások okozása
Íme egy yaml fájl az Istio forgalomirányítási szabályhoz, amely félidőben hibát generál (hiba) a szerver 503):
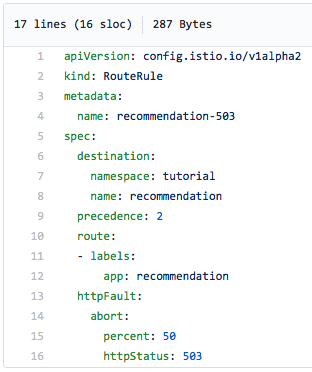
Vegye figyelembe, hogy kifejezetten megadjuk, hogy félidőben 503-as hibát kell visszaadni.
Íme, hogyan fog kinézni a curl parancs ciklusban futó képernyőképe, miután aktiváljuk ezt a szabályt, hogy hibákat szimuláljunk. Ahogy látjuk, a kérések fele 503-as hibát ad vissza, függetlenül attól, hogy melyik pod-ra – v1 vagy v2 – irányítják őket.
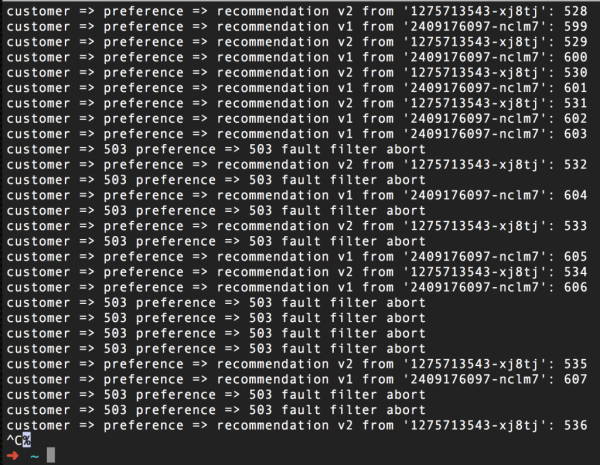
A normál működés helyreállításához elegendő eltávolítani ezt a szabályt, jelen esetben az istioctl delete routerule recommendation-503 -n tutorial parancs segítségével. Ebben az esetben a Tutorial a Red Hat OpenShift projekt neve, ahol az Istio oktatónk fut.
Mesterséges késleltetések bevezetése
A mesterséges 503-as hibák segítenek tesztelni a rendszert a hibákkal szembeni ellenállásra, de a késleltetések előrejelzésének és kezelésének képessége még lenyűgözőbb kell, hogy legyen. Valójában a késleltetések a való életben gyakrabban előfordulnak, mint a hibák. Egy lassan működő mikroszolgáltatás az a mag, amely az egész rendszert szenvedésre kényszeríti. Az Istio segítségével tesztelheti a késleltetések kezelésére vonatkozó kódot anélkül, hogy bármilyen változtatást végezne rajta. Először megmutatjuk, hogyan lehet ezt megtenni mesterségesen bevezetett hálózati késleltetések esetén.
Vegye figyelembe, hogy egy ilyen tesztelés után lehet, hogy szüksége lehet (vagy szeretné) javítani a kódját. A jó hír az, hogy ebben az esetben proaktívan fog cselekedni, nem pedig reaktívan. Így kell felépíteni a fejlesztési ciklust: kódolás-tesztelés-visszajelzés-kódolás-tesztelés…
Íme egy szabály, amely… De tudja mit? Az Istio olyan egyszerű, és ez a yaml fájl olyan érthető, hogy minden ebben a példában magáért beszél, csak nézzen rá:
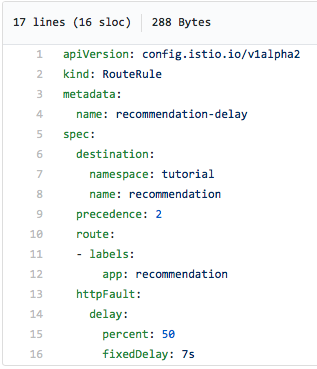
A fél esetben 7 másodperces késést tapasztalunk. Ez nem ugyanaz, mintha a forráskódba a sleep parancsot írnánk, mivel az Istio valóban 7 másodpercre késlelteti a kérést. Mivel az Istio támogatja a Jaeger nyomkövetést, ez a késés jól látható a Jaeger felhasználói felületén, amint az az alábbi képernyőfotón is látható. Figyeljük meg a hosszú kérést a diagram jobb felső sarkában - a hossza 7,02 másodperc:
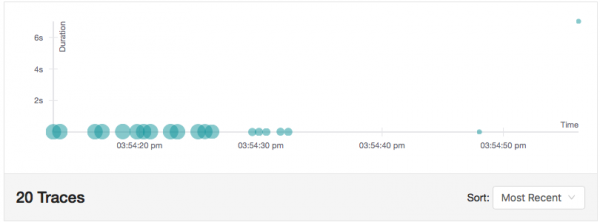
Ez a forgatókönyv lehetővé teszi a kód tesztelését hálózati késleltetési körülmények között. Nyilvánvaló, hogy ennek a szabálynak az eltávolításával megszüntetjük a mesterséges késést. Ismételjük meg, de most is mindezt anélkül tettük, hogy a forráskódot megváltoztattuk volna.
Ne hátrálj és neAdd fel
Az Istio egy másik hasznos funkciója a kaotikus mérnökséghez, hogy bizonyos számú alkalommal újrakísérletezik egy szolgáltatással. A lényeg az, hogy ne hagyjuk abba a próbálkozást, amikor az első kérés 503-as hibával végződik - és talán a N-edszer sikerülni fog. Lehet, hogy a szolgáltatás csak rövid időre nem elérhető valami okból. Igen, ezt az okot meg kell találni és megszüntetni. De ezt később, most próbáljuk meg biztosítani, hogy a rendszer továbbra is működjön.
Tehát azt szeretnénk, hogy a szolgáltatás olykor 503-as hibát adjon, és az Istio ezt követően próbálkozzon újra a kapcsolattal. Itt egyértelműen szükség van egy módra a 503-as hiba generálására anélkül, hogy a kódot megváltoztatnánk...
Várj, várj! Ezt most csináltuk.
Ez a fájl biztosítja, hogy a recommendation-v2 szolgáltatás a kérések felében 503-as hibát adjon:
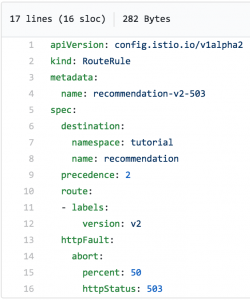
Egyértelmű, hogy a kérések egy része sikertelen lesz:
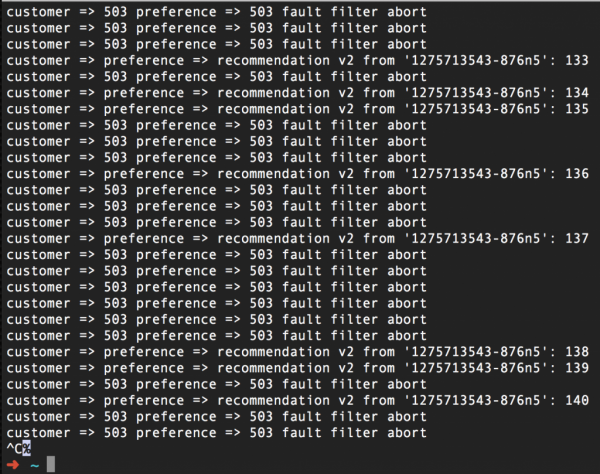
Most pedig aktiváljuk az Istio Retry funkcióját:
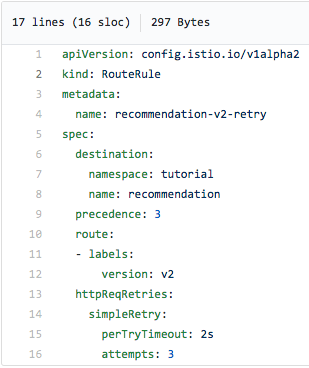
Ez a routing szabály három újrapróbálkozást végez két másodperces intervallummal, és csökkentenie kell (ideális esetben pedig teljesen el kell tüntetnie) a 503-as hibákat:
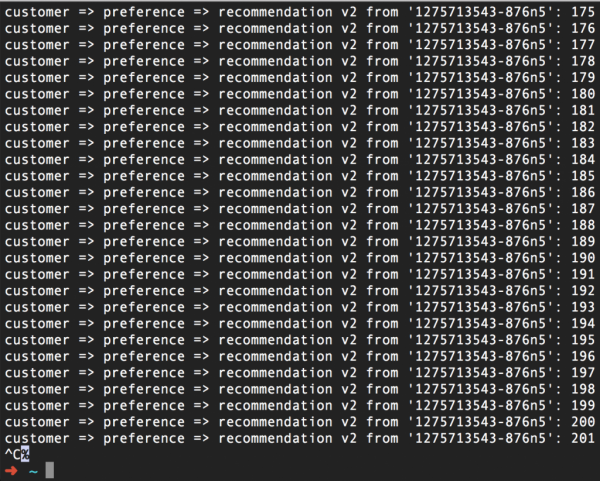
Összefoglalva: elértük, hogy az Istio, egyrészt, 503-as hibát generál a kérelmek felében. Másrészt pedig ugyanaz az Istio három alkalommal újra próbálkozik a szolgáltatáshoz való kapcsolódással a 503-as hiba előfordulása esetén. Ennek eredményeként minden nagyon jól működik. Így az Retry funkció használatával betartottuk az ígéretünket, hogy ne hátráljunk meg és ne add fel.
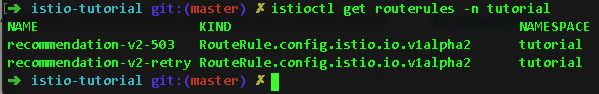
Igen, ismét sikerült ezt megtennünk, anélkül, hogy a kódot megváltoztattuk volna. Minden, amire szükségünk volt, az két Istio routing szabály:
Hogyan ne cserben hagyjuk a felhasználót, vagy miért ne várjanak heten egyet
Most már megfordítjuk a helyzetet, és megnézzük azt a forgatókönyvet, amikor nem érdemes hátrálni vagy feladni, csak egy meghatározott ideig. Ezután egyszerűen abba kell hagynunk a kérés feldolgozását, hogy ne kényszerítsük az embereket várakozni egyetlen, lassú szolgáltatás miatt. Más szavakkal, nem fogjuk megvédeni a veszített pozíciót, hanem visszalépünk egy tartalék vonalra, hogy ne terheljük meg a weboldal felhasználóját, és ne kényszerítsük a tudatlanság tüzén feszengeni.
Az Istio-ban beállíthatjuk a kérés végrehajtásának időtúllépését. Ha a szolgáltatás túllépi ezt az időtúllépést, akkor 504-es hibát (Gateway Timeout) ad vissza – ez mind az Istio konfiguráción keresztül történik. De be kell majd illesztenünk a szolgáltatás forráskódjába egy sleep parancsot (majd természetesen újra kell építenünk és redeploy-olnunk), hogy szimuláljuk a szolgáltatás lassú működését. Sajnos másképp nem megy.
Tehát, beillesztettük a három másodperces sleep parancsot a recommendation v2 szolgáltatás kódjába, újraépítettük a megfelelő képet, és redeploy-oltuk a konténert, most pedig beállítunk egy időtúllépést a következő Istio útvonalhozási szabály segítségével:
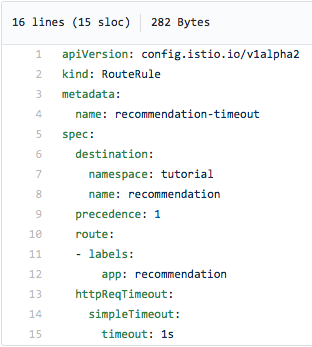
A fenti képernyőképen látható, hogy leállítjuk a kapcsolatfelvételi kísérleteket a recommendation szolgáltatással, ha egy másodpercen belül nem kapunk választ, vagyis még mielőtt 504-es hiba lépne fel. E szabály alkalmazása után (és a recommendation:v2 szolgáltatás kódjába három másodperces sleep parancs hozzáadása után) a következőt kapjuk:
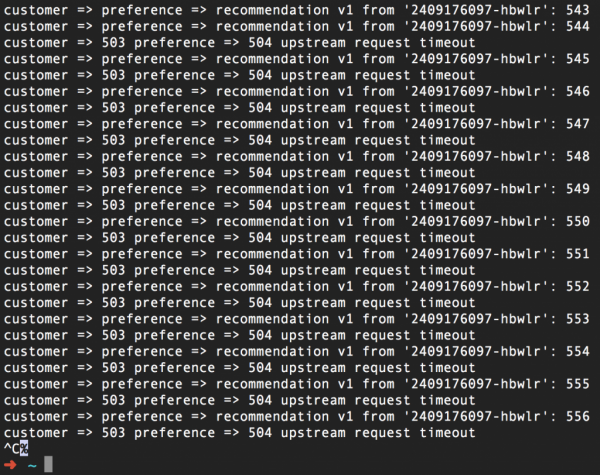
Ismételjük meg, de az időtúllépést meg lehet határozni anélkül, hogy a forráskódot módosítanánk. És a plusz bónusz itt az, hogy most módosíthatja a kódját, hogy reagáljon az időtúllépésre, és könnyen tesztelheti ezeket a fejlesztéseket az Istio segítségével.
Most pedig mindent együtt
Egy kis káosz bevezetése az Istio segítségével remek módja a kódja és a rendszer megbízhatóságának tesztelésére. A fallback, bulkhead és circuit breaker sablonok, a mesterséges hibák és késleltetések létrehozásának mechanizmusai, valamint az újrahívások és időtúllépések rendkívül hasznosak lesznek a hibamentes felhőalapú rendszerek létrehozásakor. A Kubernetes és a Red Hat OpenShift kombinációjával ezek az eszközök biztonságosan segítik a jövő megkezdését.
Forrás: habr.com
