

Ez a megjegyzés érdekes lehet azok számára, akik az R-hez készült táblázatfeldolgozó könyvtárat, a data.table-t használják, és talán örömmel látják alkalmazásának rugalmasságát különböző példákon keresztül.
Jó példa alapján inspirálódva , és remélve, hogy már elolvastátok a cikkét, javaslom, hogy mélyebben fofárkáljunk a kód optimalizálásának és teljesítményének irányába data.table.
Bevezetés: honnan származik a data.table?
A legjobban úgy érdemes megismerkedni a könyvtárral, ha egy kicsit távolabbról kezdjük, nevezetesen azokkal az adatszerkezetekkel, amelyekből a data.table (a továbbiakban DT) objektum létrejöhet.
Tömb
Kód
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Egyik ilyen struktúra a tömb (?base::array). Ahogy más nyelvekben, itt is többdimenziós tömbök vannak. Azonban érdekes, hogy például a kétdimenziós tömb elkezdi örökölni a mátrix osztály tulajdonságait (?base::matrix), míg az egydimenziós tömb, ami szintén fontos, nem örökli a vektortól (?base::vector).
Ezzel kapcsolatban fontos megérteni, hogy az adatok típusát, amelyek egy objektumban találhatók, a base::typeof) funkcióval kell ellenőrizni, amely visszaadja a típus belső leírását a R Internals – a nyelv ősprotokolával összefüggésben, C.
Még egy parancs, amely az objektum osztályának meghatározására szolgál, base::class, vektorok esetén vektortípust ad vissza (ez a név eltér a belső névtől, de szintén lehetővé teszi a típusok megértését).
Lista
A kétdimenziós tömbből, ami mátrix is, lehet listára térni (?base::list).
Kód
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Közben több dolog is történik egyszerre:
- A mátrix második dimenziója összeolvad, azaz, egyszerre kapunk listát és vektort.
- A lista, így, örökli ezeket az osztályokat. Fontos figyelembe venni, hogy a lista egyes elemei egy (skaláris) értéknek fognak megfelelni a mátrix-tömb cellájából.
Annak köszönhetően, hogy a lista ugyanúgy vektor is, bizonyos vektorra vonatkozó funkciókat is alkalmazhatunk rá.
Adatkeret
A lista, mátrix vagy vektor alapján lehet adatkeret (?base::data.frame).
Kód
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Ami benne érdekes: az adatkeret a listából öröklődik! Az adatkeret oszlopai a lista cellái. Ez fontos lesz később, amikor olyan funkciókat alkalmazunk, amelyek a listákra vonatkoznak.
data.table
A DT-t (?data.table::data.table) egy adatkeretből, listából, vektorból vagy mátrixból lehet létrehozni. Például így (in place).
Kód
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Hasznos, hogy a DT hasonlóan az adatkerethez, a lista tulajdonságait örökli.
DT és memória
A többi R base objektumtól eltérően, a DT hivatkozás szerint kerül átadásra. Ha a memóriában új másolatot akarunk készíteni, funkció szükséges data.table::copy vagy szükséges egy mintát készíteni a régi objektumból.
Kód
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Ezzel az bevezetés véget ért. A DT a R adatstruktúrák fejlődésének folytatás, amely főleg az adatokkal végzett műveletek bővítésével és felgyorsításával valósul meg, miközben megőrzi más primitívekből való öröklődést.
Néhány példa a data.table tulajdonságainak használatára
Mint lista…
A dataframe vagy DT sorain történő iterálás nem a legjobb ötlet, mivel a ciklus kódja a nyelvben R sokkal lassabb C, de oszlopon végigmenni, amelyből általában sokkal kevesebb van, teljesen lehetséges. Az oszlopokon haladva ne feledjük, hogy minden oszlop egy listaelem, amely jellemzően egy vektort tartalmaz. A vektorokkal végzett műveletek jól vektorizáltak az alapfunkciókban. Használhatóak a lista- és vektorosztályra jellemző elemekkel is: `[[`, `$`.
Kód
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizálás
Ha szükséges végigmenni egy nagy DT sorain, a legjobb megoldás egy vektorizálással rendelkező függvény írása. De ha ez nem lehetséges, akkor ne feledje, hogy a ciklus bent a DT-vel még mindig gyorsabb, mint a ciklus a R, mivel a C.
próbáljuk meg egy nagyobb példával, 100K sorral. Az első betűt fogjuk kivenni a szavakból, amelyek egy vektoros oszlopban vannak w.
Frissítve
Kód
library(magrittr)
library(microbenchmark)

## Nagyobb példa ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizálás

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# második

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# harmadik

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Első futás sorok iterálásával:
Egység: milliszekundum
kifejezés minimum
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq átlag medián uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
A második futás, ahol a listából mátrix lesz alakítva, és az 1-es indexű szelet elemeit vesszük (ez valójában a vektorizálás). Korrekció: vektorizálás a funkció szintjén. strsplit, amely képes vektort fogadni bemenetként. Kiderült, hogy a lista mátrixszá alakítása sokkal nehezebb, mint maga a vektorizálás, de így is sokkal gyorsabb, mint a nem vektorizált változat.
Egység: milliszekundum
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Medián szerinti gyorsulás 3-szor.
A harmadik futás, ahol a mátrixá alakítás sémája megváltozott.
Egység: milliszekundum
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Medián szerinti gyorsulás 13-szor.
Ezzel a dologgal érdemes kísérletezni, minél többet, annál jobb lesz.
Még egy példa a vektorizálásra, ahol szintén szöveg van, de közelebb áll a valós körülményekhez: különböző szóhosszok, különböző szómennyiség. Az első 3 szót kell kinyerni. Így:
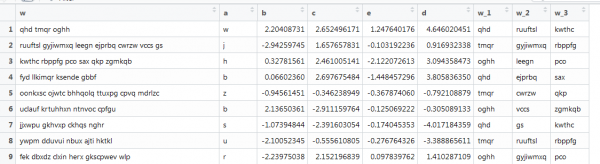
Itt a korábbi funkció már nem működik, mert a vektorok különböző hosszúságúak, míg mi a mátrix méretét határoztuk meg. Át kell alakítani, mélyebb internetes keresést igényelve.
Kód
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Egység: milliszekundum
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
A szkript átlagosan 1 másodperces sebességgel futott. Nem rossz.
Egy láncba kapcsolva…
A DT objektumokkal láncolva lehet dolgozni. Ez úgy néz ki, mint a zárójelek jobb oldalra fűzése, gyakorlatilag plusz kényelem.
Kód
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Átszalad a csöveken…
Hasonló műveletek végezhetők piping-kel, ami hasonlóan néz ki, de funkcionálisan gazdagabb, mivel bármilyen módszert használhatunk, nemcsak DT-t. Bemutatjuk a logisztikus regresszió együtthatóit a szintetikus adatainkra néhány DT szűrővel.
Kód
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statisztika, gépi tanulás és egyebek a DT-n belül
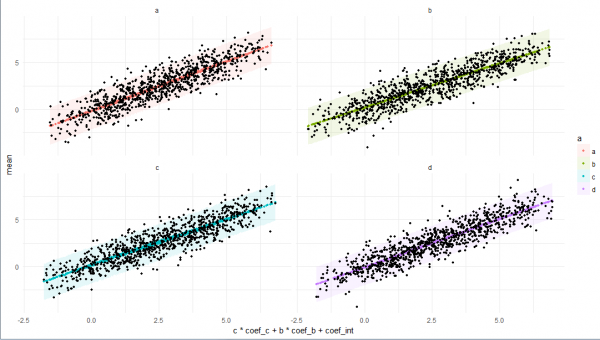
Használhatunk lambda-funkciókat, de néha jobb, ha külön létrehozzuk őket, kiírjuk az egész adatfeldolgozási folyamatot, és előre — a DT-n belül működnek. A példa minden fent említett funkcióval gazdagítva, plusz néhány hasznos dolog a DT arzenáljából (mint például saját DT-re való hivatkozás, nem mindig sorban, de hogy működjön).
Kód
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Zárás
Remélem, sikerült egy koherens, de természetesen nem teljes képet alkotnom egy olyan objektumról, mint a data.table, kezdve az R osztályoktól örökölt tulajdonságaitól egészen a saját jellemzőiig és a tidyverse elemekből álló környezetéig. Remélem, ez segít jobban megismerni és alkalmazni ezt a könyvtárat a munka és szórakozás.
Köszönöm!
Teljes kód
Kód
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Forrás: habr.com
