

אלגוריתמים מונעי נתונים כמו רשתות עצביות כבשו את העולם בסערה. הפיתוח שלהם נובע מכמה סיבות, כולל ציוד זול וחזק וכמות עצומה של נתונים. רשתות עצביות נמצאות כיום בחזית בכל הקשור למשימות "קוגניטיביות" כמו זיהוי תמונות, הבנת שפה טבעית וכו'. אבל הם לא צריכים להיות מוגבלים למשימות כאלה. מאמר זה מדבר על איך לדחוס תמונות באמצעות רשתות עצביות, באמצעות למידה שיורית. הגישה המוצגת במאמר מהירה וטובה יותר מ-codec סטנדרטיים. סכמות, משוואות וכמובן טבלה עם מבחנים מתחת לקצה.
מאמר זה מבוסס על עֲבוֹדָה. ההנחה היא שאתה מכיר רשתות עצביות והמושגים שלהן. פיתול и פונקציית הפסד.
מהי דחיסת תמונה ואיך זה עובד?
דחיסת תמונה היא תהליך של המרת תמונה כך שהיא תופסת פחות מקום. אחסון תמונות פשוט יתפוס מקום רב, וזו הסיבה שיש רכיבי קודקים כגון JPEG ו-PNG שמטרתם להקטין את גודל התמונה המקורית.
כידוע, ישנם שני סוגים של דחיסת תמונה: ללא הפסד и עם הפסדים. כפי שהשמות מרמזים, דחיסה ללא אובדן יכולה לשמור על נתוני התמונה המקוריים, בעוד שדחיסה אובדת מאבדת נתונים מסוימים במהלך הדחיסה. לדוגמה, JPG הם אלגוריתמים חסרי אובדן [בערך. תרגום - בעצם, בואו גם לא נשכח את JPEG ללא הפסדים], ו-PNG הוא אלגוריתם ללא אובדן.
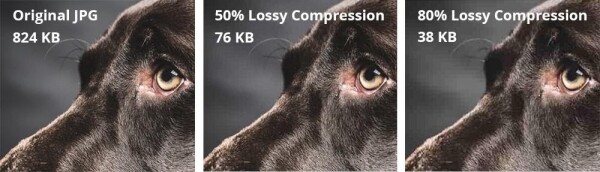
השוואה בין דחיסה חסרת אובדן ודחיסה
שימו לב שיש הרבה חפצים חסומים בתמונה מימין. זה מידע שאבד. פיקסלים שכנים בצבעים דומים נדחסים כאזור בודד כדי לחסוך במקום, אך מידע על הפיקסלים בפועל אובד. כמובן, האלגוריתמים המשמשים בקודקים JPEG, PNG וכו' הם הרבה יותר מורכבים, אבל זו דוגמה אינטואיטיבית טובה לדחיסה מאבדת. דחיסה ללא אובדן היא טובה, אך קבצים דחוסים ללא אובדן תופסים הרבה מקום בדיסק. ישנן דרכים טובות יותר לדחוס תמונות מבלי לאבד מידע רב, אך הן איטיות למדי ורבים משתמשים בגישות איטרטיביות. המשמעות היא שלא ניתן להפעיל אותם במקביל על מספר ליבות CPU או GPU. מגבלה זו הופכת אותם לבלתי מעשיים לחלוטין בשימוש יומיומי.
כניסת רשת עצבית Convolutional
אם צריך לחשב משהו והחישובים יכולים להיות משוערים, הוסף . המחברים השתמשו ברשת עצבית קונבולוציונית סטנדרטית למדי כדי לשפר את דחיסת התמונה. השיטה המוצגת לא רק מתפקדת עם הפתרונות הטובים ביותר (אם לא טובה יותר), היא יכולה גם להשתמש במחשוב מקביל, מה שמוביל לעלייה דרמטית במהירות. הסיבה היא ש-Convolutional Neural Networks (CNNs) טובות מאוד בחילוץ מידע מרחבי מתמונות, אשר מוצגות לאחר מכן בצורה קומפקטית יותר (לדוגמה, רק החלקים ה"חשובים" של התמונה נשמרים). המחברים רצו להשתמש ביכולת הזו של CNN כדי לייצג טוב יותר את התמונות.
אדריכלות
המחברים הציעו רשת כפולה. הרשת הראשונה לוקחת תמונה כקלט ומייצרת ייצוג קומפקטי (ComCNN). הפלט של רשת זו מעובד לאחר מכן על ידי codec סטנדרטי (למשל JPEG). לאחר עיבוד ה-Codec, התמונה מועברת לרשת שנייה, אשר "מתקנת" את התמונה מה-Codec בניסיון להחזיר את התמונה המקורית. המחברים קראו לרשת זו Reconstructive CNN (RecCNN). כמו GANs, שתי הרשתות מאומנות באופן איטרטיבי.
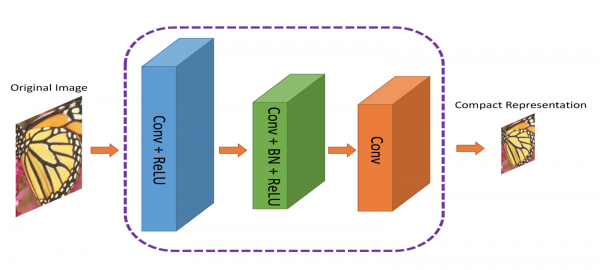
הייצוג הקומפקטי של ComCNN מועבר ל-codec סטנדרטי
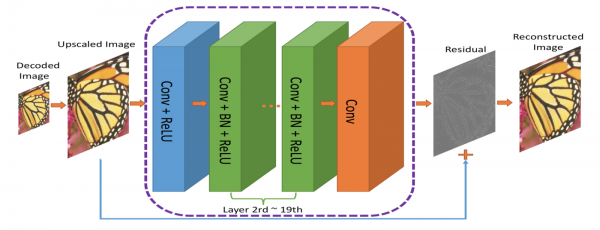
RecCNN. פלט ComCNN מוגדל ומוזן ל-RecCNN, אשר ינסה ללמוד את השאר
פלט ה-codec מוגדל ואז מועבר ל-RecCNN. RecCNN ינסה להציג את התמונה קרוב ככל האפשר למקור.
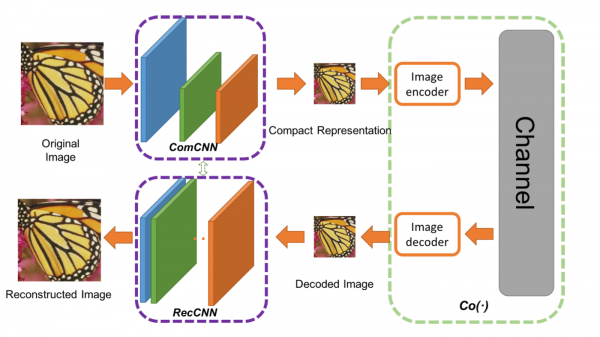
מסגרת דחיסת תמונה מקצה לקצה. Co(.) הוא אלגוריתם דחיסת תמונה. המחברים השתמשו ב-JPEG, JPEG2000 ו-BPG
מה זה שארית?
ניתן לחשוב על השאר כשלב שלאחר עיבוד כדי "לשפר" את התמונה המפוענחת על ידי ה-codec. עם הרבה "מידע" על העולם, רשת נוירונים יכולה לקבל החלטות קוגניטיביות לגבי מה לתקן. הרעיון הזה מבוסס על , קרא את הפרטים שעליהם אתה יכול .
פונקציות הפסד
שתי פונקציות האובדן משמשות כי יש לנו שתי רשתות עצביות. הראשון שבהם, ComCNN, מסומן L1 ומוגדר כדלקמן:
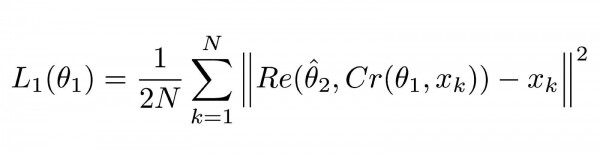
פונקציית הפסד עבור ComCNN
הסבר
המשוואה הזו אולי נראית מסובכת, אבל היא למעשה הסטנדרט (שגיאת ריבוע ממוצעת) MSE. ||² פירושו הנורמה של הווקטור שהם מקיפים.
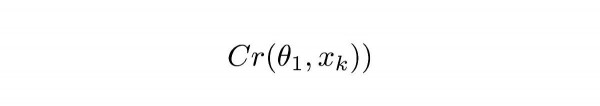
משוואה 1.1
Cr מציין את הפלט של ComCNN. θ מציין את יכולת הלמידה של פרמטרי ComCNN, XK היא תמונת הקלט
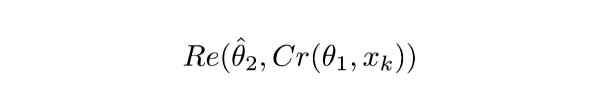
משוואה 1.2
Re() מייצג RecCNN. משוואה זו פשוט מעבירה את המשמעות של משוואה 1.1 ל- RecCNN. θ מציין את הפרמטרים הניתנים לאימון של RecCNN (כובע למעלה אומר שהפרמטרים קבועים).
הגדרה אינטואיטיבית
משוואה 1.0 תגרום ל-ComCNN לשנות את משקלה כך שכאשר היא נוצרת מחדש עם RecCNN, התמונה הסופית תיראה דומה ככל האפשר לתמונת הקלט. פונקציית האובדן השנייה של RecCNN מוגדרת באופן הבא:
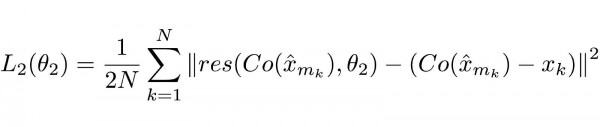
משוואה 2.0
הסבר
שוב, הפונקציה עשויה להיראות מסובכת, אבל זו לרוב פונקציית אובדן רשת עצבית רגילה (MSE).
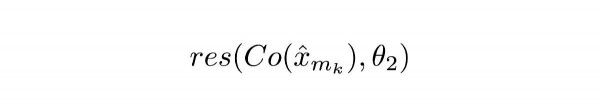
משוואה 2.1
Co() פירושו פלט codec, x עם כובע למעלה פירושו פלט ComCNN. θ2 הם פרמטרים הניתנים לאימון של RecCNN, res() הוא רק הפלט השיורי של RecCNN. ראוי לציין ש-RecCNN מאומן על ההבדל בין Co() לתמונת הקלט, אך לא על תמונת הקלט.
הגדרה אינטואיטיבית
משוואה 2.0 תגרום ל-RecCNN לשנות את המשקולות שלו כך שהפלט ייראה דומה ככל האפשר לתמונת הקלט.
תכנית הכשרה
מודלים מאומנים באופן איטרטיבי, כמו . המשקולות של הדגם הראשון קבועים בזמן שהמשקלים של הדגם השני מתעדכנים, ואז המשקולות של הדגם השני קבועות בזמן ההכשרה של הדגם הראשון.
בדיקות
המחברים השוו את השיטה שלהם לשיטות קיימות, כולל קודקים פשוטים. השיטה שלהם מתפקדת טוב יותר מאחרות תוך שמירה על מהירות גבוהה בחומרה המתאימה. בנוסף, המחברים ניסו להשתמש רק באחת משתי הרשתות וציינו ירידה בביצועים.
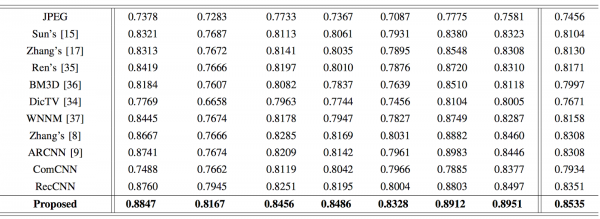
השוואת אינדקס דמיון מבניים (SSIM). ערכים גבוהים מצביעים על דמיון טוב יותר למקור. טקסט מודגש מציין את התוצאה של עבודת המחברים
מסקנה
בדקנו דרך חדשה ליישם למידה עמוקה לדחיסת תמונה, ודיברנו על האפשרות להשתמש ברשתות עצביות במשימות מעבר למשימות "כלליות" כמו סיווג תמונות ועיבוד שפה. שיטה זו לא רק שאינה נחותה מהדרישות המודרניות, אלא גם מאפשרת לך לעבד תמונות הרבה יותר מהר.
לימוד רשתות נוירונים הפך לקל יותר, כי הכנו קוד פרומו במיוחד עבור Habravchan HABR, מתן הנחה נוספת של 10% להנחה המצוינת על הבאנר.
קורסים נוספים
מאמרים מומלצים
מקור: www.habr.com
