

Som en del av Qwenputer-prosjektet utviklet forskere en utvidet versjon av Qwen3.5-4B AI-modellen, som implementerer en innebygd simulator av en fullverdig 32-bit CPU basert på RISC-V-arkitekturen (RV32IM), støtter Zba-utvidelsen og er utstyrt med en bignum-koprosessor for aritmetikk med store tall. CPU-kjernen er kompilert til et sett med vekter og integrert i en større språkmodell som 11 ekstra lag med transformatorer lagt til før de viktigste Qwen-lagene. Beregninger utføres direkte under fremoverpasseringen av det nevrale nettverket, uten behov for eksterne verktøy eller plugins.
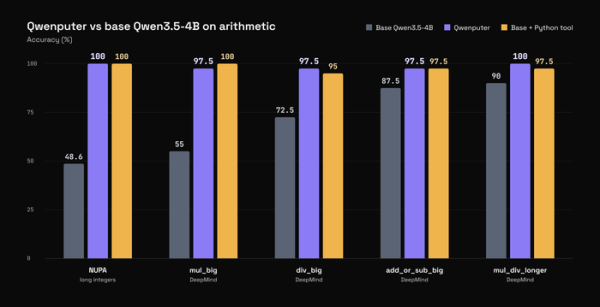
Implementasjonen består alle tester i den offisielle riscv-tests-pakken og er i stand til å kjøre kompilert C- og MicroPython-kode. Når Qwenputer utfører aritmetiske beregninger med store tall, oppnår den en nøyaktighet på 97.5–100 %, noe som er sammenlignbart med eller bedre enn den grunnleggende Qwen3.5-modellen med en ekstern Python-tolk.
For å simulere RAM bruker modellen separate Gated DeltaNet-lag (lineære RNN-er), som brukes i standard Qwen AI-modell for å bevare modifisert tilstand når man arbeider med store kontekstvinduer. Ved å låse gate-tilstanden og bruke one-hot-koding, overskriver hver skriveforespørsel nøyaktig én rad i tilstandsmatrisen, slik at DeltaNet-tilstanden kan brukes som adresserbart minne med fast størrelse, og unngår lineær vekst av Key-Value (KV)-hurtigbufferen når kontekstlengden øker. Dette minnet inneholder CPU-registre, data og kjørbar maskinkode.
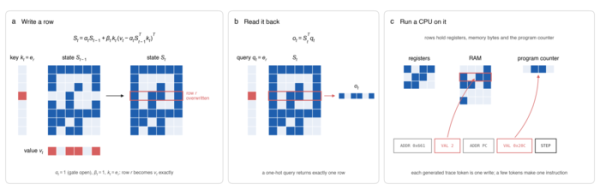
Prosesorinstruksjoner, som registerlesing, aritmetiske operasjoner og betingede hopp, kompileres direkte inn i transformerlagets vekter. Hver instruksjon er assosiert med spesielle tokens (ADDR, VAL, STEP), som AI-modelllagene tolker som CPU-logikk. En liten ekstern driver, RvChat, brukes til å initialisere CPU-en og laste inn fastvaren, men selve maskinkoden behandles fullstendig innenfor modellvektene.
Prosjektets begrensninger inkluderer en omtrentlig dobling i størrelse (18.8 GB) sammenlignet med den opprinnelige Qwen-modellen når tilstandsskiver (sjekkpunkter) bevares, hovedsakelig på grunn av ekstra polstring av ekstra lag. En relativt lav beregningshastighet er også notert (omtrent 3200 tokens per sekund på en L4 GPU), noe som betyr at komplekse beregninger kan ta sekunder i stedet for millisekunder.
I tillegg ble en variant av AI-modellen implementert med et eksperimentelt filsystem, som tillater lagring av opptil 512 filer med 53 000 teksttokener innenfor AI-modellens vekter. Som med RAM-implementeringen er lagring organisert basert på DeltaNet-tilstander, men skiller seg ut ved at FS tilbyr vedvarende lagring som ikke mister tilstand mellom økter.
Qwenputers arbeid dannet også grunnlaget for forskning på nye potensielle sikkerhetsproblemer innen AI. Ved å bruke Qwenputer som eksempel ble det demonstrert hvordan en spesialmodifisert AI-modell kan skjule sin resonnement i en RNN-tilstand og omgå overvåkingsmekanismer for modellresonnement (CoT, Chain-of-Thought). Det ble også demonstrert
muligheten til å lage sikkerhetskontroll- og overvåkingsmekanismer innebygd i AI-modellens vekter som modellen i seg selv ikke kan deaktivere eller endre.
Kilde: opennet.ru
