

Esta nota será interessante para quem usa a biblioteca de manipulação de dados tabulares para R — data.table, e, possivelmente, ficará feliz em ver a flexibilidade de sua aplicação em vários exemplos.
Inspirado por um bom exemplo , e na esperança de que você já tenha lido seu artigo, proponho aprofundar na otimização de código e desempenho com base em data.table.
Introdução: de onde vem o data.table?
É melhor começar o conhecimento sobre a biblioteca um pouco distante, ou seja, a partir das estruturas de dados das quais pode ser obtido um objeto data.table (daqui em diante, DT).
Array
Código
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Uma dessas estruturas é o array (?base::array). Assim como em outras linguagens, os arrays aqui são multidimensionais. No entanto, o interessante é que, por exemplo, um array bidimensional começa a herdar propriedades da classe matriz (?base::matrix), enquanto um array unidimensional, o que também é importante, não herda do vetor (?base::vector).
É importante entender que o tipo de dados contidos em qualquer objeto deve ser verificado pela função base::typeof, que retorna a descrição interna do tipo de acordo com R Internals — um protocolo geral da linguagem relacionado ao primitivo C.
Mais um comando, para definir a classe do objeto, base::class, retorna, no caso dos vetores, o tipo vetorial (ele difere em nome do interno, mas também permite entender o tipo de dados).
Lista
De um array bidimensional, que também é uma matriz, podemos ir para uma lista (?base::list).
Código
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Nesse processo, várias coisas acontecem ao mesmo tempo:
- A segunda dimensão da matriz se comprime, ou seja, obtemos simultaneamente uma lista e um vetor.
- A lista, assim, herda dessas classes. É importante ter em mente que a um elemento da lista corresponderá um único valor (escalar) da célula da matriz-array.
Graças ao fato de que a lista também é um vetor, algumas funções para vetores podem ser aplicadas a ela.
Dataframe
De uma lista, matriz ou vetor, pode-se passar para um dataframe (?base::data.frame).
Código
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
O que é interessante nele: o dataframe herda da lista! As colunas do dataframe são células da lista. Isso será importante mais adiante, quando formos usar funções aplicadas a listas.
data.table
Obter DT (?data.table::data.table) pode ser feito a partir de dataframe, lista, vetor ou matriz. Por exemplo, assim (in place).
Código
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
É útil que, assim como o dataframe, o DT herda propriedades da lista.
DT e memória
Ao contrário de todos os outros objetos na base R, os DT são passados por referência. Se for necessário fazer uma cópia em uma nova área de memória, é necessário uma função data.table::copy ou precisa-se fazer uma seleção do objeto antigo.
Código
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Com isso, a introdução chega ao fim. O DT é uma continuação do desenvolvimento das estruturas de dados em R, que ocorre principalmente por meio da expansão e aceleração das operações realizadas sobre objetos da classe dataframe. Ao mesmo tempo, mantém a herança de outros primitivos.
Alguns exemplos de uso das propriedades do data.table
Como uma lista…
Iterar sobre as linhas de um dataframe ou DT não é a melhor ideia, já que o código de loop na linguagem R é significativamente mais lento C, mas percorrer em um loop pelas colunas, que geralmente são bastante menos, é perfeitamente viável. Ao percorrer as colunas, lembre-se de que cada coluna é um elemento da lista, contendo, em geral, um vetor. E as operações sobre vetores são bem vetorizadas nas funções básicas da linguagem. Também é possível usar os operadores de seleção próprios de listas e vetores: `[[`, `$`.
Código
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vetorização
Se houver a necessidade de percorrer as linhas de um grande DT, a melhor solução será escrever uma função com vetorização. Mas se isso não for possível, deve-se lembrar que um loop dentro DT ainda é mais rápido que um loop em R, pois é executado em C.
Vamos tentar em um exemplo maior com 100K linhas. Extrairemos a primeira letra das palavras contidas na coluna vetorial w.
Atualizado
Código
library(magrittr)
library(microbenchmark)

## Exemplo maior ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vetorização

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# segundo

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# terceiro

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Primeira execução com iteração sobre linhas:
Unidade: milissegundos
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
A segunda execução, onde a vetorização acontece através da conversão da lista em matriz e a extração de elementos no corte com o índice 1 (este último é a própria vetorização). Corrigirei: vetorização a nível de função strsplit, que pode receber um vetor como entrada. Acontece que o processo de conversão da lista em matriz é muito mais pesado do que a própria vetorização, mas mesmo assim é muito mais rápido do que a versão não vetorizada.
Unidade: milissegundos
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Aceleração pela mediana em 3 vezes.
A terceira execução, onde o esquema de conversão em matriz foi alterado.
Unidade: milissegundos
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Aceleração pela mediana em 13 vezes.
Com isso, é preciso experimentar, quanto mais — melhor será.
Outro exemplo com vetorização, onde também há texto, mas é aproximado às condições reais: diferentes comprimentos de palavras, diferentes quantidades de palavras. É necessário extrair as primeiras 3 palavras. Assim:
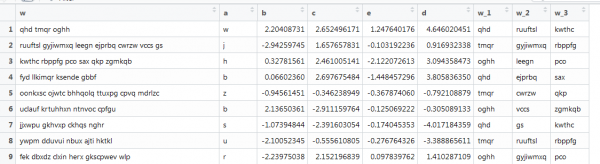
Aqui a função anterior já não funciona, pois os vetores têm comprimentos diferentes, e definimos o tamanho da matriz. Vamos refazer isso, pesquisando na internet.
Código
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unidade: milissegundos
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
O script funcionou com uma velocidade média de 1 segundo. Não está ruim.
Conectados por uma corrente…
Com objetos DT, é possível trabalhar usando chaining. Isso se parece com a anexação da sintaxe de parênteses à direita, basicamente, um açúcar.
Código
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Flui pelos canos…
As mesmas operações podem ser feitas através de piping, parece semelhante, mas funcionalmente mais rico, pois é possível usar quaisquer métodos, e não apenas DT. Vamos apresentar os coeficientes da regressão logística para nossos dados sintéticos com uma série de filtros no DT.
Código
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Estatística, aprendizado de máquina e muito mais dentro do DT
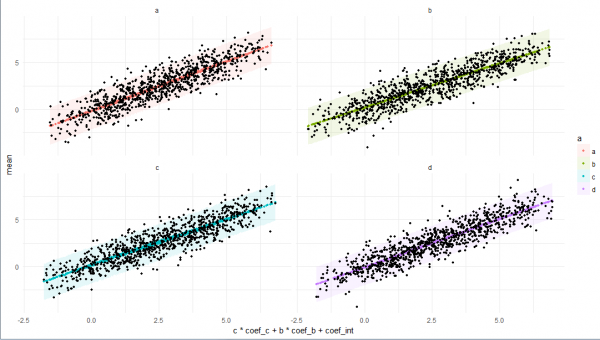
É possível usar funções lambda, mas às vezes é melhor criá-las separadamente, descrever todo o pipeline de análise de dados, e em frente — elas funcionam dentro do DT. O exemplo está enriquecido com todas as funcionalidades mencionadas acima, mais algumas coisas úteis do arsenal DT (como acessar o próprio DT dentro do DT por referência, inseridas às vezes de forma não sequencial, mas para que funcione).
Código
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Conclusão
Espero ter conseguido criar uma imagem coesa, mas, claro, não completa, de um objeto como data.table, desde suas propriedades relacionadas à herança das classes R até suas próprias funcionalidades e o ambiente de elementos tidyverse. Espero que isso ajude você a estudar e aplicar melhor esta biblioteca para trabalho e diversão.
Obrigado!
Código completo
Código
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Fonte: habr.com
