

Căutarea dependențelor funcționale în date este aplicată în diferite domenii de analiză a datelor: managementul bazelor de date, curățarea datelor, inginerie inversă a bazelor de date și explorarea datelor. Despre aceste dependențe am publicat deja Anastasia Birillo și Nikita Bobrov. De data aceasta, Anastasia — absolventă a Computer Science Center din acest an — împărtășește progresele realizate în cadrul lucrării sale de cercetare, pe care a susținut-o în centru.
Alegerea sarcinii
În timpul studiilor la CS Center, am început să studiez în profunzime bazele de date, mai precis, căutarea dependențelor funcționale și diferențiale. Această temă a fost legată de lucrarea mea de licență de la universitate, așa că, în timpul lucrului la lucrare, am început să citesc articole despre diverse dependențe în bazele de date. Am scris o revizuire a acestui domeniu — una dintre primele mele în limba engleză și am trimis-o la conferința SEIM-2017. Am fost foarte încântată când am aflat că a fost acceptată și am decis să mă aprofundez în subiect. Conceptul în sine nu este nou — a început să fie aplicat încă din anii '90, dar și acum găsește aplicații în multe domenii.
În semestrul 2 al studiilor în centru, am început un proiect de cercetare privind îmbunătățirea algoritmilor de căutare a dependențelor funcționale. Am lucrat împreună cu studentul de doctorat al SPbGU, Nikita Bobrov, la JetBrains Research.
Efortul computațional necesar pentru căutarea dependențelor funcționale
Problema principală — efortul computațional. Numărul posibilităților de dependențe minime și netriviale este limitat de valoarea  , unde
 — numărul de atribute ale tabelului. Timpul de funcționare al algoritmilor depinde nu doar de numărul de atribute, ci și de numărul de rânduri. În anii '90, algoritmii de căutare a dependențelor funcționale pe un PC de birou obișnuit puteau procesa seturi de date care conțineau până la 20 de atribute și zeci de mii de rânduri, timp de câteva ore. Algoritmii moderni, care funcționează pe procesoare multicore, descoperă dependențe pentru seturi de date care constau din sute de atribute (până la 200) și sute de mii de rânduri, aproximativ în același interval de timp. Cu toate acestea, acest timp nu este suficient: este inacceptabil pentru majoritatea aplicațiilor reale. Prin urmare, am dezvoltat abordări pentru accelerarea algoritmilor existenți.
Scheme de caching pentru intersecția partițiilor
În prima parte a lucrării, am dezvoltat scheme de caching pentru o clasă de algoritmi care utilizează metoda intersecției partițiilor. O partiție pentru un atribut reprezintă un set de liste, unde fiecare listă conține numerele de rând cu valori identice pentru acel atribut. Fiecare astfel de listă se numește cluster. Multe algoritmi moderni folosesc partiții pentru a determina dacă o dependență este menținută sau nu, urmând, în esență, lemma: Dependența  este menținută dacă
 . Aici
 se indică o partiție și se folosește noțiunea de mărimea partiției — numărul de clustere din ea. Algoritmii care folosesc partiții, în cazul unei încălcări a dependenței, adaugă atribute suplimentare în partea stângă a dependenței, după care o recalculează, efectuând operația de intersecție a partițiilor. Această operație este denumită specializare în lucrările științifice. Totuși, am observat că partițiile pentru dependențele care vor fi menținute doar după mai multe runde de specializare pot fi reutilizate activ, ceea ce poate reduce semnificativ timpul de execuție al algoritmilor, având în vedere că operația de intersecție este costisitoare.
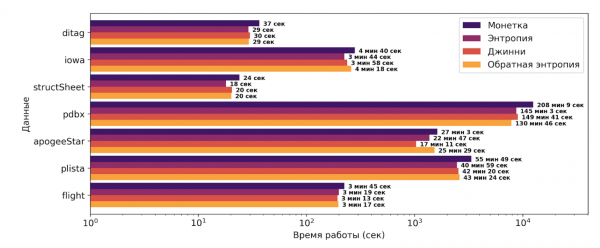
Prin urmare, am propus o euristică bazată pe Entropia Shannon și incertitudinea Gini, precum și pe metrica noastră, pe care am numit-o Entropia Inversă. Aceasta este o modificare nesemnificativă a Entropiei Shannon și crește pe măsură ce crește unicitatea setului de date. Euristica propusă este următoarea:

Aici  — gradul de unicitate al partiției recent calculate
 , iar
 este o medie a gradelor de unicitate pentru atribute specifice. Toate cele trei metrici descrise mai sus au fost testate ca metrici de unicitate. De asemenea, se poate observa că în euristică există două modificatoare. Primul indică cât de aproape este partitia curentă de cheia primară și permite o mai bună reducere a celor care sunt departe de cheia potențială. Al doilea modificator permite monitorizarea utilizării cache-ului și astfel stimulează adăugarea unui număr mai mare de partiții în cache atunci când există spațiu liber. Rezolvarea cu succes a acestei probleme a permis accelerarea algoritmului PYRO cu 10-40% în funcție de setul de date. Merită menționat că algoritmul PYRO este cel mai reușit în acest domeniu.
În figura de mai jos pot fi văzute rezultatele aplicării euristicii propuse în comparație cu abordarea de bază de caching bazată pe aruncarea unei monede. Axul X este logaritmic.
O metodă alternativă de stocare a partițiilor
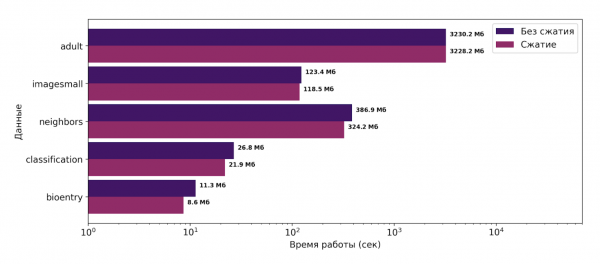
Apoi, am propus o metodă alternativă de stocare a partițiilor. Partițiile reprezintă un set de clustere, fiecare dintre care stochează numerele tuplelor cu valori identice pentru anumite atribute. Aceste clustere pot conține secvențe lungi de numere de tuple, de exemplu, dacă datele din tabel sunt ordonate. Prin urmare, am propus un schema de compresie pentru stocarea partițiilor, și anume stocarea intervalelor de valori în clusterele partițiilor:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Primul~interval}, underbrace{7, 8}_{Al~doilea~interval}, 10}}\ downarrow{Compresie}\ pi(X) = {{underbrace{$, 1, 5}_{Primul~interval}, underbrace{7, 8}_{Al~doilea~interval}, 10}}$$display$$
Această metodă a reușit să reducă consumul de memorie în timpul funcționării algoritmului TANE cu 1 până la 25%. Algoritmul TANE este un algoritm clasic pentru descoperirea dependențelor funcționale, folosește partiții în timpul funcționării sale. În cadrul practicii, s-a ales algoritmul TANE deoarece implementarea stocării pe intervale a fost semnificativ mai ușoară comparativ cu, de exemplu, PYRO, pentru a evalua dacă abordarea propusă funcționează. Rezultatele obținute sunt prezentate în figura de mai jos. Axul X este logaritmic.
Conferința ADBIS-2019
Pe baza cercetării din septembrie 2019, am prezentat un articol la conferința 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019). În timpul prezentării, Bernhard Thalheim, o persoană semnificativă în domeniul bazelor de date, a menționat lucrarea. Rezultatele cercetărilor au stat la baza dizertației mele din cadrul programului de master în matematică și mecanică la SPbGU, în cadrul căreia am implementat cele două metode propuse (caching și compresie) în ambele algoritmi: TANE și PYRO. Rezultatele au arătat că metodele propuse sunt universale, deoarece ambele algoritmi au demonstrat o reducere semnificativă a memoriei utilizate, precum și o reducere considerabilă a timpului de execuție.
Sursa: habr.com
