

Articolul este tradus în cadrul pregătirii pentru lansarea cursului
Învățarea distribuită pe mai multe instanțe de calcul performante poate reduce timpul de antrenare al rețelelor neuronale profunde moderne de la câteva săptămâni la ore sau chiar minute, făcând această tehnică de învățare predominantă în utilizarea practică a învățării profunde. Utilizatorii trebuie să înțeleagă cum să împărtășească și să sincronizeze datele pe mai multe instanțe, ceea ce, la rândul său, are un impact considerabil asupra eficienței scalării. În plus, utilizatorii trebuie să știe cum să implementeze un script de antrenament pe mai multe instanțe care funcționează pe o singură instanță.
În acest articol, vom discuta despre o metodă rapidă și simplă de învățare distribuită folosind biblioteca open source pentru învățare profundă Apache MXNet și framework-ul de învățare distribuită Horovod. Vom demonstra avantajele framework-ului Horovod în ceea ce privește performanța și vom arăta cum să scriem un script de antrenament MXNet astfel încât să funcționeze distribuit cu Horovod.
Ce este Apache MXNet
este un framework open source pentru învățare profundă, utilizat pentru crearea, antrenarea și implementarea rețelelor neuronale profunde. MXNet abstractizează complexitățile legate de implementarea rețelelor neuronale, având o performanță și scalabilitate ridicată, și oferă API-uri pentru limbaje de programare populare, cum ar fi , , , , , , și altele.
Învățarea distribuită în MXNet cu serverul de parametru
folosește abordarea serverului de parametru (parameter server). Acesta utilizează un set de servere de parametru pentru a colecta gradientele de la fiecare lucrător, a efectua agregarea și a trimite gradientele actualizate înapoi lucrătorilor pentru următoarea iterație de optimizare. Definirea raportului corect între servere și lucrători este cheia eficientizării scalării. Dacă există un singur server de parametru, acesta poate deveni un gât de sticlă în executarea calculului. În schimb, dacă se folosesc prea multe servere, conexiunea „multe-la-multe” poate aglomera toate conexiunile de rețea.
Ce este Horovod
– un cadru deschis pentru învățarea profundă distribuită, dezvoltat de Uber. Folosește tehnologii eficiente de interacțiune între mai multe GPU-uri și noduri, cum ar fi Biblioteca de Comunicații Colective NVIDIA (NCCL) și Interfața de Transmitere a Mesajelor (MPI) pentru distribuirea și agregarea parametrilor modelului între worker-uri. Optimizează utilizarea lățimii de bandă a rețelei și se scalare bine în timpul lucrului cu modele de rețele neuronale profunde. În prezent, suportă mai multe cadre populare de învățare automată, și anume , Tensorflow, Keras, și PyTorch.
Integrarea MXNet și Horovod
MXNet se integrează cu Horovod prin API-urile de învățare distribuită definite în Horovod. În Horovod, API-urile de comunicație horovod.broadcast(), horovod.allgather() și horovod.allreduce() sunt implementate folosind callback-uri asincrone ale motorului MXNet, ca parte din graficul său de sarcini. Astfel, dependențele de date între comunicație și calcule sunt gestionate cu ușurință de motorul MXNet, pentru a evita pierderile de performanță din cauza sincronizării. Obiectul optimizer distribuit, definit în Horovod, horovod.DistributedOptimizer capacitățile strămoșului său, în același timp eliminând sau atenuând deficiențele. Potrivit dezvoltatorilor, libmdbx este puțin mai rapid și semnificativ mai fiabil decât LMDB. Optimizer în MXNet astfel încât să invoce API-urile Horovod corespunzătoare pentru actualizarea distribuită a parametrilor. Toate aceste detalii de implementare sunt transparente pentru utilizatorii finali.
Pornire rapidă
Puteți începe rapid să antrenați o mică rețea neurală convoluțională pe setul de date MNIST folosind MXNet și Horovod pe MacBook-ul dvs.
Pentru a începe, instalați mxnet și horovod din PyPI:
pip install mxnet
pip install horovod
Notă: Dacă întâmpinați o eroare în timpul pip install horovod, s-ar putea să fie necesar să adăugați variabila MACOSX_DEPLOYMENT_TARGET=10.vv, unde vv – este versiunea versiunii dvs. de MacOS, de exemplu, pentru MacOSX Sierra va trebui să scrieți MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Apoi, instalați OpenMPI .
În cele din urmă, descărcați scriptul de test mxnet_mnist.py și executați următoarele comenzi în terminalul MacBook în directorul de lucru:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyAstfel, veți porni antrenamentul pe două nuclee ale procesorului dvs. Rezultatul va fi următorul:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Demonstrarea performanței
În timpul antrenării modelului ResNet50-v1 pe setul de date ImageNet pe 64 GPU-uri cu opt instanțe p3.16xlarge EC2, fiecare dintre care conține 8 GPU NVIDIA Tesla V100 pe cloud-ul AWS, am atins o lățime de bandă de antrenare de 45000 imagini/sec (adică numărul de mostre antrenate pe secundă). Antrenamentul s-a finalizat în 44 de minute după 90 de epoci, cu cea mai bună acuratețe de 75.7%.
Am comparat asta cu antrenamentul distribuit MXNet folosind un model de servere de parametru pe 8, 16, 32 și 64 GPU cu un server cu un singur parametru și o rată de servere la lucrători de 1 la 1 și respectiv 2 la 1. Rezultatul poate fi văzut în Figura 1 de mai jos. Pe axa y din stânga, coloanele reflectă numărul de imagini pentru antrenare pe secundă, iar liniile reflectă eficiența scalării (adică raportul dintre lățimea de bandă efectivă și cea ideală) pe axa y din dreapta. Așa cum puteți observa, alegerea numărului de servere influențează eficiența scalării. Dacă serverul de parametru este unul singur, eficiența scalării scade la 38% pe 64 GPU. Pentru a atinge aceeași eficiență de scalare ca și cu Horovod, este necesar să creștem numărul de servere de două ori în raport cu numărul de lucrători.
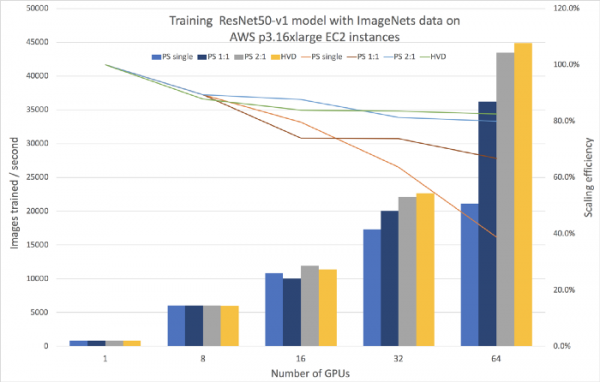
Figura 1. Compararea antrenamentului distribuit utilizând MXNet cu Horovod și cu server de parametru.
În Tabelul 1 de mai jos, am comparat costul final al instanței în timpul experimentelor pe 64 GPU. Utilizarea MXNet împreună cu Horovod asigură cea mai bună lățime de bandă la cele mai mici costuri.
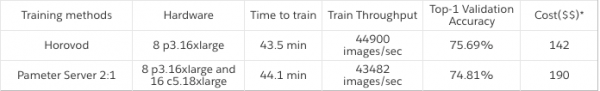
Tabelul 1. Compararea costurilor între Horovod și serverul de parametru cu o rată de servere la lucrători de 2 la 1.
Pașii pentru reproducere.
În pașii următori, vă vom arăta cum să reproduceți rezultatul antrenamentului distribuit utilizând MXNet și Horovod. Pentru a afla mai multe despre antrenamentul distribuit cu MXNet, citiți .
Pasul 1
Creați un cluster de instanțe omogene cu MXNet versiunea 1.4.0 sau mai recentă și Horovod versiunea 0.16.0 sau mai recentă pentru a utiliza antrenamentul distribuit. De asemenea, va trebui să instalați bibliotecile pentru antrenarea pe GPU. Pentru instanțele noastre, am ales Ubuntu 16.04 Linux, cu GPU Driver 396.44, CUDA 9.2, biblioteca cuDNN 7.2.1, comunicatoarele NCCL 2.2.13 și OpenMPI 3.1.1. De asemenea, puteți utiliza , unde aceste biblioteci sunt deja preinstalate.
Pasul 2
Adăugați în scriptul dvs. de antrenament MXNet capacitatea de a lucra cu API-ul Horovod. Scriptul de mai jos, bazat pe API-ul MXNet Gluon, poate fi utilizat ca un simplu șablon. Linile evidențiate cu Bold sunt necesare în cazul în care aveți deja un script de antrenament corespunzător. Iată câteva modificări critice care trebuie efectuate pentru antrenamentul cu Horovod:
- Setați contextul conform rangului local Horovod (linia 8), pentru a vă asigura că antrenamentul se desfășoară pe unitatea grafică corectă.
- Transmiteți parametrii inițiali de la un worker la toți (linia 18), pentru a vă asigura că toți workerii pornesc cu aceiași parametri inițiali.
- Creați Horovod DistributedOptimizer (linia 25), pentru a actualiza parametrii în mod distribuit.
Pentru a obține scriptul complet, consultați exemplele Horovod-MXNet și .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inițializați Horovod
5  hvd.init()
6
7  # Horovod: asociați un GPU pentru a fi utilizat cu rangul local
8  context = mx.gpu(hvd.local_rank())
9
10 # Construiește modelul
11 model = ...
12
13 # Inițializați parametrii
14 model.initialize(initializer, ctx=context)
15 params = model.collect_params()
16
17 # Horovod: transmiteți parametrii
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Creați optimizatorul
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: învăluiți optimizatorul cu DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Creați trainer-ul și funcția de pierdere
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Antrenați modelul
32 for epoch in range(num_epoch):
33    ...
Pasul 3
Conectați-vă la unul dintre workeri pentru a lansa antrenamentul distribuit folosind directivele MPI. În acest exemplu, antrenamentul distribuit este lansat pe patru instanțe cu 4 GPU în fiecare, având un total de 16 GPU în cluster. Va fi utilizat un optimizator de gradient stocastic (SGD) cu următorii hiperparametrii:
- mini-batch size: 256
- learning rate: 0.1
- momentum: 0.9
- weight decay: 0.0001
Pe măsură ce ne extindem de la un GPU la 64 GPU, am scalat liniar rata de învățare conform numărului de GPU-uri (de la 0,1 pentru 1 GPU la 6,4 pentru 64 GPU-uri), păstrând în același timp numărul de imagini pe GPU egal cu 256 (de la un lot de 256 imagini pentru 1 GPU la 16 384 pentru 64 GPU-uri). Parametrii weight decay și momentum au fost ajustați pe măsură ce creștea numărul de GPU-uri. Am folosit antrenament cu precizie mixtă cu tipul de date float16 în trecerea înainte și float32 pentru gradienti, pentru a accelera calculele float16, susținute de GPU-urile NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Concluzie
În acest articol, am analizat o abordare scalabilă pentru antrenarea distribuită a modelului folosind Apache MXNet și Horovod. Am demonstrat eficiența scalării și rentabilitatea în comparație cu abordarea care utilizează un server de parametri pe setul de date ImageNet, pe care a fost antrenat modelul ResNet50-v1. De asemenea, am detaliat pașii prin care puteți modifica un script existent pentru a rula antrenamente pe mai multe instanțe folosind Horovod.
Dacă abia începeți să lucrați cu MXNet și învățarea profundă, vizitați pagina de instalare , pentru a începe cu compilarea MXNet. De asemenea, vă recomandăm cu tărie să citiți articolul , pentru a începe lucrul.
Dacă ați lucrat deja cu MXNet și doriți să încercați antrenamentul distribuit cu Horovod, atunci consultați , compilati-l cu MXNet și urmați exemplul sau .
*costul este calculat pe baza AWS pentru instanțele EC2
Află mai multe despre curs
Sursa: habr.com
